كيف تتعلم الشبكة العصبية من بضع صور: الخبرة والمعجم ✛
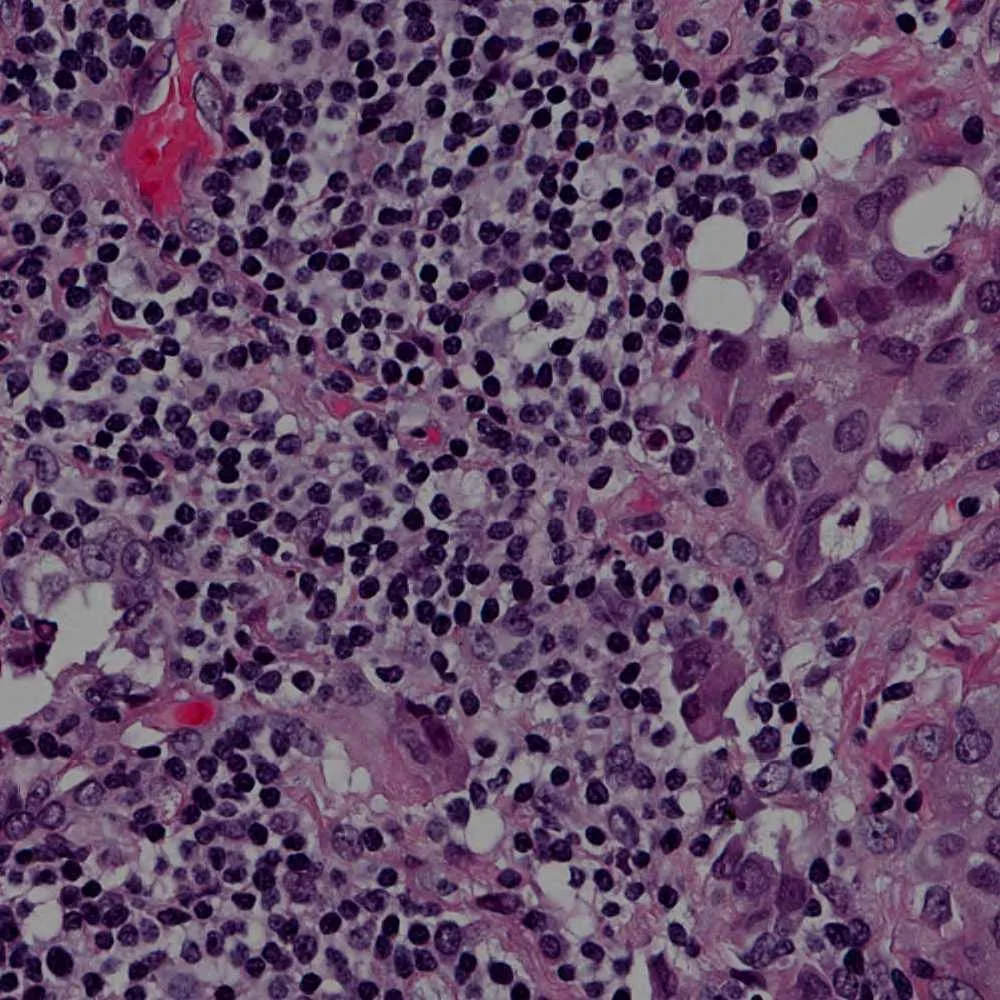
مترجم يعتمد على خبرة سنوات طويلة وعلى قاموس جيب في آن واحد، يترجم بدقة أكبر ممن يعتمد على أحدهما فقط. هكذا تعمل طريقة Exemplar لفحص الصور المجهرية. الخبرة هي الشبكة العصبية المدربة مسبقًا DINOv3، التي شاهدت ملايين الصور وتستطيع العثور على التفاصيل المهمة. أما القاموس فهو مجموعة من القواعد البسيطة التي تبرز الحواف والخطوط الرفيعة والبقع الساطعة مباشرة في الصورة. عندما نريد تحديد الخلايا أو الأوعية في مجموعة جديدة من الصور، يجمع Exemplar بين المصدرين ويتعلم من عدة أقنعة مصنفة.
في السابق، كان على عالم الأحياء أن يختار بين أمرين: إما أن يصنف مئات الصور يدويًا لبناء نموذج خاص، أو أن يحدد الأجسام يدويًا في كل مرة داخل البرنامج. أما Exemplar فيفعل شيئًا مختلفًا. فهو يأخذ شبكة عصبية مجمدة، أي أن معرفتها لا تتغير، ويضيف فوقها رأسًا صغيرًا قابلًا للتدريب. ينظر الرأس إلى الصورة بطريقتين: كاملة وعلى شكل أجزاء، لكي لا تفوته التفاصيل الكبيرة ولا الصغيرة. بالتوازي، تُحسب على الصورة 35 مرشحًا كلاسيكيًا لا تتعلم، بل تقدم تلميحات حول البنية فقط. تُدمج كل هذه الإشارات، ويُخرج الرأس خريطة تفصل فيها المقدمة عن الخلفية.
تساعد هذه الطريقة الآن في تصنيف الصور الجديدة بسرعة عندما يتوفر قناع واحد أو عدة أقنعة فقط. وهي تعمل أسرع بمقدار 16–77 مرة من تدريب نموذج آخر من الصفر. في المستقبل، يمكن جعلها أكثر ملاءمة: بحيث تعيد التدريب في ثوانٍ عند إضافة كل قناع جديد، وتقترح تلقائيًا الصورة التي ينبغي تصنيفها بعد ذلك.
بنك المرشحات الكلاسيكي، المجمد وغير القابل للتدريب في هذا العمل، كان في الأصل أداة تجزئة مستقلة في مقال سابق لنفس المؤلفين. وهو الآن يؤدي دور "معرفة مسبقة" توفر معلومات بنيوية، ويظهر تأثيره بشكل خاص على أوعية الشبكية: إذ يضيف 0.225 إلى مقياس centreline Dice.
فكرة دمج المعرفة "المجمدة" لنموذج كبير مع قواعد بسيطة قابلة للتفسير تذكرنا بالنهج المتبع في قصة تيد تشانغ "دورة حياة الكائنات البرمجية"، حيث تتعلم الكائنات الرقمية من عدد قليل من الأمثلة عبر الجمع بين الغرائز الفطرية والخبرة المكتسبة.