ماذا تخفي الخلايا الذكية: انتباه بلا فائدة سريع
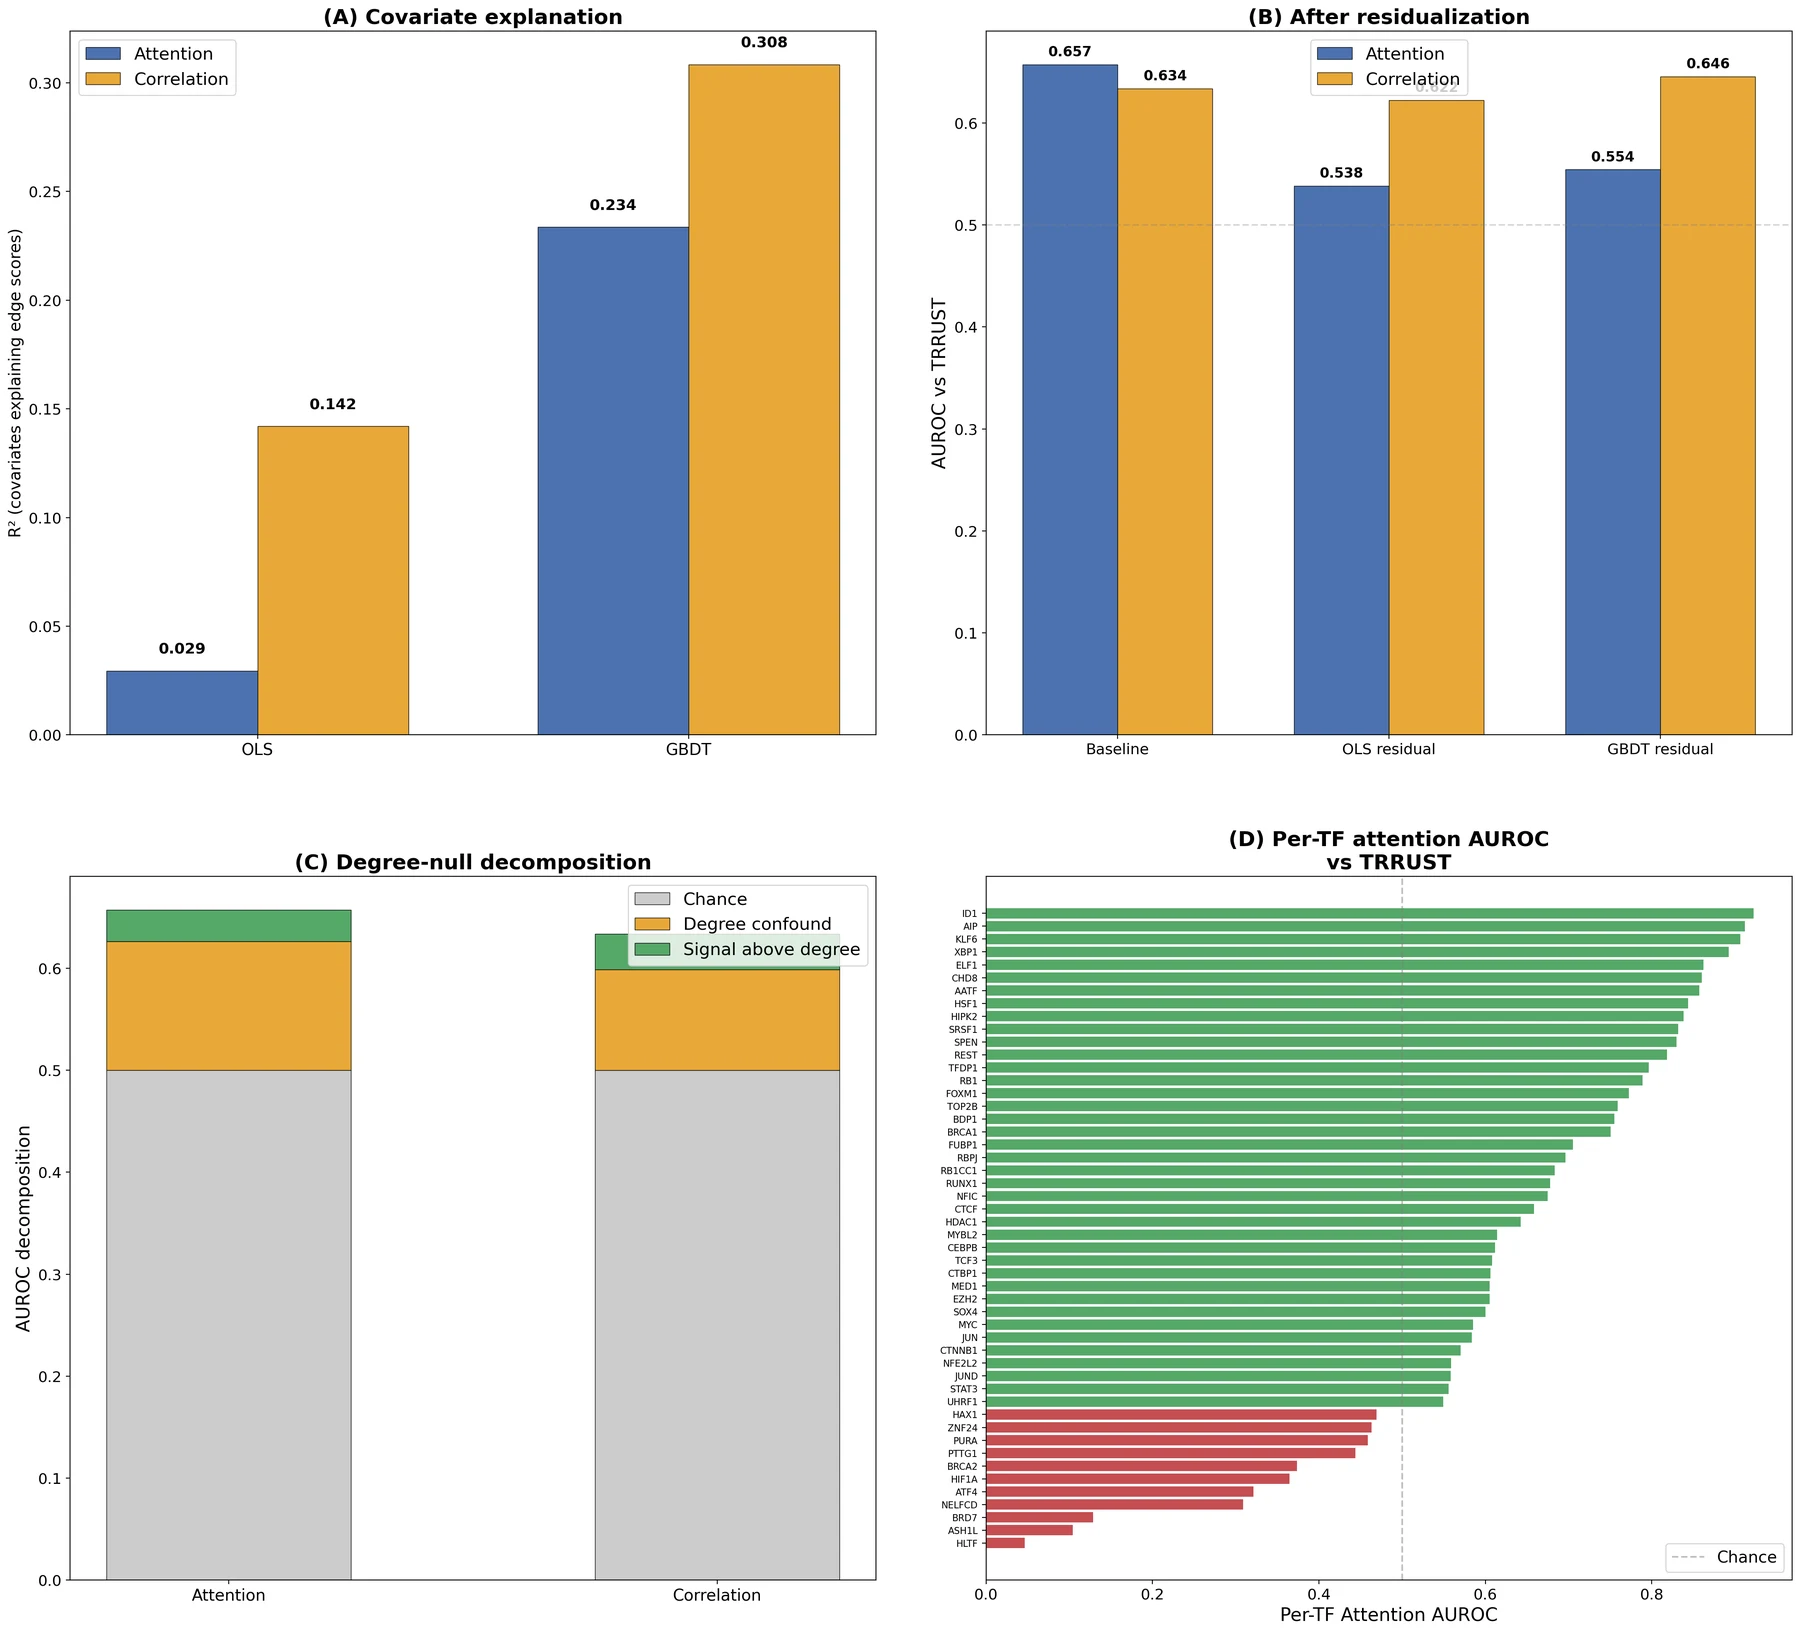
داخل الخلية يغلي العمل: آلاف الجينات تُفعَّل وتُعطَّل، مثل مصابيح على لوحة ضخمة. الشبكات العصبية التي تدرّبت على قراءة هذه اللوحة تعلّمت تخمين ما سيحدث إذا «أُطفئ» جين واحد أو أُضيف دواء. لكن كيف تفعل ذلك بالضبط؟ لغز. قرر العلماء النظر إلى الداخل والتحقق: هل «انتباه» النموذج (أي الجينات التي ينظر إليها بتركيز أكبر) يعكس الروابط الحقيقية في الخلية؟
أخذوا نموذجين معروفين — scGPT وGeneformer — ومرّروا عبرهما بيانات عن خلايا الدم وخلايا الشبكية. اتضح أن الانتباه يبني بنية فعلًا: في الطبقات المبكرة من النموذج تظهر روابط بين بروتينات تتلامس فيزيائيًا، وفي الطبقات المتأخرة تظهر روابط بين جينات تتحكم في بعضها البعض. جميل مثل مخطط مترو الأنفاق. لكن عندما استُخدمت هذه «الخرائط» للتنبؤ باستجابة الخلية لاضطراب، لم تساعد. الطريقة البسيطة التي تنظر فقط إلى الجينات التي تتغير معًا غالبًا أعطت نتيجة 0.81–0.88 على مقياس الدقة، بينما «الروابط الذكية» للانتباه أعطت 0.70 فقط. وإذا حُذفت هذه الروابط تمامًا، لا تزداد التنبؤات سوءًا.
هذا مثل مترجم في اجتماع يدوّن ملاحظات مفصلة على الهامش، لكنه يترجم أسوأ من القاموس. اقترح العلماء طريقة «إعادة تدريب» للانتباه — CSSI — تساعد النموذج على استعادة الشبكات الجينية الحقيقية بشكل أفضل (حتى 1.85 مرة أدق). لكن حتى بعد ذلك، تظل الطرق البسيطة أقوى. بالنسبة للعلم، هذا درس مهم: لا تثق بالصور الجميلة، بل تحقق من الفائدة بالرقم.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2602.17532
We present a systematic evaluation framework - thirty-seven analyses, 153 statistical tests, four cell types, two perturbation modalities - for assessing mechanistic interpretability in single-cell foundation models. Applying this framework to scGPT and Geneformer, we find that attention patterns encode structured biological information with layer-specific organisation - protein-protein interactions in early layers, transcriptional regulation in late layers - but this structure provides no incremental value for perturbation prediction: trivial gene-level baselines outperform both attention and correlation edges (AUROC 0.81-0.88 versus 0.70), pairwise edge scores add zero predictive contribution, and causal ablation of regulatory heads produces no degradation. These findings generalise from K562 to RPE1 cells; the attention-correlation relationship is context-dependent, but gene-level dominance is universal. Cell-State Stratified Interpretability (CSSI) addresses an attention-specific scaling failure, improving GRN recovery up to 1.85x. The framework establishes reusable quality-control standards for the field.
نموذج scGPT دُرِّب على بيانات 33 مليون خلية — أكثر من عدد سكان طوكيو.
في مسلسل «عالم ويست» (Westworld)، كانت لدى الروبوتات «ذكريات» جميلة لكنها لم تفهم معناها — حالة مشابهة لانتباه الشبكات العصبية.