Transformers are neural network models using self-attention mechanisms for tasks like brain mapping, language translation, and context stitching in AI agents.
المُحَوِّل (Transformer) هو معمارية للشبكات العصبية حيث تُعالج السلسلة بأكملها بالتوازي. كلمة 'عين' (بمعنى العضو الباصرة أو ينبوع الماء) تُحدد معناها من خلال علاقاتها مع الكلمات الأخرى في الجملة، باستخدام آلية الانتباه (attention mechanism) (وزن ديناميكي للأهمية). هذا مكّن من تجاوز قيود النماذج القديمة التي كانت تتوه في العبارات الطويلة. مثلما يوزع مركز العمليات المهام: كل وكيل يرى الصورة العامة ويحدد الأهداف ذات الأولوية.
التاريخ
اقتُرح في ورقة بعنوان «Attention is All You Need» (2017) لفاسواني وزملائه من جوجل. تعود الفكرة الأساسية لآلية الانتباه إلى أعمال التسعينيات، لكن المُحَوِّل هو من رسّخها ككتلة بناء قائمة بذاتها. بدأ بغزو الترجمة الآلية، ثم النماذج التوليدية (GPT، BERT)، والرؤية الحاسوبية، وحتى التنبؤ ببنية البروتينات.
كيف يعمل
العنصر الأساسي هو الانتباه الذاتي: بالنسبة للمتتالية المدخلة، تُحسب مصفوفات الاستعلامات (Q)، والمفاتيح (K)، والقيم (V). تُحصل أوزان الانتباه كجداء نقطي موسوم (scaled dot product) للاستعلامات والمفاتيح، متبوعًا بـ softmax. الصيغة: (QK^T/√d_k)V softmax = (Q,K,V) Attention، حيث d_k هو بُعد المفاتيح. يطبق المُشَفِّر الانتباه متعدد الرؤوس: عدة رؤوس متوازية تُسقط المدخلات في فضاءات جزئية مختلفة، ثم تدمج النتائج. يضيف الترميز الموضعي معلومات عن ترتيب الكلمات، لأن النموذج لا يمتلك تمثيلًا متأصلًا للتسلسل.
في التطبيق
الترجمة الآلية، والمساعدات الصوتية، والأنظمة التي تفهم النصوص الطويلة — من روبوتات الدردشة إلى التقارير الآلية.
حقيقة طريفة
قد تحتوي المُحَوِّلات الحديثة (مثل GPT) على مئات المليارات من المعلمات القابلة للتعديل — وهذا يعادل تقريبًا عدد النجوم في مجرة صغيرة.
ثلاثي جاز يعزف في شبه ظلام النادي. عازف البيانو يقود اللحن، وعازف الكونترباس يمسك الإيقاع، وعازف الطبول يوزع النقرات. إذا استمعت إلى الثنائيات فقط، قد تلتقط كيف يتكيف عازف البيانو مع الباس، أو الباس مع الطبول. لكن الأهم يولد عندما يرتجل الثلاثة معًا في الوقت نفسه: عبارة واحدة من البيانو تغير لعب الطبال، والتي بدورها تدفع عازف الباس إلى خطوة جديدة.
ملاح بخريطة ورقية يرسم المسار قبل الإبحار. إذا تغير المحيط، انزاح التيار، اشتدت الرياح، تبقى الخريطة كما هي. ستسير السفينة في طريق قديم، وسيضطر الطاقم إلى تصحيح المسار يدويًا. هكذا عمل التحكم في شكل البلازما في التوكاماك لسنوات طويلة: الخطوط الافتراضية التي تربط أخطاء الشكل بالتيارات في الملفات كانت تُحسب مسبقًا لعدة حالات مرجعية ولا تتغير أثناء التفريغ.
في جليد القارة القطبية الجنوبية، لا يترك الجسيم الشبح وراءه سوى وميض خافت من الضوء الأزرق. يلتقط كاشف IceCube هذه الوميضات، ومن خلالها يجب فهم من أين جاء الجسيم. تعلّم نموذج PolarBERT القيام بذلك، لكن ما يراه بالضبط في الداخل ظل لغزًا.
للنظر إلى الداخل، طبق الباحثون مشفِّرًا ذاتيًا متناثرًا، وهو شبكة عصبية تستخرج عددًا صغيرًا من السمات المهمة من تنشيطات النموذج.
أن تُبقي في ذهنك الموضع الدقيق لقلم يُحرَّك ببطء — مهمة عادية للدماغ. أما بالنسبة للشبكات العصبية الاصطناعية فهي شبه مستحيلة. الشبكات المتكررة العادية، مثل GRU وLSTM، تميل إلى تقسيم الحركة المستمرة إلى درجات صلبة: القلم لا يزحف بسلاسة، بل يقفز من نقطة إلى أخرى. تبدو الشبكة وكأنها لا تتذكر خطًا متصلًا، بل عدة لقطات منفصلة.
العقل البشري يشبه مجموعة بناء تُكمل نفسها بنفسها. الأفكار الجديدة لا تموت مع الإنسان؛ بل تنتقل وتختلط وتُنتقى. هذه العملية تسمى التطور الثقافي: الاختراعات المفيدة تترسخ، بينما تُنسى غير المفيدة. هكذا تعمل السقاطة (ratchet) — آلية تدور إلى الأمام فقط.
يعتمد علماء الأحياء بشكل متزايد على أجهزة الكمبيوتر لقراءة «دليل التشغيل» للخلية الحية. ستة نماذج حديثة من الذكاء الاصطناعي — Nicheformer، وCellPLM، وscGPT-spatial، وGenePT، وscELMo، وNovae — هي بمثابة ستة مترجمين من لهجات مختلفة لنفس اللغة الخلوية. كل واحد تعلم من نصوصه الخاصة: بعضها حفظ تسلسلات الجينات النشطة، والبعض الآخر درس الخرائط المكانية للأنسجة، والبعض الآخر بدأ من اللغة البشرية العادية.
تلتقط كاميرات السيارة ذاتية القيادة الضوءَ كما تفعل التلسكوبات الموجّهة نحو مجرّة بعيدة. كل لقطة هي رصد مجتزأ؛ ويجب أن تتجمع معًا لتشكل خريطة المسار.
الحاسوب، مثل عالم فلك، لا يلصق اللقطات، بل يولّد عدة مناظر علوية محتملة ويقارنها بالبيانات الفعلية. يُختار أفضل خيار وفقًا لـ الإنتروبيا — مقياس عدم اليقين الذي ينخفض عندما يتطابق الرسم مع الواقع.
دماغ المتأمل هو أوركسترا، والانتباه هو قائدها. عندما تركز على التنفس، تعزف جميع الآلات بتناغم. لكن فجأة، تعزف آلة التشيلو نغمة نشازًا — هذا هو شرود الذهن. القائد المتمرس لا يصاب بالذعر: بل يلتقط التنافر فورًا ويعيد الأوركسترا بلطف إلى اللحن الرئيسي — التنفس.
بنى العلماء نموذجًا حاسوبيًا لهذه العملية.
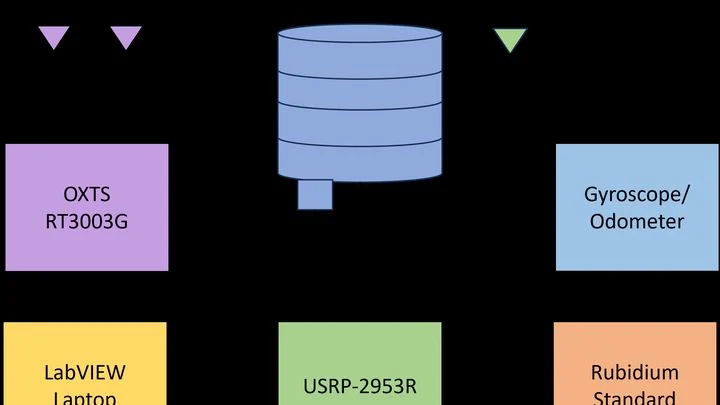
الاتصال بالقمر الصناعي أشبه بمحاولة سماع همسة في عاصفة: الإشارة تضيع في التشويش. ابتكر المهندسون خوارزمية ذكاء اصطناعي تعمل مباشرة على القمر الصناعي وباستهلاك طاقة ضئيل، وتتعرف على التشوهات بدقة أعلى من الطرق السابقة.
يشبه برنامج التتبع العادي ملاحاً يوجه سفينة بالاعتماد على النجوم. ولكن ما إن تتلبد السماء بالغيوم حتى تبدأ الإحداثيات بالانحراف، وتزداد في البيانات الإنتروبيا (مقياس اللايقين). يحصل الخوارزم الجديد على "مساعد طيار" — وحدة تراقب مدى ثقة الملاح الرئيسي.
وعندما تبدأ الحسابات بالانحراف عن الواقع، يُطلق إشارة: "لقد تغيرت مواقع النجوم، حان وقت تحديث الخريطة".
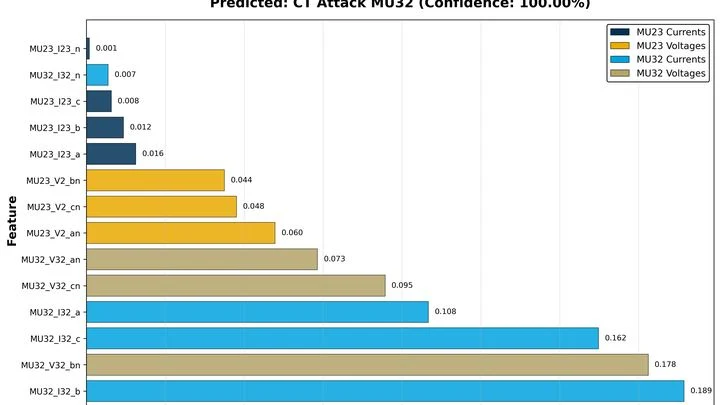
الألواح الشمسية ومولدات الرياح، على عكس التوربينات التقليدية، تُوصَل عبر عواكس (Inverters) — أجهزة تحول التيار المستمر إلى تيار متردد. وهذا يفتح نواقل جديدة للهجمات السيبرانية: إذ يمكن للمهاجمين تشويه قراءات الحساسات أو تزوير علامات GPS الخاصة بمزامنة التوقيت دون أن يُلاحَظ ذلك. ولمواجهة ذلك، جمع المهندسون بين نهجين — حارس فائق السرعة ومحقق مدقق.
في الماء الهادئ، يكون المسار واضحًا: يكفي أن تحافظ على اتجاهك نحو الهدف. لكن في التيارات الهائجة والفوضوية، حيث يتغير اتجاه التدفق وقوته باستمرار، يحتاج الروبوت إلى استراتيجية مختلفة جوهريًا. تفترض المناهج الهندسية التقليدية بناء خريطة دقيقة للتيارات، لكن في الواقع يكاد يكون من المستحيل الحصول على مثل هذه الخريطة — فالبيئة المضطربة معقدة للغاية ومتغيرة.
النهج المعياري الحالي لتعلم الذكاء الاصطناعي يشبه طفلًا محبوسًا في مكتبة: يتذكر ملايين الكتب، لكنه لا يعلم أن النار تحرق، وأن السقوط يسبب الألم. أدمغتنا، المبنية من الكربون ومواد بسيطة أخرى، تعمل بطريقة مختلفة: أولاً يستكشف الجسد العالم من خلال الحركات واللمسات والأخطاء، وعندها فقط تكتسب الكلمات معناها.
في قلب كل نجم نيوتروني تكمن سيمفونية — تشابك معقد بين الحقول الكمومية والجاذبية النسبية. منذ قرابة قرن، وصف فريتز زفيكي هذه الأجرام بأنها «نجوم-ذرات»، بينما أهدتنا جوسلين بيل بورنيل صوتها — الإيقاع الصارم للـنباضات.
بعد إلقاء حجر، تختفي الدوائر على الماء، لكن السائل يحتفظ بذبذبات مجهرية. هبّة هواء صغيرة — ويعود التموّج مجدداً. تتصرف شبكات الخلايا العصبية بطريقة مشابهة. عندما تخفت الإشارات الكهربائية، تبقى ذكراها في نقاط التلامس — المشابك العصبية. مثل الماء بعد عاصفة، تخفي هذه الآثار طاقة كامنة. أظهر العلماء: من خلال لقطة واحدة لحالة الروابط، يُمكن التنبؤ بدقة متناهية إن كانت موجة جديدة من النشاط ستنشأ.
في قدر الحساء، يكفي مقياسا حرارة لمعرفة درجة الحرارة في كل مكان — إذا عرفنا أن الحرارة تسري في دوائر من القاع. وهكذا في العلم: بقياسات قليلة، ينبغي استعادة الصورة الكاملة لحقل الحرارة.
النظام يلتقط جوهر العمليات الحرارية، بضغطها في بضعة أرقام - قواعد. كما يعرف الطبّاخ أن الحساء أشد سخونة في الوسط.
النماذج التي تحول النص إلى صوت تتقن إعادة إنتاج الأصوات المنفردة، لكنها تحتار عندما يتضمن السيناريو عدة أحداث. على سبيل المثال، وفقًا للسيناريو يأتي رنين الجرس أولاً، ثم خطوات الأقدام، ثم صوت إغلاق الباب. قد يعيد المولد ترتيب الأحداث، فيسمع المستمع خطوات الأقدام قبل رنين الجرس.
وجد الباحثون حلاً غير متوقع: بدلاً من برمجة قواعد معقدة، أخذوا شبكة عصبية 'تفهم' الصوت، وجعلوها مراقبًا صارمًا.
في البيئة الحضرية، لا تنتشر إشارة الراديو من المحطة الأساسية في خط مستقيم، بل تنعكس مرارًا وتكرارًا عن المباني — مثل كرة ترتد بين الجدران. يستقبل الهاتف ليس إشارة واحدة، بل عشرات من "أصدائها"، كل منها يصل مع تأخير بسيط. وبما أن سرعة إشارة الراديو ثابتة وتساوي سرعة الضوء (سرعة الضوء)، فإن كل ميكروثانية من التأخير تضيف حوالي 300 متر إلى المسار المقطوع.
في المطبخ بمواقد الغاز، كل شعلة تسخن بطريقتها. إذا أعاد الطاهي ترتيب القدور، قد يحترق الطعام. هكذا في الشبكة اللاسلكية: الهوائيات-الشعلات والمستخدمون-القدور يتطلّبون ترتيبًا دقيقًا. الشبكات العصبية العادية لا تميّز المواقع، معتبرةً كل الشعلات متشابهة. لذلك يصعب عليها تقدير جودة الاتصال أو ضبط الإرسال.
عوّامة في خزان ماء: متحكم مثالي، تستشعر مستوى الماء فتعيد النظام فوراً إلى التوازن دون النظر إلى الماضي. طبق المهندسون هذا المبدأ على الشبكات العصبية. أعادوا كتابة البنية المعيارية بحيث تحل معادلة توازن واحدة بدلاً من سلسلة متتالية من الحسابات. تنبثق إشارة التحكم فوراً — مثل وضعية العوّامة.
تتحول شجرة العائلة إلى كتلة متشابكة إذا أخذنا في الاعتبار الأطفال المتبنين والزيجات المتكررة. التطور غالبًا ما يشبه هذه الكتلة: على الرغم من أن النموذج القياسي — التمثيل التقليدي للتطور التباعدي، حيث تتفرع الأنواع مثل الشجرة يرسم شجرة أنساب أنيقة، إلا أن الجينات في الواقع لا تنتقل فقط بالوراثة، بل أيضًا مباشرة بين الكائنات غير المرتبطة — وهي عملية تسمى…
المجهر الإلكتروني هو أرغن ضخم: بدلاً من الأنابيب — عدسات كهرمغناطيسية، وبدلاً من الهواء — تيار من الإلكترونات المسرّعة. في السابق، كان يرسم فقط لوحات جدارية صامتة عن العالم الذري، محملاً العلماء بفك تشفير مرهق. أما الآن فقد دخل القائد إلى القاعة — التعلّم العميق، محوّلاً نشاز البكسلات إلى سيمفونية من البنى، حيث كل ذرة نغمة.
العالم الكمومي متعدد الأجسام أشبه بفرقة موسيقية ترتجل، حيث يرتجل كل إلكترون باستمرار وهو يستمع لجميع الآخرين، وتنشأ الدالة الموجية الكلية من هذا الحوار المكثف. لكن تدوين النوتات لمئات العازفين يكاد يكون مستحيلاً: التعقيد ينفجر أسيّاً، وغالباً ما تضطر الطرق التقليدية، مثل مونت كارلو التبايني، إلى العزف بنوتات مبسطة.
استخلاص إشارة من زوج واحد من الثقوب السوداء فائقة الكتلة يشبه تمييز خطوات راقص في هدير إعصار. في مكان ما من الكون، يدور هذان الوحشان في رقصة جاذبية بطيئة، يشوهان الزمكان نفسه. إن أمواج الجاذبية الخاصة بهما ليست دفقات حادة كما في LIGO، بل تنفس عميق للقياس المتري، ممتد على مدى سنوات.
تعمل الأنظمة التوصيوية، التي تحدد المنشور الذي ستراه تالياً، على الشبكات العصبية (Neural Networks) العميقة المكونة من آلاف العمليات — الغرافات (graphs) الحسابية المعقدة (مخططات من العمليات على البيانات). هذه الأنظمة عبارة عن الأنظمة الديناميكية حية ومتطورة باستمرار: أي تغيير طفيف في الهيكلية ينتشر كالشلال في جميع أنحاء الغراف.
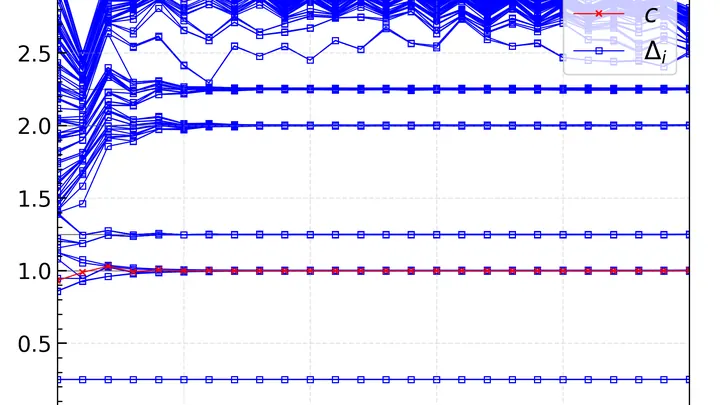
في الفيزياء الكمومية توجد نظريات يخضع فيها كل شيء لنسب واضحة — مثل إيقاع موسيقي يعود دائمًا إلى بداية المازورة. لكن توجد أيضًا نظريات «غير نسبية» ينكسر فيها الإيقاع ويصبح توقع الضربة التالية شبه مستحيل. إحداها نظرية البوزون المضغوط: يعيش الجسيم على دائرة، ويعتمد سلوكه على نصف قطر هذه الدائرة. إذا لم يُعبَّر عن نصف القطر بكسر بسيط، تصبح النظرية غير نسبية ويصبح حسابها صعبًا للغاية.
في قاعة المحكمة — سلسلة مقدَّمة كمدخل. اثنا عشر محلفًا (مسارات حسابية) يدرسونها رمزًا رمزًا. يمكن لكل منهم أن يصدر حكمًا بـ «مذنب» (يقبل) أو «غير مذنب». بالنسبة للآلة المحدودة غير القطعية (NFA) يكفي صوت واحد بـ «نعم». لكن في محكمة الفرق المتماثل (XNFA) يُصدر الحكم بناءً على الفردية: إذا كان عدد الأصوات بـ «مذنب» فرديًا — تُقبل الكلمة.
ذرة غبار صغيرة في محلول فائق التشبع تتحول خلال ثوانٍ إلى بلورة كبيرة متعددة الأوجه. وتبقى الجسيمات المجاورة غير مرئية. اكتُشفت مؤخرًا عملية مشابهة في مجتمعات الوكلاء اللغويين. فعندما مُنحت مئة نموذج حرية اختيار من تتحدث إليه، فإن تفاوتها التواصلي لم يتلاشَ، بل تصلب كما لو كان شبكة بلورية.
أعماق الكون ليست صامتة، إنها مليئة برسائل مشفرة. كل نجم، وكل نجم زائف، يرسل شيفرته الضوئية المرتعشة: إيقاعية كشيفرة مورس للنجوم القيفاوية، أو فوضوية كشيفرة مكسورة لـمستعر أعظم. يلتقط علماء الفلك هذه الإشارات بالملايين كل ليلة - ولكن كيف يُقرأ دون مفتاح؟ تنتج تلسكوبات مثل ZTF أشرطة لا نهائية من منحنيات الضوء، وهنا يظهر التعلم الآلي - ليس مجرد مستمع، بل محلل شفرات خبير.
في ساعة الذروة بمطبخ المطعم، يهسهس الزيت، وتقرع السكاكين، وتتدفق الطلبات. لا يستطيع الشيف الانتظار حتى تُغسل المقلاة — فلديه دائمًا مساعد يجهز واحدة نظيفة مسبقًا. هكذا يعمل وكلاء نماذج اللغة الكبيرة (LLM) الحديثون: يديرون الشيفرات، يخططون المهام، يتواصلون مع المستخدم، مولدين سلاسل طويلة من الرسائل.
تثقل هذه السلاسل النموذج بسرعة.
الذهب لا يستلقي على السطح — إنه مختبئ بين أطنان من الصخور الخاوية. كي يستخرج المنقبون غرامًا واحدًا من المعدن النفيس، يغربلون أمتارًا مكعبة من التربة. على هذا المنوال تقريبًا تُدرَّب نماذج اللغة الكبيرة المعاصرة: تمرر آلاف الإجابات المرشحة عبر نموذج تقييم مكلف (الأوراكل — نموذج يعطي تقييمات دقيقة)، لاختيار إجابة واحدة هي الأفضل.
الدماغ لا يتعلم كل مهمة من الصفر، بل ينقل الخبرة من نشاط إلى آخر. ولكن كيف نعرف أي المهام هي في الحقيقة مترابطة؟ ابتكر علماء الأعصاب حيلة ذكية: إعطاء شبكة اصطناعية "فرصة لمراقبة" نشاط الدماغ أثناء مهمة ما، ومحاولة التنبؤ بالنشاط أثناء مهمة أخرى. إذا نجح الأمر جيدًا، فهذا يعني أن المهام متقاربة. وإذا فشل، فإن الدماغ يستخدم آليات مختلفة تمامًا.
تشبه الخلية العصبية دارة كهربائية تحتوي على بطاريات ومقاومات متغيرة. تلعب القنوات الأيونية دور المقاومات — وهي مسام بروتينية في الغشاء تنفتح وتنغلق لتسمح بمرور الجسيمات المشحونة. يعتمد توليد النبضة العصبية على مدى سرعة هذه المسام في الاستجابة وعند أي جهد. المشكلة أن هذه «التعليمات» غير معروفة جيدًا بالنسبة للعديد من القنوات.
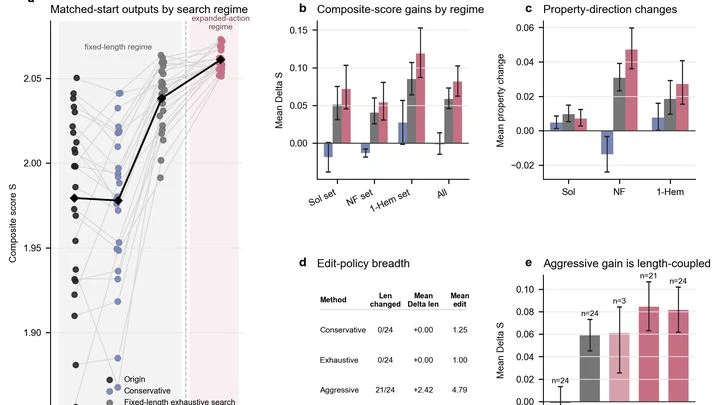
مهندس يضبط هوائيًا: يشدّ جزءًا — يتردد التردد، يغيّر الزاوية — ينخفض الكسب. هكذا تقريبًا يُدار تطوير الببتيدات العلاجية (سلاسل بروتينية قصيرة). الذوبانية، والقدرة على عدم تدمير كريات الدم الحمراء، ومقاومة التصاق الفضلات البروتينية — هذه الخصائص الثلاث متشابكة، ومحاولة تحسين واحدة غالبًا ما تكسر الأخرى.
النظام الجديد Pepti-Agent يعمل بشكل مختلف.
الشبكة العصبية، مثل ورقة مربعات، تستقبل إشارات متجانسة — فترسم بنفسها شبكة إحداثيات. في البداية، تصبح الاتصالات بين المدخلات وخلايا الشبكة أشبه بتلة منحدرة: الاستجابة أقوى في المركز وتضمحل نحو الأطراف. هكذا تولد بقعة نشاط مستقرة — نمط جماعي يدعم نفسه.
تحكي لصديقك قصة، فيبدو دماغه وكأنه يضبط على موجتك — تنشط نفس المناطق في إيقاع كلماتك. سجّل العلماء هذا "التزامن العصبي" باستخدام تخطيط الدماغ المغناطيسي (جهاز يلتقط المجالات المغناطيسية للدماغ) وقرروا اختبار ما إذا كان نموذج اللغة الحاسوبي قادرًا على تكرار هذه الرقصة من المعاني.
تخيّل مترجمًا يجلس في قاعة اجتماعات ويترجم كل كلمة. لكنه يلاحظ أنه يمكنه تحسين ترجمته إذا تعلّم من أخطائه. يبدأ بتسجيل العبارات التي سبّبت سوء الفهم، ويصححها. وبعد ساعة، تصبح ترجمته أدق، ويمر الاجتماع بسرعة أكبر. وهكذا هنا: مُفسِّر لغة Scheme، بمجرد تجميعه، يمكنه تنفيذ أي برنامج يُمرَّر إليه كبيانات، وفي الوقت نفسه حساب التدرجات لتحسين تلك البرامج.
أمين الصندوق في السوبرماركت في ساعة الذروة لا يتذكر كل عملية شراء يمررها — بل يبقي في ذهنه المبلغ الإجمالي ويراقب الطابور. بنفس الطريقة تقريبًا يوزع الدماغ قواه: القشرة الدقيقة والمكلفة (المسؤولة عن التفكير) والنوى تحت القشرية الأبسط والأكثر اقتصادية (حيث تسكن العادات) تعملان معًا. لفترة طويلة كان يُعتقد أن القشرة تبني خريطة للعالم، بينما تحت القشرة فقط تتذكر أين تكمن المكافأة.
ينظر الإنسان إلى قفل الباب فيرى شقًّا للمفتاح. يعرف أن المفتاح يُدخل ويُدار. لكن إذا كانت هناك لوحة لمسية بدلًا من ثقب المفتاح، ينكسر الإطار المألوف. لا يكتفي الإنسان بارتكاب خطأ: بل يدرك أن الطريقة المألوفة غير صالحة، ويستطيع أن يقول: «لا مكان هنا للمفتاح، نحتاج إلى نهج آخر».
هذا التوقف الصادق مع التفسير نادر في الآلات. عادةً، إما أن يخرج البرنامج إجابة عشوائية، أو يتجمد بصمت.
المدينة نظام حي: تستهلك الموارد، وتُخرج النفايات، و«جهازها الدوري» — شبكة الطرق — ينقل الناس والبضائع إلى وجهاتهم. لكن بينما يصمم المهندسون شرايين النقل كهندسة صلبة من الخطوط المستقيمة، تقضي الطبيعة ملايين السنين في صقل شبكات التوزيع المثالية. الأنهار تشق مجاريها إلى البحر دون خطأ، وورقة النبات تتخللها عروق، كل وعاء في مكانه، دون أي عنصر زائد.