كيف نميّز الطفرة الخطيرة عن الطفرة الحميدة؟ سريع
في مكتبة ضخمة، حيث كل كتاب هو جين، علينا أن نعثر على خطأ مطبعي واحد. قد يكون الخطأ غير ضار، وقد يغيّر معنى الجملة كليًا. بهذه الطريقة تقريبًا يبحث علماء الوراثة عن الطفرات الضارة بين ملايين الاختلافات الحميدة.
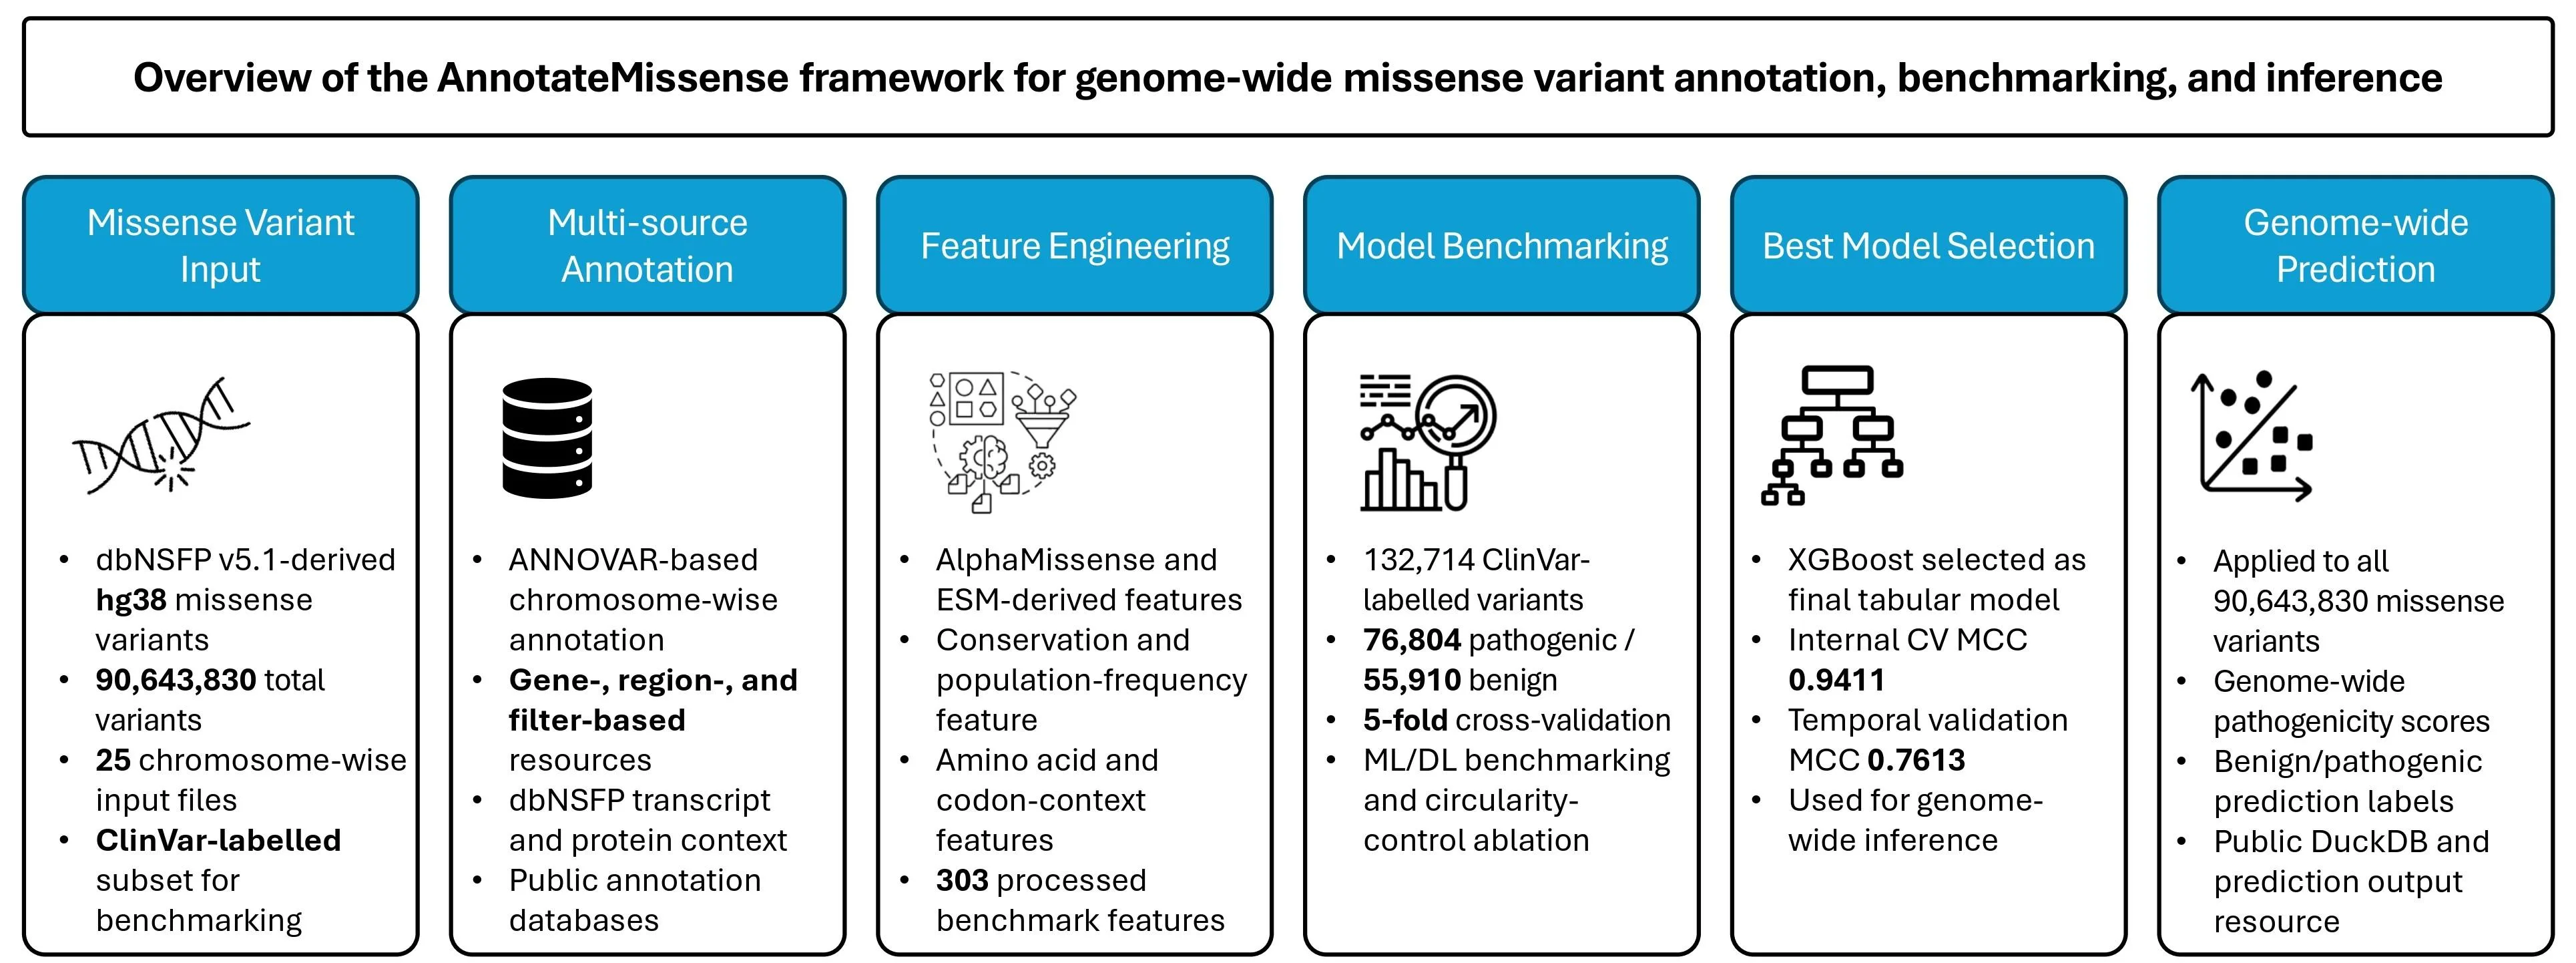
البرنامج، الذي أُطلق عليه اسم AnnotateMissense، يعمل كمصحح لغوي دقيق. فهو لا ينظر فقط إلى الحرف المستبدل نفسه، بل يجمع كل الأدلة الممكنة: كم مرة تظهر هذه الاستبدالة لدى الأشخاص الأصحاء، وكم يتغير شكل البروتين، وماذا تقول البرامج المتنبئة الأخرى، وحتى كيف يبدو «خط اليد» للتطور — هل بقي هذا الجزء ثابتًا عبر الأنواع المختلفة؟ بلغ مجموع هذه الأدلة 303.
الأمر الأكثر إثارة حدث عندما بدأوا يسلبون البرنامج أدلته. فبدون بيانات تواتر الطفرة في السكان، وبدون تلميحات من المتنبئات الأخرى، انخفضت الدقة بشكل حاد — كما لو أن المصحح فقد قاموسه ودليله النحوي. أما حذف التقييمات العصرية من نماذج اللغة البروتينية فلم يؤثر تقريبًا على النتيجة. تم اختبار النسخة النهائية على بيانات جديدة ظهرت بعد التدريب: بقيت الدقة عالية — 88%. بعد ذلك، مسح البرنامج الجينوم البشري بأكمله وأصدر درجات خطورة لـ 90 مليون طفرة.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2605.24520
Missense variant interpretation remains challenging because pathogenicity depends on heterogeneous evidence from population frequency, evolutionary conservation, transcript context, amino acid substitution severity, prior pathogenicity predictors and protein-language-model-derived features. We present AnnotateMissense, a scalable annotation, benchmarking and genome-wide prediction framework for missense variant interpretation. AnnotateMissense integrates hg38 missense variants derived from dbNSFP v5.1 with ANNOVAR annotations, dbNSFP transcript/protein descriptors, AlphaMissense scores, ESM-derived features, conservation metrics, population-frequency variables, established pathogenicity predictors and engineered amino acid/codon-context features. Using 132,714 ClinVar-labelled missense variants, we benchmarked machine-learning and deep-learning models under controlled feature configurations. The full 303-feature benchmark set achieved the strongest performance with XGBoost, reaching mean MCC = 0.9411 and ROC-AUC = 0.9950 across stratified five-fold cross-validation. Restricted naive and location-oriented feature sets achieved lower best MCC values of 0.4989 and 0.5113, respectively. Circularity-controlled ablations showed that removing prior-predictor, population-frequency and clinically overlapping evidence reduced performance, whereas excluding AlphaMissense and ESM-derived features alone had minimal effect. Temporal ClinVar validation on newly observed pathogenic/benign variants achieved MCC = 0.7613, accuracy = 0.8798 and F1-score = 0.8750. The final model was applied to 90,643,830 hg38 missense variants to generate AnnotateMissense pathogenicity scores and binary prediction labels. Code and outputs are available at https://github.com/MuhammadMuneeb007/CAGI7_Annotate_All_Missense and https://doi.org/10.5281/zenodo.19981867.
كلمة «ميسنس» في الاسم تعني أن الطفرة تغيّر حمضًا أمينيًا واحدًا فقط في البروتين — مثل استبدال حرف واحد في كلمة. لكن حتى هذا التفصيل الصغير قد يحوّل «بيت» إلى «نار».
في فيلم «جاتاكا»، قُسّم المجتمع إلى «مؤهلين» و«غير مؤهلين» بناءً على التوقع الجيني — برامج مثل هذه تجعل هذا السيناريو أقرب إلى الواقع.