الأطالس الخلوية: من يقرأ لغة النسيج بشكل أفضل؟ سريع
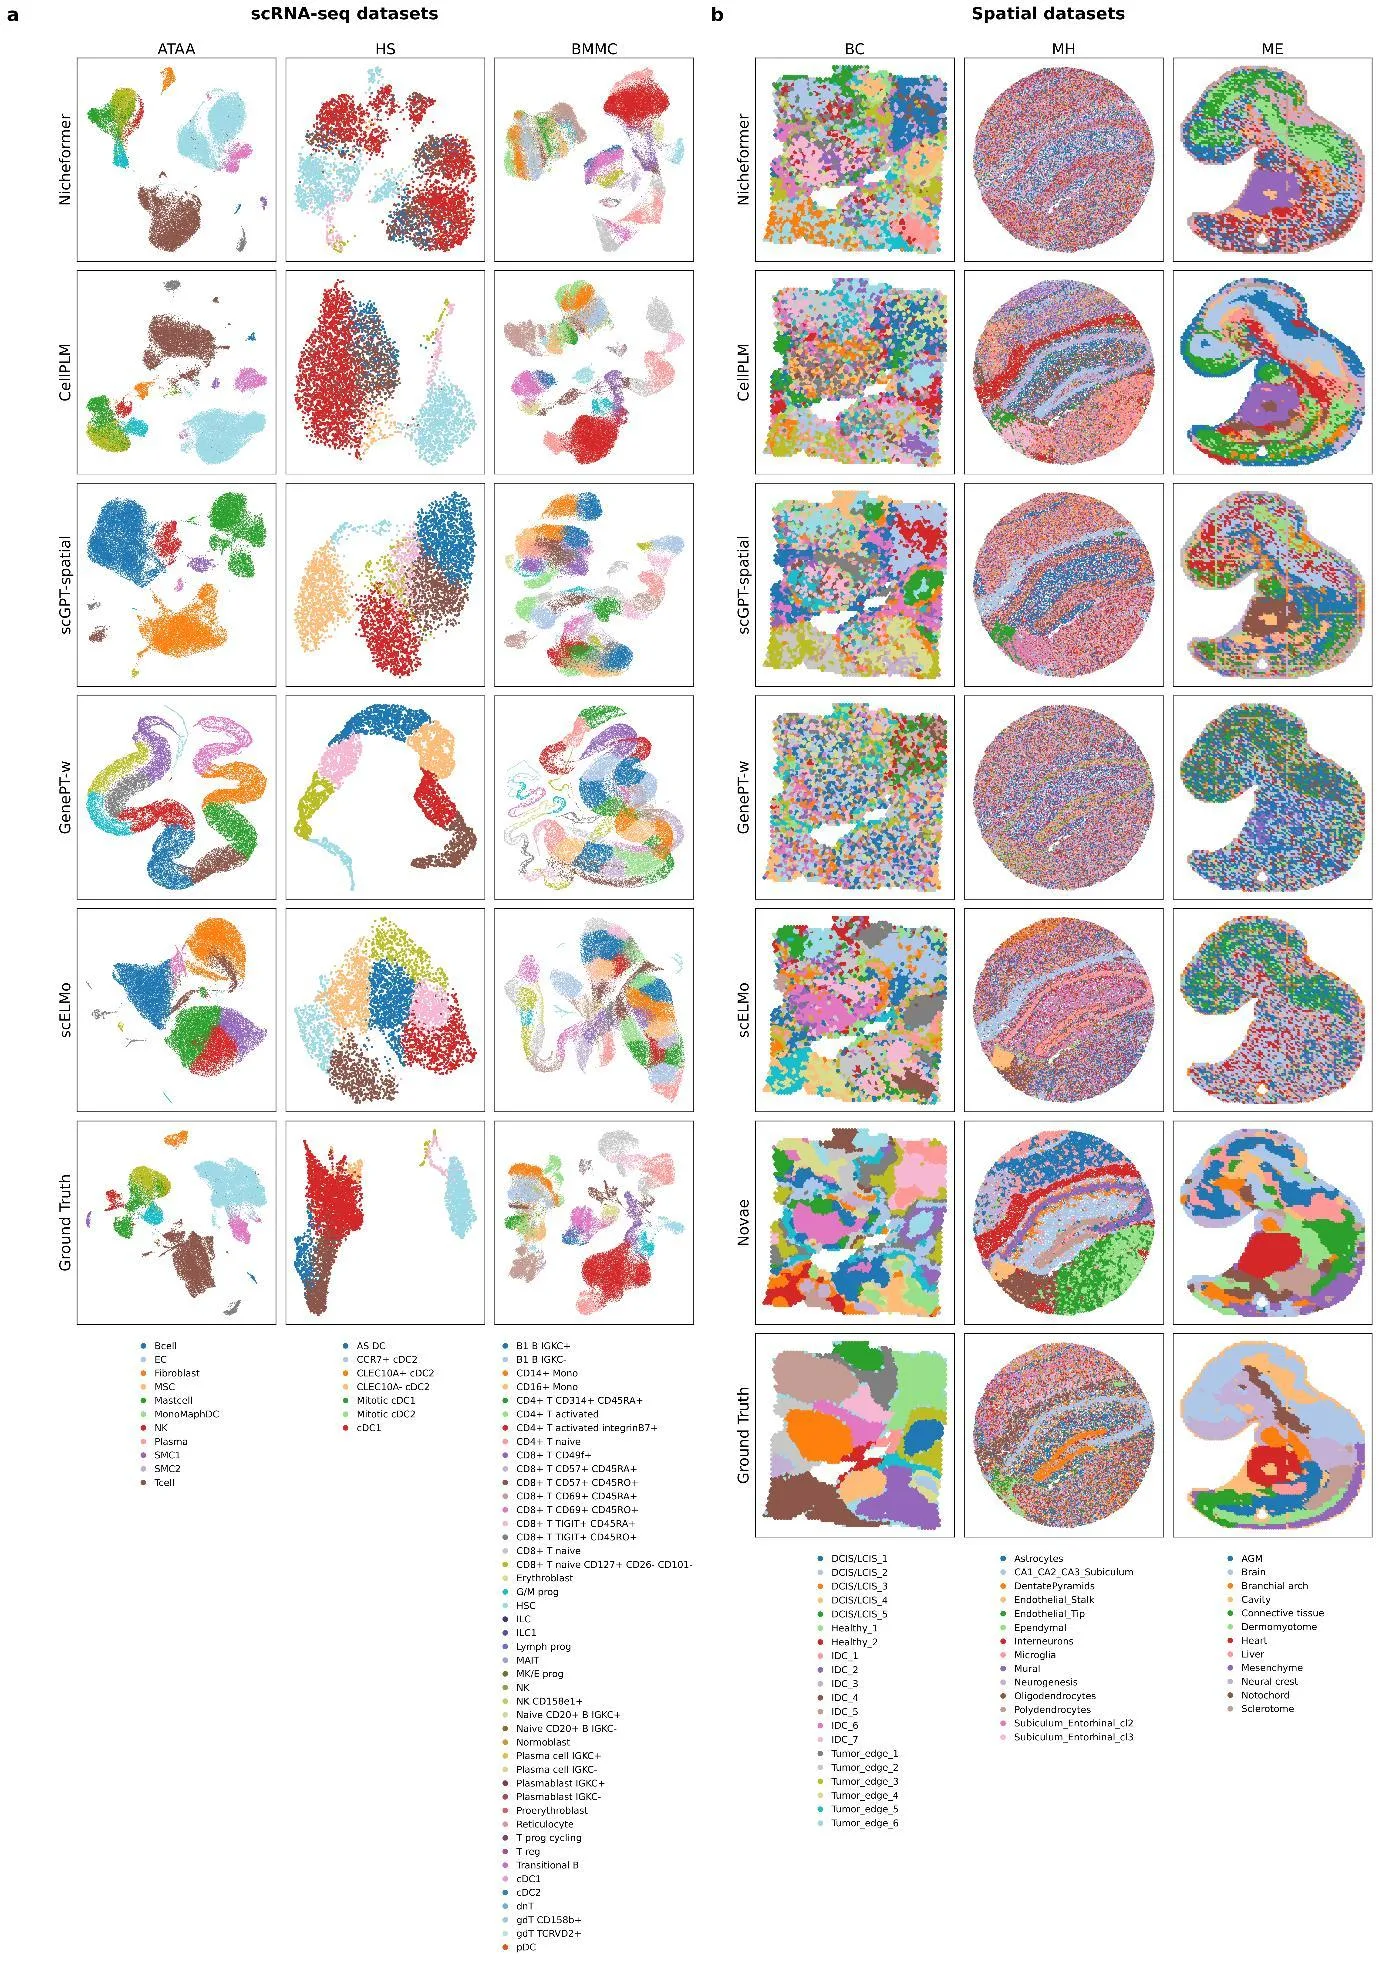
يعتمد علماء الأحياء بشكل متزايد على أجهزة الكمبيوتر لقراءة «دليل التشغيل» للخلية الحية. ستة نماذج حديثة من الذكاء الاصطناعي — Nicheformer، وCellPLM، وscGPT-spatial، وGenePT، وscELMo، وNovae — هي بمثابة ستة مترجمين من لهجات مختلفة لنفس اللغة الخلوية. كل واحد تعلم من نصوصه الخاصة: بعضها حفظ تسلسلات الجينات النشطة، والبعض الآخر درس الخرائط المكانية للأنسجة، والبعض الآخر بدأ من اللغة البشرية العادية.
أجرى مؤلفو الدراسة امتحانًا عادلًا لها. أُعطيت النماذج نفس المهام: تجميع الخلايا حسب النوع، والعثور على الجينات المميزة (وهي «جوازات السفر» الجزيئية للخلايا)، أو التنبؤ بكيفية استجابة الخلية لدواء. كما كانت البيانات الأولية مختلفة — من قوائم بسيطة للجينات النشطة إلى صور تُظهر موقع كل خلية داخل النسيج.
كانت النتيجة مفاجئة ومتواضعة. النماذج التي دُرِّبت على قوائم «مسطحة» من الجينات كانت الأفضل في تحديد أنواع الخلايا. النماذج المكانية التي ترى خريطة النسيج حافظت على بنية العضو بدقة أكبر. والنماذج اللغوية، التي تعتبر الجين مجرد كلمة في جملة، توقعت تأثير الأدوية بشكل جيد بشكل غير متوقع. لم يفز أي نموذج في جميع الفئات، وتغير ترتيب القوى مع أدق التفاصيل — طريقة معالجة البيانات، أو اختيار المقياس، أو حتى كيفية «تقطيع» الجينات إلى أجزاء للتحليل.
هذا ليس سباقًا نحو بطل مطلق. بل هو ظهور مجموعة أدوات كاملة، كل منها جيد في مجاله. المستقبل للنماذج التي لا تستطيع فقط جمع النقاط في الاختبارات، بل أن تشرح للعالم البيولوجي لماذا سلكت الخلية هذا المسار التنموي بالذات.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2607.17227
Single-cell and spatial foundation models promise transferable biological representations, yet their generality remains largely untested across modalities, biological domains and analytical tasks. We benchmarked six representative models, Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo and Novae, using a harmonised framework spanning scRNA-seq, spatial transcriptomics and Perturb-seq. We evaluated zero-shot and continually pretrained clustering, supervised annotation, marker-gene concordance and perturbation prediction. Model performance was strongly conditional: expression-trained cell-level transformers best resolved many cell-identity tasks, spatial and graph-aware models better preserved tissue architecture, and language-derived gene embeddings were competitive for selected perturbation-response metrics. No model dominated across tasks, and rankings shifted with modality, preprocessing, tokenisation, biological prior, domain shift and metric choice. This benchmark provides practical guidance for model selection and argues that future models should be judged by biological generalisation, interpretability and perturbation-grounded validity, not by scale or leaderboard performance alone.
تعلمت بعض النماذج فهم الجينات بمجرد «قراءة» المقالات العلمية. بالنسبة لها، الجين مثل كلمة، والخلية مثل فقرة.