Un orchestre sans chef : le gang élastique pour l'inférence de LLM ✛
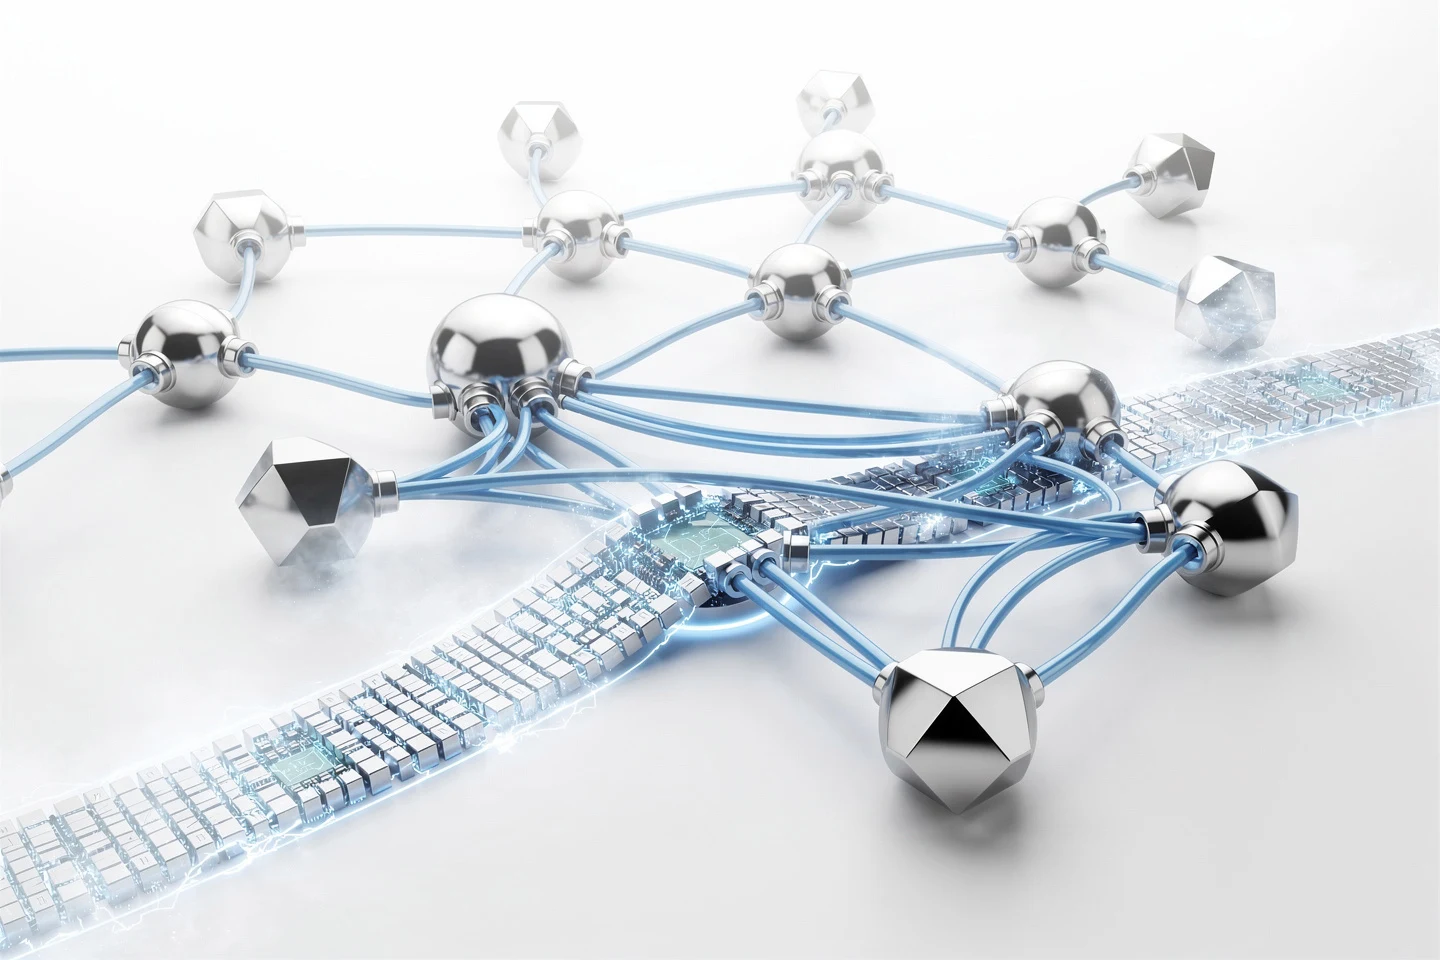
Sept cœurs sont figés devant une barrière invisible. Le huitième s'attarde sur un processus étranger — et toute l'inférence de grands modèles de langage se bloque. Voilà le principal conflit de la vie commune entre les tâches d'apprentissage automatique et les processus ordinaires sur un même processeur. Le gang d'inférence exige que tous les cœurs frappent en mesure simultanément — sinon, silence. Mais le système d'exploitation ne peut pas simplement geler un cœur au milieu de la génération d'un token (un mot ou une partie de mot dans un modèle de langage) : la barrière n'attendra jamais le retardataire, et l'ajout spontané d'un nouveau participant faussera imperceptiblement le résultat.
Dans Anima OS — un système d'exploitation écrit en Rust — ce problème a été résolu en transformant le gang en un orchestre élastique sans chef. Chaque cœur-musicien peut entrer dans l'ensemble ou le quitter strictement entre les mesures — c'est-à-dire entre les tokens. Le protocole ACK-latch fonctionne ainsi : avant le début de la génération, un drapeau d'activité est levé et le numéro d'époque est incrémenté. Chaque cœur capable de se faire emprunter confirme l'époque en cours, après avoir sauvegardé l'état de son processus — comme un musicien qui met son instrument en pause et fait un signe de tête. La composition des participants pour le token suivant est fixée dans un seul mot atomique — un masque binaire où ne figurent que ceux dont la confirmation correspond à l'époque au moment de la fixation. Ce masque est publié avant le début du token, et chaque point d'attente de barrière le lit précisément. Un cœur qui n'a pas eu le temps de se confirmer n'est simplement pas inclus dans le token en cours — personne ne l'attend, et son travail est volé par les voisins.
Les essais sur un processeur AMD Ryzen 9 9800X3D (architecture Zen 5) avec les modèles SmolLM2-135M et Qwen2.5-7B ont montré : avec un quart du temps occupé par l'inférence, le débit global pour les processus ordinaires a augmenté de 1,75 fois par rapport au partitionnement statique des cœurs — de 327 à 574 quanta de service par seconde. La vitesse de génération n'a pas diminué, et la sortie des modèles est restée bit à bit identique à la configuration fixe. Le hachage des logits finaux — les évaluations numériques de probabilité des tokens — 0x9a2917eca1a62bd1 n'a pas changé dans aucun scénario. Le délai de restitution d'un cœur après la fin de la génération était médian de 0,22 microseconde — pratiquement instantané. Et la capture d'un cœur occupé, selon une politique conservatrice, dure un quantum du planificateur (environ 16 millisecondes) : le processus locataire n'est pas interrompu au milieu de son quantum, le cœur ne rejoint le gang qu'à son expiration.
Le gang élastique brise l'idée reçue de l'incompatibilité entre les calculs à barrières strictes et la redistribution dynamique des cœurs. Le protocole ACK-latch transforme le groupe d'inférence en un objet de planification à part entière : il partage les ressources avec le reste du système sans perte de correction. Cela ouvre la voie à des systèmes d'exploitation où l'inférence de LLM n'est pas une tâche isolée, mais un service ordinaire qui s'adapte à la charge, un peu comme un orchestre change de composition entre les mouvements d'une symphonie. Le mécanisme peut être porté sous Linux avec le planificateur SCHED_DEADLINE, adapté aux architectures hétérogènes (big.LITTLE) et intégré aux politiques d'économie d'énergie. Ainsi, le gang élastique, se synchronisant sur un mot-partition unique, fait un pas vers la solution du problème fondamental de la coexistence pacifique des calculs synchrones et asynchrones dans un même système. Désormais, un cœur bloqué n'est plus un problème. S'il n'arrive pas à la barrière, il saute simplement la mesure, et l'orchestre élastique continue de jouer — et aucune note ne sonne faux.
Même avec 301 migrations de processus sur une fenêtre de 10 secondes, l'inférence restait bit à bit exacte, et la dispersion des mesures de débit ne dépassait pas 0,9 %.