Les grands modèles de langage modernes sont des réseaux de neurones avec une architecture « transformer », comptant de centaines de millions à des centaines de milliards de paramètres. Chaque paramètre est un nombre qui influence la façon dont le signal d'un mot est transmis à un autre. Le modèle ne stocke pas les mots, mais les transforme en vecteurs de nombres — des points mathématiques dans un espace multidimensionnel de significations. Le pré-apprentissage se fait par une tâche de complétion automatique : le modèle comble les mots manquants ou prédit le mot suivant dans une séquence. Ensuite, il peut être affiné sur des exemples spécialisés pour mener un dialogue, résoudre des problèmes ou écrire du code.
Histoire
L'histoire a commencé avec les modèles statistiques n-grammes (années 1950), puis les modèles de langage neuronaux (Bengio et al., années 2000). Le tournant a été l'article Attention Is All You Need (2017), qui a proposé l'architecture transformer. La société OpenAI a lancé GPT-1 en 2018 avec 117 millions de paramètres, puis GPT-3 en 2020 avec 175 milliards de paramètres, démontrant que le modèle, sans apprentissage explicite, pouvait traduire, programmer et raisonner simplement en recevant une instruction en langage naturel. Depuis lors, la compétition porte à la fois sur l'augmentation de la taille des modèles et sur l'amélioration de l'efficacité (Mixture-of-Experts, lois d'échelle de Chinchilla).
Comment ça marche
Le modèle reçoit en entrée une fenêtre contextuelle de n tokens. Chaque token est projeté en un embedding et encodé par des couches d'auto-attention, créant des représentations contextualisées. En sortie, un classifieur linéaire prédit la distribution de probabilité du token suivant. L'apprentissage minimise l'entropie croisée entre la prédiction et le token réel. Lors de la génération, le texte est produit par échantillonnage séquentiel des tokens (généralement avec noyau top-p ou top-k). Techniques clés : pré-apprentissage sur du texte non étiqueté, puis ajustement supervisé ou par RLHF pour aligner sur l'utilité et la sécurité. Le mécanisme d'attention calcule les poids de similarité entre les requêtes et les clés pour chaque paire de tokens, permettant de se concentrer sur les dépendances à longue distance.
En pratique
Ces modèles rédigent des actualités, composent des poèmes, génèrent du code informatique, répondent aux questions des clients dans les chats et aident les médecins à rédiger des résumés de dossiers médicaux.
Anecdote
GPT-3 peut rédiger un essai que le jury ne distingue pas d'un écrit humain en 2 secondes, le temps qu'il faut à une personne pour simplement ouvrir un éditeur de texte.
En mars 2020, la France s'est vidée : les gens ont cessé d'aller au travail, à l'école et au café, et les rues se sont remplies de silence. Les épidémiologistes regardaient les courbes et comprenaient que le virus ne se propageait pas tout seul, mais par les poignées de main, les conversations et les trajets en métro.
En mars 2020, la France s'est vidée : les gens ont cessé d'aller au travail, à l'école et au café, et les rues se sont remplies de silence. Les épidémiologistes regardaient les courbes et comprenaient que le virus ne se propageait pas tout seul, mais par les poignées de main, les conversations et les trajets en métro.
Une protéine dans une cellule ne reste pas immobile comme un mannequin en vitrine. Ses atomes tremblent, s'étirent et se plient constamment, un peu comme une corde de guitare tendue qui continue de vibrer après qu'on l'a pincée. Pour comprendre comment une protéine fonctionne, il faut savoir à quel point chaque partie est fermement liée à ses voisines.
L'interprète se laisse distraire par le moindre bruit dans la salle, et une réunion d'une heure s'étire sur deux. C'est le même problème pour les modèles de fondation moléculaires : ils apprennent le langage des molécules sur d'immenses corpus, mais chaque nouvelle conversation exige un réglage.
Un dossier médical ressemble à un long journal intime : visites chez le médecin, diagnostics, ordonnances, analyses. Un médecin le lit de bout en bout pour comprendre l'état du patient. Désormais, une machine lit ce journal — et elle le fait en quelques secondes.
Les développeurs ont créé le modèle Foresight-E.
La recherche d'un nouveau matériau ressemble à la cuisine sans recette : on essaie, on essaie, et souvent on jette. Avant, les scientifiques feuilletaient les articles à la main et testaient les compositions une par une. Maintenant, un « robot-cuisinier » est apparu, qui lit lui-même la littérature, mélange les composants et regarde ce que ça donne.
Le radiotélescope, telle une oreille attentive, capte le murmure des galaxies lointaines. Parmi ce bruit se cachent des géants — les sources radio géantes. Ce sont des nuages de particules chargées éjectés des environs de trous noirs supermassifs.
Dans un four, quand la température augmente, les molécules se déplacent plus vite et le désordre s'accroît. Avec les modèles de langue comme ChatGPT, c'est tout l'inverse. Lorsque les développeurs augmentent le paramètre « température », le modèle accède à un choix de mots plus large, mais ses textes longs se figent soudainement.
Le magnétoencéphalographe, un appareil qui ressemble à un casque muni de centaines de capteurs, capte les faibles champs magnétiques produits par les neurones en activité. Lorsqu'une personne écoute de la parole, ces signaux renferment des empreintes des mots entendus.
L'esprit humain ressemble à un jeu de construction qui s'auto-construit. Les nouvelles idées ne meurent pas avec leur créateur : elles se transmettent, se mélangent et sont sélectionnées. Ce processus est appelé évolution culturelle : les inventions utiles se consolident, les inutiles tombent dans l'oubli. C'est le principe du cliquet, ce mécanisme qui ne tourne que dans un sens.
Quatre faibles traits sur l’image — tout ce que voit l’astronome. Ainsi, un sculpteur restaure la forme d’un verre invisible à partir de quatre ombres.
Deux cent quarante-deux mille trois cent vingt-sept galaxies — comme des grains de sable sur une plage. Mais les astronomes ont transformé ce chaos en carte : l'algorithme UMAP a pris de chaque galaxie onze paramètres — sept couleurs de l'optique au moyen infrarouge (c'est la…
En 2025, les grands modèles de langage comme GPT ne se contentent plus de discuter — ils aident les scientifiques à monter des expériences. Mais le même outil peut tomber entre les mains de personnes malveillantes. Une équipe de chercheurs a construit un terrain d'essai numérique pour le vérifier.
Un artiste fait un croquis rapide au fusain – et le visage sur le portrait est déjà reconnaissable. Les astrophysiciens résolvent un problème similaire : le spectre d'une étoile est son portrait individuel, révélant température, composition, gravité.
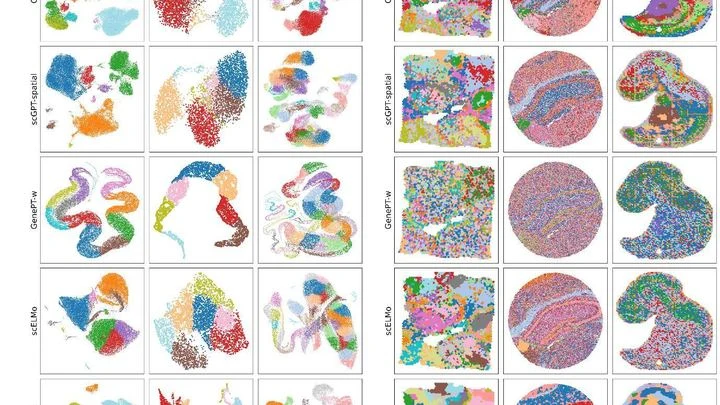
Les biologistes confient de plus en plus aux ordinateurs la lecture des « modes d'emploi » de la cellule vivante. Six modèles récents d'intelligence artificielle — Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo et Novae — sont comme six traducteurs de dialectes différents d'un même langage cellulaire.
Le livre de recettes se réécrit de génération en génération, mais un jour, la recette du bortsch reçoit un ingrédient secret d'un pâtissier. Dès lors, le goût ne se souvient plus seulement des ancêtres, mais aussi du voisin. Dans le modèle standard de l'évolution, les gènes se comportent de la même manière.
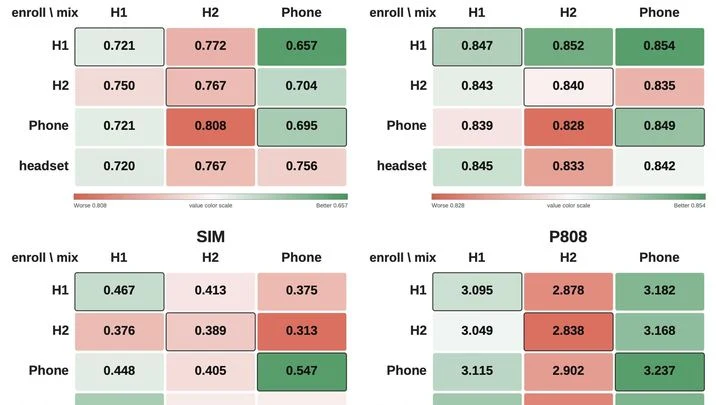
Les signaux radio dans une pièce se comportent comme le son dans une salle de concert : en se réfléchissant sur les murs et les objets, ils créent une empreinte unique — la mélodie silencieuse de chaque lieu. Le téléphone, telle une oreille attentive, capte cette mélodie dans le bruit et les distorsions. Il mémorise quel accord correspond au coin du canapé, et lequel à l'embrasure de la porte.
Une IA classique regarde les images médicales comme des puzzles faits de pièces inconnues : elle considère que deux images non appariées sont complètement différentes. C'est comme essayer de distinguer des jumeaux sans connaître leur lien de parenté. Or, en médecine, les patients atteints d'une même maladie présentent des IRM presque identiques, et l'algorithme se trompe en confondant les « parents ».
Un humain extrait sans effort la voix qu'il cherche du brouhaha d'une fête. Pour un ordinateur, c'est encore une tâche à la limite du possible. Les programmes précédents étaient entraînés sur des enregistrements stériles, sans écho ni tintement de couverts.
Les modèles qui transforment le texte en audio reproduisent bien les sons isolés, mais se mélangent les pinceaux quand le scénario en comporte plusieurs. Par exemple, selon le scénario, on a d'abord une sonnerie, puis des pas, puis un claquement de porte. Le générateur peut intervertir les événements, et le spectateur entendra les pas avant la sonnerie.
Les juges automatiques de la parole sont des algorithmes qui évaluent la prononciation et les émotions. Cependant, ils fonctionnent souvent comme un critique culinaire qui rend son verdict après avoir lu le menu, sans avoir goûté le plat.
Dans une casserole de soupe, deux thermomètres suffisent pour connaître la température partout — à condition de savoir que la chaleur se propage en cercles depuis le fond. De même en science : à partir de mesures éparses, il faut reconstruire l'image complète du champ thermique.
Le cerveau communique par de brefs clics électriques. Autrefois, pour apprendre cette langue, il fallait des milliers d'exemples traduits par l'expérimentateur. La méthode MOJO suit une autre voie : comme dans l'apprentissage par immersion, elle écoute d'abord le « flux de conscience » sans aucune indication et repère elle-même les motifs récurrents.
Pendant longtemps, les biologistes ont étudié les cellules en n'écoutant qu'une seule voix dans un chœur polyphonique : par exemple, ils mesuraient l'activité des gènes en ignorant comment l'ADN était empaqueté. C'est comme essayer de comprendre une conversation en ne connaissant qu'une seule langue.
Évaluer la qualité d'une image, c'est le travail d'un contrôleur méticuleux muni de tout un attirail. Le réseau de neurones IQA-T1 agit exactement ainsi : il ne se contente pas de dévisager l'image, il y applique tantôt un spectroscope, tantôt un luxmètre.
Le son se décrit naturellement par un nombre complexe, où le volume représente la force de l'onde et la phase sa position dans le temps. Les réseaux de neurones classiques séparent ces deux aspects en coordonnées indépendantes, un peu comme si l'on donnait une adresse par quartiers : « deux à l'est, un au nord ».
La préparation d'un plat complexe exige une recette claire : d'abord couper, puis faire revenir, ajouter les épices au bon moment. Les transformations chimiques suivent aussi des recettes pas à pas — des mécanismes où les atomes de carbone et d'hydrogène se réarrangent strictement dans l'ordre.
Les puces neuromorphiques fonctionnent différemment des ordinateurs classiques, construits selon les plans de John von Neumann, avec une mémoire et un processeur séparés.
Les assistants logiciels d'écriture de code agissent souvent comme un cuisinier qui, pour faire cuire un seul œuf, relit tout son livre de recettes. Face à une demande de correction minuscule, ils rouvrent des dizaines de fichiers et vérifient des liens connus depuis longtemps. C'est du travail inutile — de l'énergie gaspillée.
Un réseau neuronal qui génère des sons à partir de texte, c'est un peu comme une cuisine où chaque « plat » est préparé par des dizaines de cuisiniers. Beaucoup ne font que gêner : ils envoient des signaux erronés et gaspillent des ressources.
L'émetteur n'envoie qu'une ébauche grossière du message — comme un artiste qui dessine les contours sans les détails. À la réception, l'IA, tel un restaurateur expérimenté, reconstruit le tableau complet, en le nettoyant des parasites. C'est ainsi que fonctionne la technologie LiTCom, qui change la donne dans les futurs réseaux 6G.
Un grand réseau de neurones, comme Whisper, maîtrise des centaines de langues et ressemble au modèle standard de l'univers : tout est équilibré. Mais l'apprentissage d'une langue rare rompt cet équilibre — elle se transforme en trou noir qui attire toutes les ressources d'apprentissage.
La méthode standard de numérisation de la parole : on mesure le volume des milliers de fois par seconde. C'est comme goûter un bouillon avec une cuillère à café — chaque gorgée est aqueuse, et il n'y a presque pas de détails. Le flux de données enfle, alors que le sens se compte sur les doigts.
Les chercheurs ont proposé de « réduire » d'abord le signal sonore.
L'arbre généalogique se transforme en écheveau si l'on tient compte des enfants adoptés et des remariages. L'évolution ressemble souvent à un tel écheveau : bien que le modèle standard dessine un arbre des espèces bien propre, en réalité les gènes voyagent non seulement par héritage, mais aussi directement entre organismes non apparentés.
Un réseau électrique vivant ressemble à un organisme : les lignes à haute tension sont les vaisseaux, le courant est le sang. Les données, elles, sont les influx nerveux qui se perdaient autrefois. mAIEnergy connecte ces « nerfs » à un « cerveau » commun.
Un détective expérimenté ne calcule pas la trajectoire d'un criminel selon les lois de la physique — il consulte sa bibliothèque d'affaires similaires.
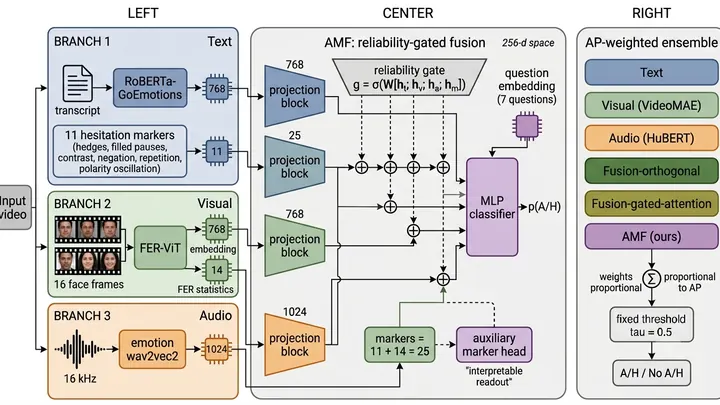
Un nouveau système analyse un court entretien pour reconnaître les doutes d'une personne, en combinant texte, voix et expressions faciales. Mais la clé principale de l'incertitude s'est révélée être la matière noire de la parole : les pauses et les mots de remplissage que les systèmes vocaux standard effacent comme un trou noir.
Les dispositifs quantiques ne sont plus des curiosités de laboratoire. On les assemble, on les règle et on les répare comme du matériel ordinaire — sauf qu'à l'intérieur, il n'y a pas simplement du courant, mais des enchevêtrements de particules capables d'être dans plusieurs états à la fois.
La cosmologie moderne est en dissonance. Les mesures locales de la constante de Hubble à partir des supernovae et des céphéides donnent environ 73 km/s/Mpc, tandis que les contraintes globales issues du fond diffus cosmologique dans le cadre du modèle standard ΛCDM…