Умный фильтр для редких частиц экспресс
В глубине горы, под толщей камня, лежит кристалл германия размером с кулак. Он ждёт редчайшего события: распада атома, который происходит раз в миллиарды лет. Но в кристалле постоянно что-то тикает — космические лучи, следы радиоактивности, тепловой шум. Отделить настоящий сигнал от этого фона — как услышать шёпот на рок-концерте.
Раньше физики слушали только отдельные ноты: измеряли, как быстро нарастает сигнал, сколько энергии выделилось, как долго он затухает. По этим нотам решали, похоже ли событие на искомый распад. Но такой подход терял детали. Теперь на всю звуковую дорожку целиком посадили нейросеть — трансформер, который умеет улавливать тонкие отличия в форме импульса. Он не просто сравнивает числа, а видит весь узор, как опытный музыкант слышит фальшивую ноту в аккорде.
Результат удивил: нейросеть нашла на 20% больше настоящих событий, чем старые методы, при том же уровне ложных тревог. А для самых сложных случаев, где сигнал почти сливается с шумом, выигрыш ещё больше. Это значит, что мы можем заглянуть глубже в тайну нейтрино — частицы, которая, возможно, равна своей античастице. Если так, то распад, который ловит детектор, откроет, почему во Вселенной есть вещество, а антивещество исчезло.
Теперь детектор слушает не только громкие ноты, но и весь шёпот Вселенной.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2603.06192
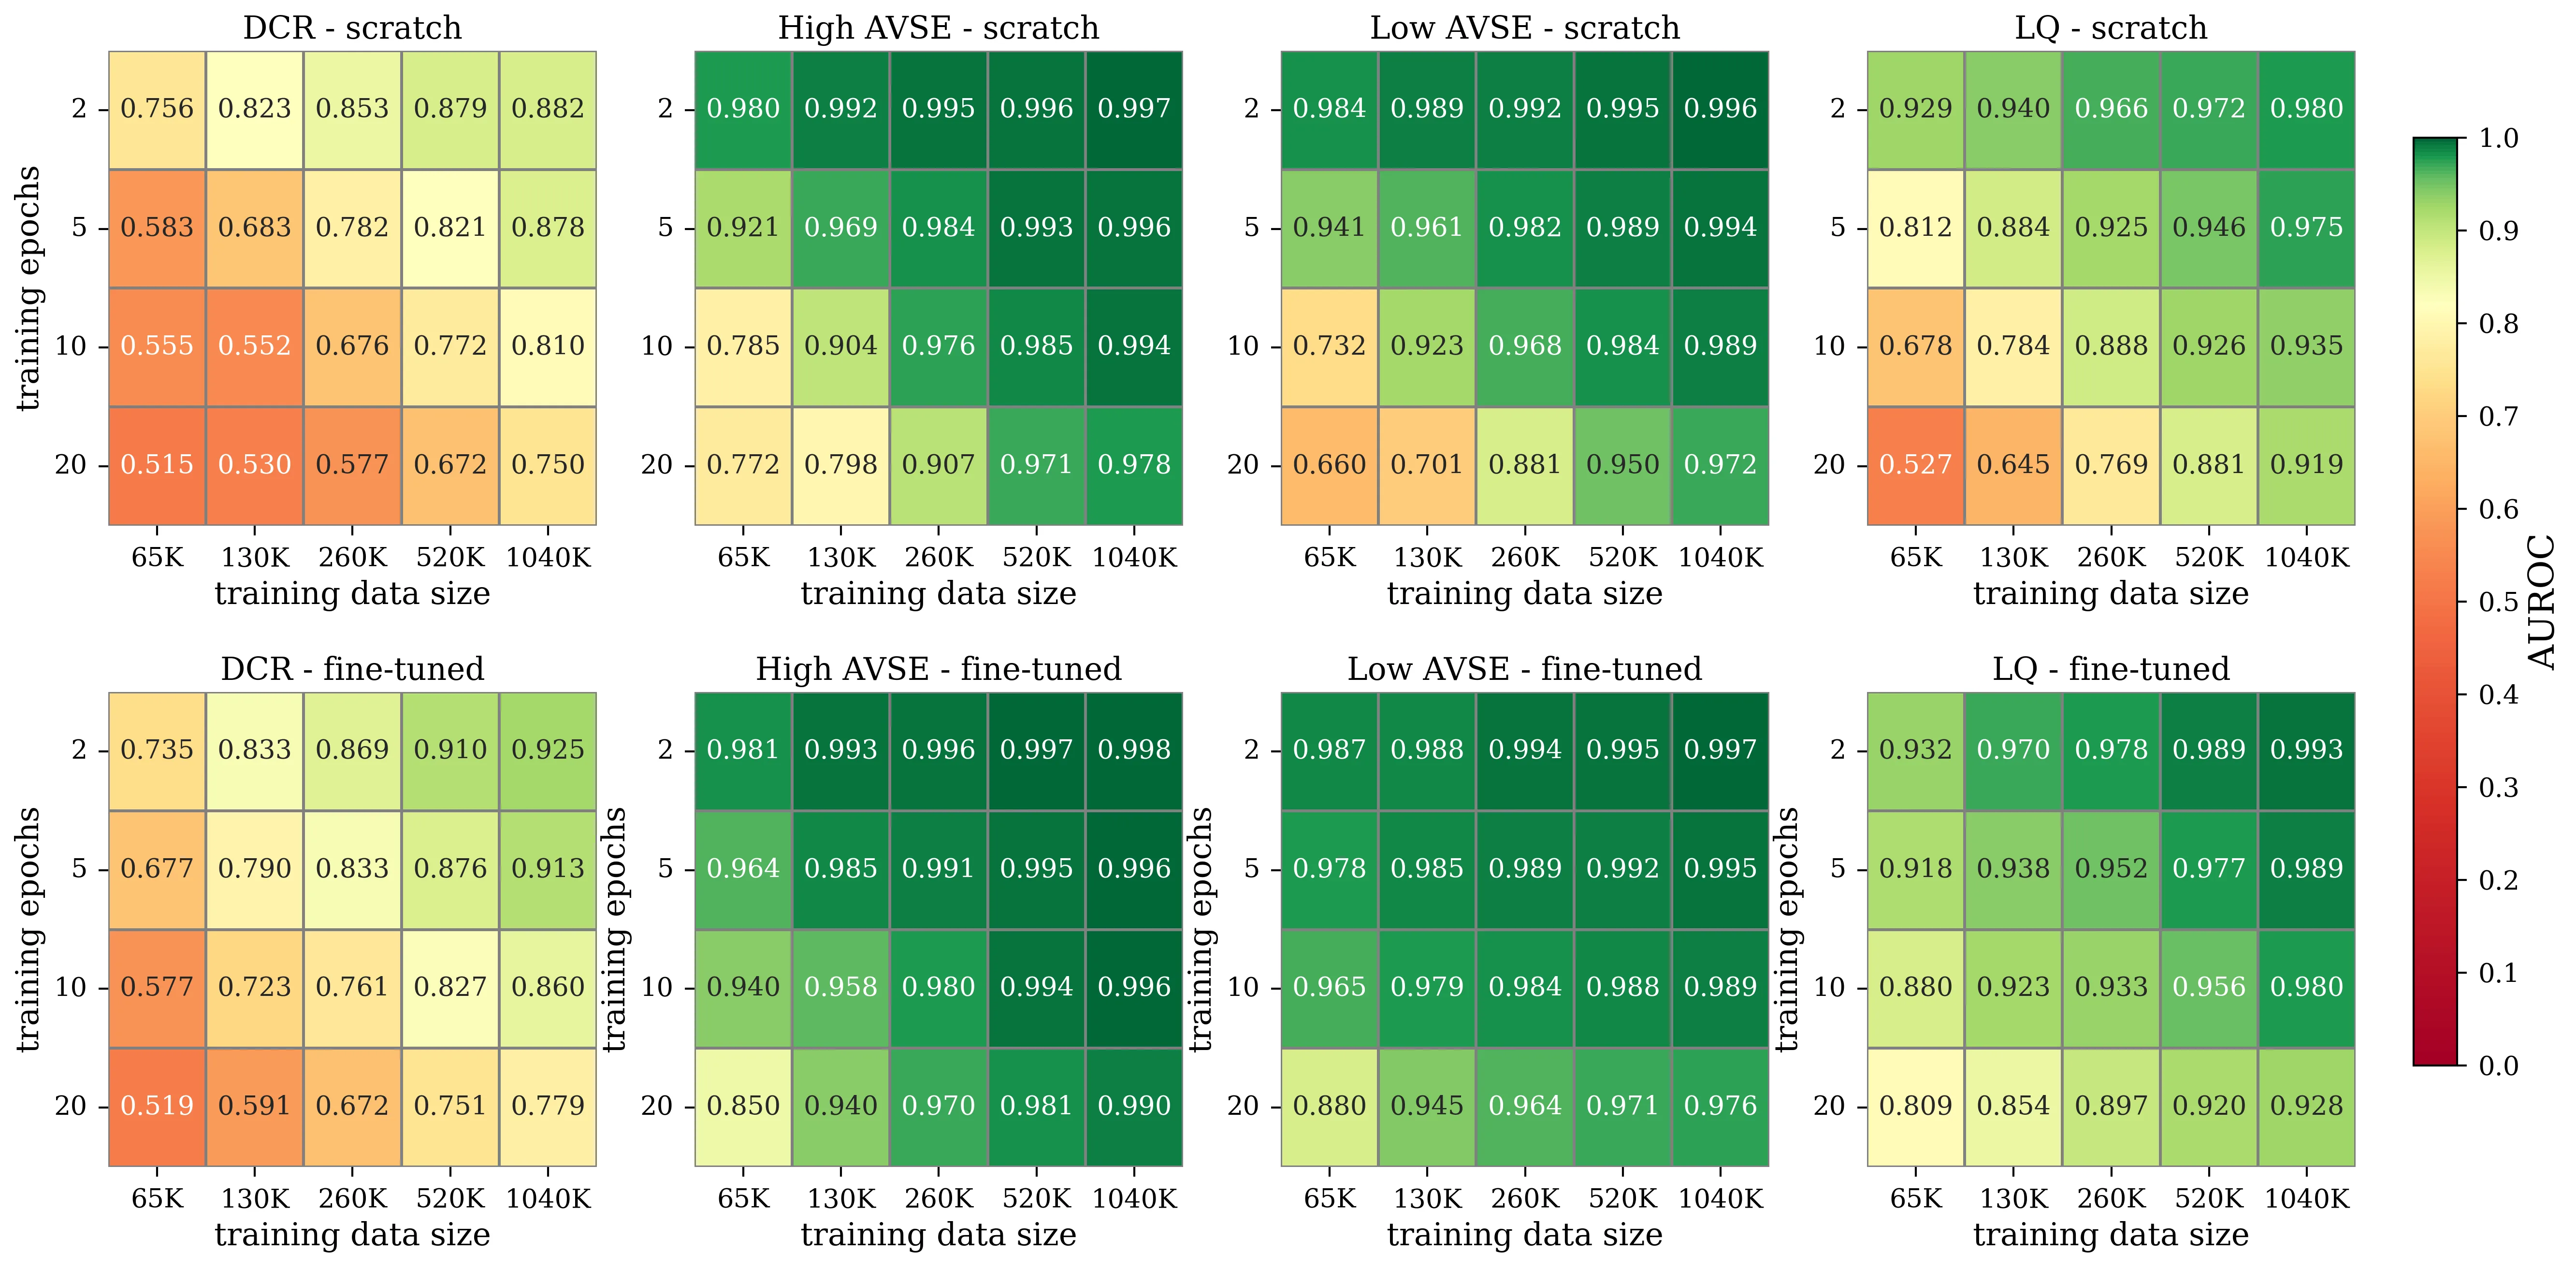
Pulse-shape discrimination (PSD) in high-purity germanium (HPGe) detectors is central to rare-event searches such as neutrinoless double-beta decay (0vBB), yet conventional approaches compress each waveform into a small set of summary parameters, potentially discarding information in the full time series that is relevant for classification. We benchmark transformer-based models that operate directly on digitised waveforms using the Majorana Demonstrator AI/ML data release. Models are trained to reproduce the collaboration-provided accept/reject labels for four standard PSD cuts and to regress calibrated energy. We compare supervised training from scratch, masked autoencoder (MAE) self-supervised pre-training followed by fine-tuning, and a feature-based gradient-boosted decision tree (GBDT) baseline. Transformers outperform GBDT across all PSD targets, with the largest gains on the most challenging labels and on the combined PSD-pass definition. MAE pre-training improves sample efficiency, reducing labelled-data requirements by factors of 2-4 in low-label regimes. For energy regression, both transformer variants show a small common underestimation on the test split, while fine-tuning modestly narrows the residual distribution. These results motivate follow-up studies of robustness across detectors and operating conditions and of performance near QBB.
Кристалл германия для такого детектора выращивают месяцами, а потом держат при температуре жидкого азота, чтобы тепловой шум не заглушил слабые сигналы.