Размеченные данные относятся к наборам данных, где каждый входной образец сопоставлен с правильным выходным значением или целевой меткой, предоставляя истинную информацию (ground truth), которую используют модели машинного обучения с учителем для обучения. В таких задачах, как классификация изображений, распознавание речи или медицинская диагностика, размеченные данные служат учителем: модель корректирует свои внутренние параметры, чтобы минимизировать разницу между своими предсказаниями и предоставленными метками. Качество и количество размеченных данных часто являются наиболее критическими факторами, определяющими производительность модели.
История
Практика использования размеченных данных для машинного обучения восходит к ранним экспериментам с перцептронами в 1950-х и 1960-х годах, но она стала центральной парадигмой с развитием глубокого обучения в 2010-х, когда большие размеченные наборы данных, такие как ImageNet, привели к прорывам в компьютерном зрении.
Как это работает
Во время обучения модель с учителем обрабатывает размеченные входные данные, делает предсказания и сравнивает их с истинными метками с помощью функции потерь. Затем ошибка распространяется обратно через сеть, обновляя веса, чтобы уменьшить будущие ошибки. Этот итеративный процесс, повторяемый на множестве примеров, позволяет модели обобщать закономерности из размеченных данных на невиданные ранее входные данные. Точность меток напрямую влияет на надежность модели, так как неверные аннотации обучают модели неправильным ассоциациям.
Где применяется
Размеченные данные лежат в основе таких приложений, как фильтрация спама и обнаружение мошенничества, а также автономное вождение, где аннотированные изображения дорог и препятствий обучают системы восприятия.
Любопытный факт
Создание размеченных данных настолько трудоемко, что породило глобальную индустрию «аннотации данных», где миллионы людей размечают изображения, текст и аудио для обучения ИИ.
Старые карты сокровищ рисовали по слухам: кто-то нашёл золото у реки, кто-то в горах, и каждый копал в своём месте. С высокотемпературными сверхпроводниками вышло похоже: купраты нашли в одних соединениях, пниктиды железа в других, никелаты в третьих, а общей карты не было.
Радиолог смотрит на снимок брюшной полости и видит не просто органы, а их взаимное расположение: какая почка больше, где опухоль относительно сосуда. Это похоже на чтение карты, где важно не только знать, где обычно стоит город, но и уметь измерить расстояние между двумя точками на местности.
Старый атлас автомобильных дорог лежит на столе. На его страницах линии соединяют города, а толщина линий говорит о том, насколько оживлённым было сообщение. Нейросеть смотрит на такую карту и называет возраст машины, которая по ней ездила. Примерно так устроена модель, которую обучили предсказывать возраст человека по карте связей его мозга.
Алмаз — не просто украшение. Внутри его кристаллической решётки прячутся дефекты, которые чувствуют магнитное поле лучше многих приборов. Один такой дефект — NV-центр — работает как крошечный компас, но его стрелка колеблется от тепла и шума. Чтобы компас показывал точное направление, нужна калибровка.
Заблудиться в зеркальном зале проще простого: каждая стена отражает другую, и кажется, что ты уже был здесь. Примерно так же путается мозг, когда вокруг много похожих мест. Нейроны — клетки, отвечающие за карту пространства, — могут выдать одинаковый сигнал для двух разных углов комнаты.
Белковый инженер похож на повара, который пытается сделать блюдо одновременно вкусным, полезным и дешёвым. Изменяя один ингредиент, он рискует испортить другой. Раньше компьютерные помощники умели оценивать свойства белков только по отдельности, не видя, как они связаны между собой.
Камера смотрит на лицо и руки человека, а по едва заметным изменениям температуры кожи понимает: сейчас ему тяжело. Тепло тела — как невидимые чернила, которые проявляются при стрессе. Кровь приливает к одним участкам и отливает от других, и картина получается у каждого своя. Задача — найти в этом тепловом узоре те места и секунды, которые выдали тревогу.
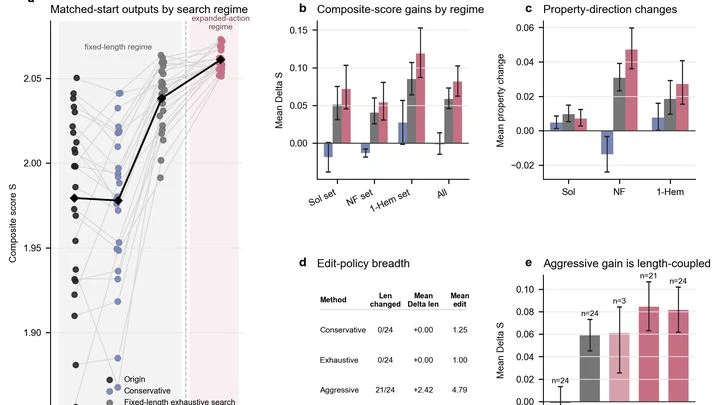
Лазерный луч умеет не только нагревать, но и успокаивать движение. Когда свет попадает в ловушку из зеркал, он давит на них — и если правильно настроить цвет луча, давление превращается в мягкое торможение. Так охлаждают крошечные механические колебания почти до абсолютного нуля. Обычно для этого просто подбирают постоянный оттенок лазера и силу его свечения.
Сто тысяч звёзд в тесном ядре шарового скопления движутся как стальные шарики в гигантском пинбольном автомате. Каждый «толчок» — гравитационная встреча двойной системы с одиночной звездой — запускает каскад непредсказуемых событий. Пара может разлететься, чужак может выбить одного из партнёров и занять его место, а иногда все трое застревают в запутанном иерархическом танце.
Восстановить целостную картину по обрывкам — всё равно что расслышать мелодию оркестра в шумном зале. Такие задачи стоят в фотометрии — области, измеряющей поток излучения от небесных тел, где по слабому мерцанию восстанавливают яркость звезды. Традиционные методы требуют точных сведений о помехах, а они почти всегда неизвестны.
Пилоту в воздушном бою необходимо мгновенно идентифицировать объект и его намерения. Традиционные системы ожидают полного набора радарных данных — это сродни вратарю, который реагирует лишь после удара по мячу. Новый алгоритм действует как опытный вратарь: анализируя начальные движения нападающего, он предсказывает манёвр цели задолго до завершения траектории.
Группа роботов-исследователей подобна компании поваров, пробующих одно блюдо. Каждый снимает пробу со своего участка и делится впечатлением: свободно, занято или неясно. Но вкусы субъективны — кто-то не заметил ножку стула, кто-то слизал лишь край. Вместо того чтобы усреднять разноголосицу, роботы договариваются: там, где уверенности мало, честно писать «не знаю».
Радиосигналы в замкнутом пространстве ведут себя подобно акустическим волнам в концертном зале: многократно отражаясь от стен, мебели и других поверхностей, они формируют уникальную интерференционную картину — своего рода безмолвную «мелодию» каждого места. Смартфон, оснащённый приёмником, подобно чуткому уху, регистрирует эту картину через анализ помех и искажений сигнала.
Обычные алгоритмы компьютерного зрения воспринимают медицинские изображения как набор несвязанных фрагментов — любые два несовпадающих снимка для них абсолютно различны. Это напоминает попытку отличить близнецов, не зная об их родстве. В медицине же пациенты с одним заболеванием часто выглядят на МРТ почти идентично, и алгоритм ошибается, путая «родственные» случаи.
Искусственный интеллект, предсказывающий акустику помещения, напоминает студента на экзамене со шпаргалкой. Если проверочные точки совпадают с учебными, модель просто запоминает звуковой «отпечаток» каждой позиции — как студент, узнающий билет по загибу уголка.
Модели, превращающие текст в аудио, хорошо воссоздают одиночные звуки, но путаются, когда в сценарии их несколько. Например, по сценарию сначала звонок, потом шаги, потом хлопок двери. Генератор может переставить события, и зритель услышит шаги до звонка.
Исследователи нашли неожиданное решение: вместо программирования сложных правил они взяли нейросеть, которая «понимает» аудио, и сделали её строгим контролёром.
Автоматические судьи речи — это алгоритмы, обученные оценивать произношение и эмоциональную окраску голоса. Однако, как показали исследования, они часто ведут себя подобно кулинарному критику, который выносит вердикт, прочитав меню, но не попробовав само блюдо.
Современный стандартный подход к обучению искусственного интеллекта можно сравнить с ребёнком, запертым в библиотеке: он запоминает миллионы книг, но не знает, что огонь обжигает, а падение приносит боль.
Мозг общается короткими электрическими разрядами — потенциалами действия. Прежде расшифровка этого языка требовала тысяч размеченных примеров: экспериментатор сопоставлял сигнал с конкретным движением или словом. Метод MOJO предлагает иной подход — подобно изучению языка через погружение, он сначала вслушивается в «поток сознания» без всяких подсказок и самостоятельно выявляет повторяющиеся паттерны.
Оценка качества снимка — это работа для дотошного контролёра с целым арсеналом инструментов. Нейросеть IQA-T1 действует именно так: она не просто разглядывает картинку, а методично применяет то спектроскоп, то люксметр. Цифровой шум, словно рябь на воде, маскирует дефекты, но анализ частот — спектроскопия изображения — позволяет выявить потерю резкости.
Ребёнок, осваивая незнакомую квартиру, ползает от предмета к предмету и запоминает, что видно из каждого угла. Так мозг строит мысленную карту — внутреннюю модель пространства. Алгоритм gradCSCG действует по тому же принципу: он получает видеопоток с камеры и самостоятельно рисует схему помещения, опираясь лишь на смену картинок.
В шумной комнате человек выделяет нужный голос благодаря бинауральному слуху: два уха улавливают микроскопическую разницу во времени прихода звуковых волн и их интенсивности. Компьютер с массивом микрофонов действует аналогично — он извлекает пространственные подсказки, вычисляя направление на каждый источник звука.
Представьте повара, который учится готовить исключительно по рисованным картинкам — он почти наверняка испортит каждое блюдо. Схожая ловушка подстерегает и компьютерное зрение: для обучения моделей требуются тысячи размеченных снимков, но собирать и аннотировать их вручную — дорого и муторно.
Когда вы набираете «салат», а интеллектуальная клавиатура предлагает «цезарь», за кулисами миллионы телефонов совместно обучаются предсказывать слова. Они обмениваются не вашими сообщениями, а лишь улучшениями общего алгоритма — подобно тренеру, который рассылает спортсменам только изменения в плане тренировок: «добавьте 5 отжиманий к вчерашней программе».
Исследователи отобрали 16 повседневных действий — от мытья посуды до приседаний — и разложили движения на элементарные составляющие, подобно тому, как спектроскоп разделяет свет на спектр частот. Они сравнили три подхода к анализу и обнаружили неожиданный ключ к распознаванию: для идентификации действия достаточно усреднённого стоп-кадра, то есть статичной позы.
Поиск в интернете похож на просеивание муки для выпечки: среди белых частиц могут оказаться тёмные вкрапления почвы. Это загрязнение данных — незаметная примесь, которая портит итоговый результат. C3R действует как умное сито: оно не только отсеивает информационный сор — ложные или вводящие в заблуждение данные, — но и способно остановиться, если мусора слишком много.
Стандартный подход к оцифровке речи, лежащий в основе современных телекоммуникаций, — это прямая дискретизация: тысячи раз в секунду фиксируется мгновенная громкость сигнала. Представьте, что вы пробуете бульон чайной ложкой — каждый глоток даёт лишь слабый намёк на вкус, а чтобы уловить букет, приходится черпать снова и снова.
Живая энергосистема подобна организму: линии электропередач — это сосуды, по которым течёт ток-кровь. Данные же — нервные импульсы, которые прежде рассеивались, не достигая единого центра обработки. Проект mAIEnergy подключает эти «нервы» к общему «мозгу», создавая хранилище, где собраны спутниковые снимки, показания электросчётчиков, научные статьи и метеосводки.
Гамма-небо, запечатлённое телескопом Fermi, — это грандиозная симфония из тысяч источников. Здесь ритмичные пульсации пульсаров, мощные аккорды активных ядер галактик, но больше всего — неотождествлённых объектов, чья партия остаётся загадкой.
Вообразите: филармонический оркестр играет, но микрофон ловит лишь слитный гул — tutti, в котором смешались контрабасы, флейты и литавры. Похожую задачу десятилетиями решают физики, вглядываясь в поля плотности, температуры или магнитной индукции.
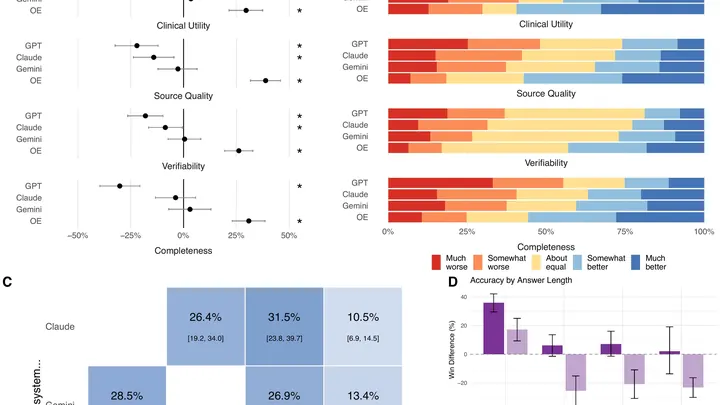
Каждую неделю врачи задают ИИ-помощникам миллионы вопросов у постели больного. Но проверяют эти инструменты обычно на экзаменационных задачках, а не на том, что спрашивают в реальной клинике. Группа исследователей решила это исправить.
Они собрали 620 настоящих вопросов от докторов из 30 специальностей — от кардиологии до онкологии.
Врач листает историю болезни и видит строчку: «Препарат снижает риск». Но насколько этому можно верить? Основано ли утверждение на паре случаев из практики или на десятках тысяч пациентов в слепом исследовании? От ответа зависит лечение. Сегодня такие тексты всё чаще пишут не люди, а большие языковые модели — те самые, что помогают искать информацию и составлять сводки.
Веками астрономы всматривались в ночное небо, ловя малейшие изменения блеска звёзд. Эти неравномерные ряды — кривые блеска — словно нотные станы: каждая звезда исполняет свою уникальную мелодию. Но сегодня потоки данных с телескопов вроде обзора Веры Рубин (LSST) превратились в оглушительную какофонию — миллиарды «записей» еженощно.
Инженер настраивает антенну: тянет один сегмент — частота уходит, меняет угол — падает усиление. Примерно так же устроена разработка лечебных пептидов (коротких белковых цепочек).
Вы рассказываете другу историю, а его мозг словно настраивается на вашу волну — одни и те же участки активируются в такт вашим словам. Учёные записали такую «нейронную синхронизацию» с помощью магнитоэнцефалографии (прибора, улавливающего магнитные поля мозга) и решили проверить, может ли компьютерная языковая модель повторить этот танец смыслов.
Лаборатория отправляет роботу список из тысячи молекул-кандидатов для нового лекарства. Робот-предсказатель, натренированный на старых данных, выдаёт для каждой оценку «подойдёт — не подойдёт». Но когда список приходит из незнакомой области — другого вируса или редкой опухоли — робот начинает путаться. Его уверенность остаётся высокой, а реальные попадания падают до нуля.
Фотограф снимает ночной лес и пытается поймать в кадр светлячков. Вспышки редкие, слабые, а вокруг — шум ветра и далёкие огни. Примерно так работает огромный детектор Hyper-Kamiokande в Японии: он ловит нейтрино — почти неосязаемые частицы — по крошечным вспышкам света в 260 тысячах тонн воды.
Два игральных кубика всегда выпадают одинаково, как бы далеко их ни раскидали. В квантовой физике такое поведение называют запутанностью, и она — главный ресурс для компьютеров будущего и защищённой связи. Но беда в том, что не всякую запутанность легко заметить.
Вы пробуете блюдо в ресторане, но меню не видели. Задаёте официанту вопросы — слишком солёное? с какими специями? — и по ответам пытаетесь угадать, что за повар его готовил. Примерно так же исследователи изучают современные нейросети, когда доступ к ним есть только через API (программный интерфейс, где можно задать вопрос и получить ответ, но нельзя заглянуть внутрь).