مُصمِّم بروتينات بذاكرة تُحسِّن خطواته سريع
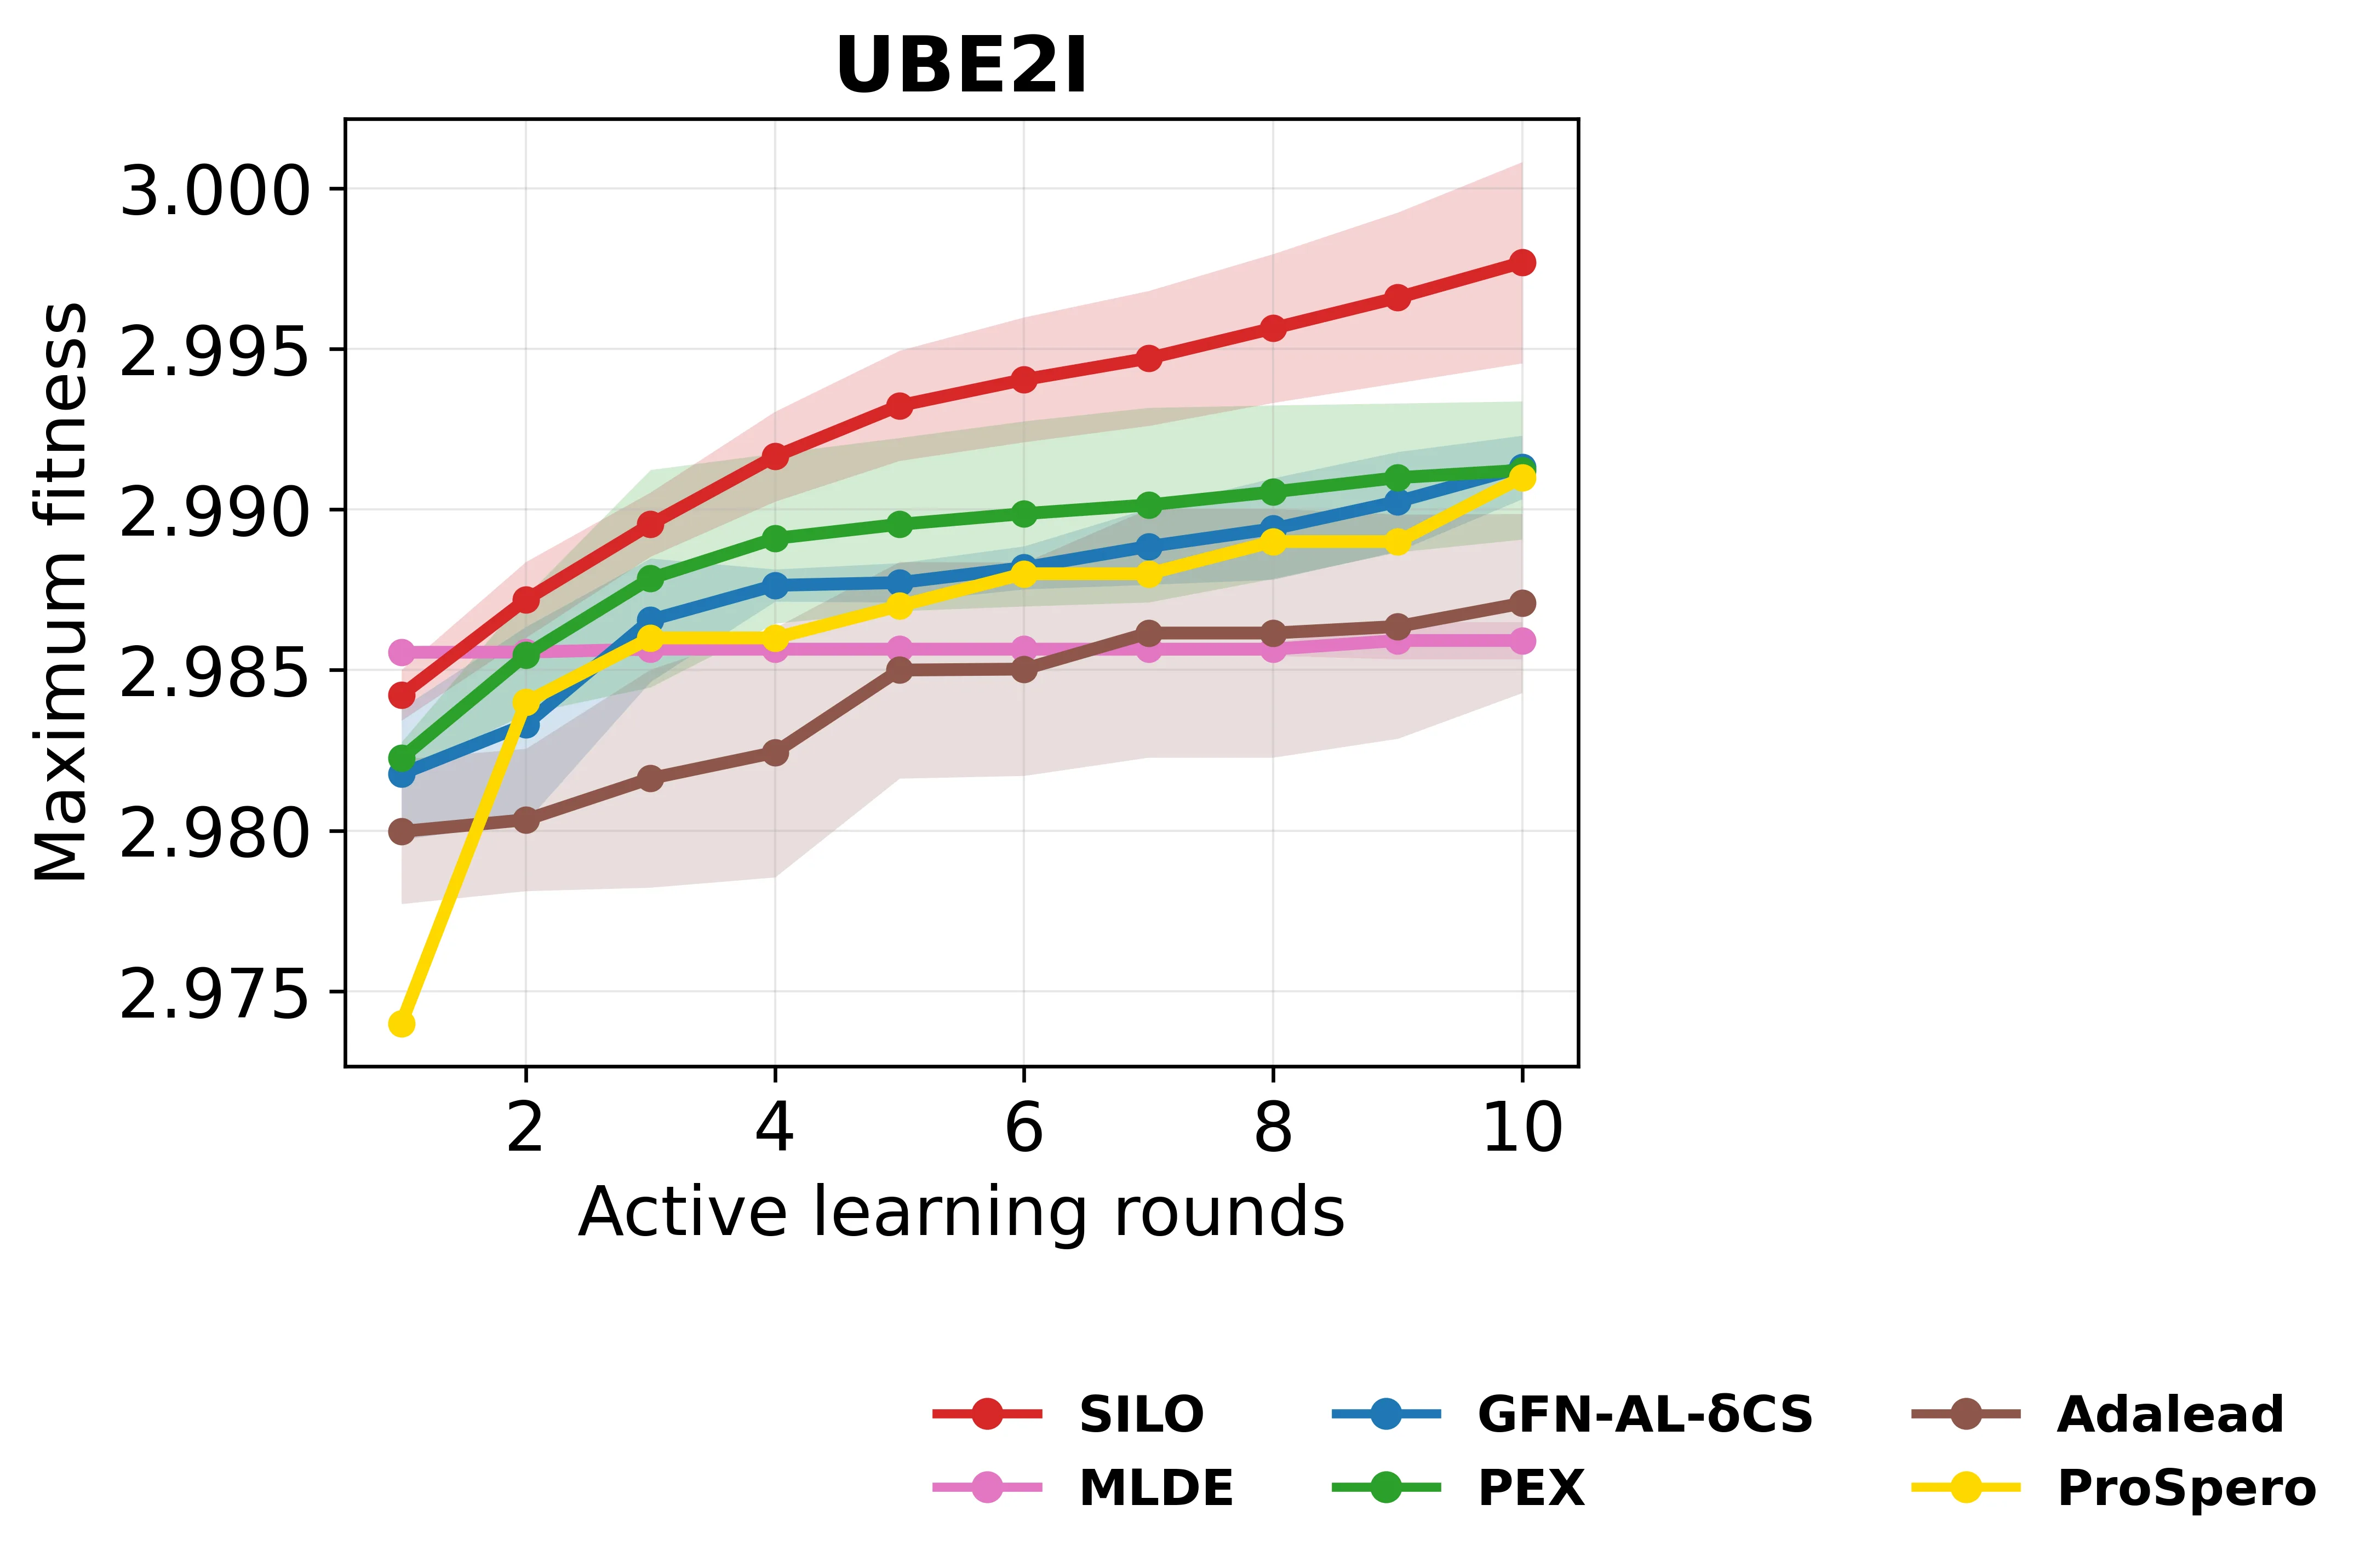
تحسين وصفة طبق معقد أمر دقيق، خاصة إذا كان بإمكانك تجربة عدد قليل من النسخ يوميًا. تغيير المكونات عشوائيًا أمر محفوف بالمخاطر: أزل الملح أو البيكنج باودر وستفسد القاعدة. قصة مشابهة مع البروتينات: الطفرات العشوائية غالبًا ما تكسر الأجزاء الحيوية، وكل تجربة في المختبر تكلف وقتًا ومالًا.
النهج الجديد المسمى SILO يعمل بشكل مختلف. فهو يقسم كل تغيير إلى خطوتين: أولاً يختار موضعًا في سلسلة البروتين، ثم يحدد أي حمض أميني سيضعه هناك. يشبه هذا إصلاح محرك: الميكانيكي لا يغير كل القطع على التوالي، بل يبحث عن الجزء المعطل ويختار قطعة الغيار المناسبة له. وفي الوقت نفسه، يستخدم SILO حيلة ذكية — «اختبار الألانين»: يستبدل الموضع مؤقتًا بأبسط لبنة (ألانين) ليفهم مدى أهمية هذا الموضع لوظيفة البروتين. هكذا لا تلمس الخوارزمية الأماكن الحرجة.
أثناء البحث، يراكم SILO الخبرة. في كل جولة، يولد عدة نسخ، ويختبرها في نموذج حاسوبي، ويتذكر أنجحها. ثم يتعلم تقليد هذه الخطوات الناجحة، دون محاولة التنبؤ بـ«الدرجة» الدقيقة لكل تغيير — فهذه الدرجات غالبًا ما تكون مزعجة ومضللة. هذا النهج يشبه تعلم الطباخ: بدلاً من حساب درجة حرارة الفرن المثالية بالمعادلات، يكرر ببساطة حركات الشيف عندما يعد أفضل نسخة من الطبق.
الخلاصة بسيطة: لإنشاء بروتين مثالي، لا تحتاج إلى تجربة كل شيء. يكفي أن تتذكر أفضل خطواتك وتتجنب بعناية الأماكن الهشة — مثل حرفي ماهر يعرف أدواته ولا يفسد قطعة العمل.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2605.26690
Protein sequence optimization under tight oracle budgets requires methods that explore vast combinatorial spaces while making each evaluation informative. Existing reinforcement learning and off-policy generative approaches often degrade under surrogate noise, and position-agnostic mutation proposals risk disrupting functionally critical residues. We introduce SILO, a trajectory-level self-improvement imitation framework for oracle-budgeted protein design. SILO uses a hierarchical edit policy that decomposes each mutation into a position choice followed by a residue choice. In each active-learning round, the policy samples candidate trajectories via incremental stochastic beam search without replacement (SBS), and a UCB-based proxy ensemble, combined with an alanine-scan fitness score (AFS), selects candidates with functionally relevant edits for in silico oracle evaluation. The policy is then updated by next-action cross-entropy imitation on the round's best oracle-labeled trajectories, avoiding value-function estimation. Across eight reproduced protein fitness landscapes and five strong baselines from prior work, SILO achieves the highest maximum and top-100 mean fitness on 8 of 8 landscapes within our evaluations, often exhibiting faster early-stage improvement. In low-data and noisy-proxy stress tests on two landscapes per setting, SILO remains competitive or best when several baselines degrade. Ablations show that SBS with AFS account for much of the gains, with iterative imitation providing additional improvement. Code is available at: https://github.com/grimmlab/SILO.git
اختبار الألانين المستخدم في SILO ابتُكر في ثمانينيات القرن العشرين: كان علماء الأحياء يستبدلون الأحماض الأمينية بالألانين واحدًا تلو الآخر للعثور على «النقاط الساخنة» المهمة لوظيفة البروتين. هذا يشبه فحص الزر المعطل في المصعد بالضغط على الأزرار واحدًا تلو الآخر.