نموذج اللغة البروتينية هو نوع من نماذج التعلم الآلي يُدرَّب على مجموعات بيانات كبيرة من تسلسلات البروتينات، على غرار كيفية تدريب نماذج اللغة على النصوص. تتعلم هذه النماذج الأنماط الإحصائية والعلاقات بين الأحماض الأمينية في البروتينات، مما يلتقط القيود التطورية والهيكلية. بعد التدريب، يمكن استخدامها للتنبؤ ببنية البروتين ووظيفته وتفاعلاته، وكذلك لتصميم بروتينات جديدة بخصائص مرغوبة.
التاريخ
اكتسب هذا المفهوم شهرة في أواخر العقد الأول من القرن الحادي والعشرين وأوائل العقد الثاني، مع نماذج مثل ProtBERT وESM (النمذجة التطورية على نطاق واسع) من Meta AI، بالبناء على التقدم في معالجة اللغة الطبيعية.
كيف يعمل
النموذج عادةً ما يكون شبكة عصبية عميقة، غالبًا ما تعتمد على بنى المحولات، التي تعالج تسلسلات البروتين كـ"جمل" من الأحماض الأمينية. أثناء التدريب، يتعلم التنبؤ بالأحماض الأمينية المخفية أو المفقودة بناءً على السياق المحيط، على غرار كيفية توقع نموذج اللغة للكلمات المفقودة. هذا يجبر النموذج على استيعاب التبعيات المعقدة بين الأحماض الأمينية، والتي تعكس القواعد الفيزيائية والتطورية التي تحكم طي البروتين ووظيفته. بعد التدريب، يمكن استخدام التمثيلات الداخلية للنموذج لمهام لاحقة مثل التنبؤ بالبنية أو تصميم البروتين.
في التطبيق
يُستخدم في اكتشاف الأدوية، وهندسة الإنزيمات، والبيولوجيا الاصطناعية للتنبؤ ببنى البروتينات وتصميم بروتينات جديدة بوظائف محددة، مثل الإنزيمات للعمليات الصناعية أو الأجسام المضادة العلاجية.
حقيقة طريفة
لقد ثبت أن نماذج اللغة البروتينية تتعلم المعلومات التطورية دون أن تُدرَّب صراحةً على البيانات التطورية، فقط من خلال ملاحظة الأنماط في تسلسلات البروتينات الموجودة.
كانت أربع خرائط قديمة ملقاة في أدراج مكتب مختلفة. على كل خريطة جينات مرتبطة بشيخوخة الخلايا، لكن الخرائط لم تكن متطابقة: أسماء مختلفة، ومقاييس مختلفة، ومفاتيح مختلفة. وكان الباحث الذي يفتّش عن جين لتجربته مضطرًا إلى مقارنتها يدويًا، مع خطر أن تفوته علامة مهمة.
جمعت SenSASP هذه الخرائط في خريطة واحدة.
في قاعة المرايا، يقف المرء أمام مرآة مشوّهة فيرى نفسه تارة قزمًا وتارة عملاقًا. وعلى هذا النحو تقريبًا تتصرّف نماذج التعلّم الآلي الشائعة حين يُطلب منها تخمين العمر البيولوجي من تحاليل الدم أو صور الدماغ: فهي تمدّد العمر عند الطرفين، فتُنقصه لدى كبار السن وترفعه لدى الشباب. وهذا التحيّز ليس خطأً عشوائيًا، بل تشويه منهجي مضمَّن في منطق التدريب نفسه.
في مسرح الجريمة يُعثر على بقعة. يأخذ الخبير مسحة، وبعد بضع ساعات يخرج الجهاز قائمة بالبروتينات التي كان السائل يتكون منها. سابقًا، كان الاختبار السريع قد يخطئ إذا كانت السوائل متعددة: اختلط الدم باللعاب، وأظهر الشريط نتيجة خاطئة. الآن، يزن مقياس الطيف الكتلي كل جزيء، وتترجم ثلاثة خوارزميات هذه الأوزان إلى لغة خبير الأدلة الجنائية.
المترجم الأول يعرف كلمات منفردة.
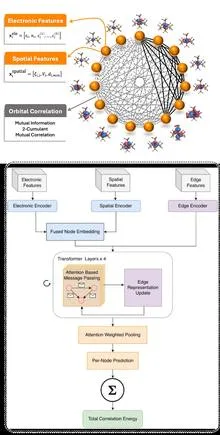
رسّام خرائط لا يرسم الجبال والأنهار، بل الروابط غير المرئية بين الإلكترونات، هكذا يمكن وصف الشبكة العصبية الجديدة. بدلًا من الإحداثيات الذرية، تأخذ المدارات الجزيئية وترسم رسمًا بيانيًا، حيث العقد هي المدارات، والحواف هي مقاييس تشابكها الكمومي. تتيح هذه الخريطة التنبؤ بطاقة الارتباط الإلكتروني القوي، وهو ما يحدد كيفية انكسار الرابطة الكيميائية وما هي الحالة المغزلية التي سيتخذها معقد الفلز.
ينظر أخصائي الأشعة إلى صورة البطن ولا يرى مجرد أعضاء، بل يرى ترتيبها المكاني: أي كلية أكبر، وأين يقع الورم بالنسبة للوعاء الدموي. هذا يشبه قراءة خريطة، حيث لا يكفي أن تعرف أين تقع المدينة عادةً، بل يجب أن تكون قادرًا على قياس المسافة بين نقطتين على الأرض. باحثون من IIIT Hyderabad وAIG Hospitals بنوا SPAR-Bench، وهي ثماني مهام تختبر ما إذا كانت نماذج الرؤية الطبية قادرة على هذا النوع من الاستدلال.
في جليد القارة القطبية الجنوبية، لا يترك الجسيم الشبح وراءه سوى وميض خافت من الضوء الأزرق. يلتقط كاشف IceCube هذه الوميضات، ومن خلالها يجب فهم من أين جاء الجسيم. تعلّم نموذج PolarBERT القيام بذلك، لكن ما يراه بالضبط في الداخل ظل لغزًا.
للنظر إلى الداخل، طبق الباحثون مشفِّرًا ذاتيًا متناثرًا، وهو شبكة عصبية تستخرج عددًا صغيرًا من السمات المهمة من تنشيطات النموذج.
البروتين في الخلية ليس ثابتًا كدمية في واجهة عرض. فذراته تهتز باستمرار، وتتمدد وتنحني — تمامًا كوتر الغيتار المشدود الذي يستمر في الاهتزاز بعد نقرته. لفهم وظيفة البروتين، لا بد من تقدير صلابة الروابط بين أجزائه. يصف الفيزيائيون ذلك عبر مصفوفة المشتقات الثانية للطاقة، لكن يمكن تصورها ببساطة كخريطة «الزنبركات» بين الذرات: حيث يكون الرابط صلبًا وحيث يكون مرنًا.
مهندس البروتينات يشبه طاهياً يحاول أن يجعل الطبق لذيذاً ومفيداً ورخيصاً في نفس الوقت. بتغيير مكوّن واحد، يخاطر بإفساد مكوّن آخر. في السابق، كانت المساعدات الحاسوبية تقيّم خصائص البروتينات بشكل منفصل فقط، دون رؤية كيفية ارتباطها ببعضها البعض.
المترجم الفوري ينشغل بأي صوت في القاعة، فتمتد ساعة الاجتماع إلى ساعتين. وكذلك النماذج التأسيسية الجزيئية: فهي تتعلم لغة الجزيئات من مجموعات ضخمة، لكنها تحتاج إلى ضبط لكل محادثة جديدة. Monroe يغير القواعد: فهو لا يتعلم لغة جديدة، بل يجد المعنى المشترك فورًا من خلال أمثلة قليلة.
البروتين عبارة عن آلة جزيئية بحجم النانو تُفعَّل وتُعطَّل بأمر خارجي. يأتي الأمر عندما يرتبط جزيء آخر بالبروتين، تمامًا مثلما يدخل المفتاح في القفل. يؤدي هذا الارتباط إلى تغيير تكويني (conformational change) في البروتين، وتنتقل الإشارة إلى بقية السلسلة. ومع ذلك، ظل من غير الواضح لفترة طويلة كيف تنتشر الإشارة بالضبط داخل البنية البروتينية.
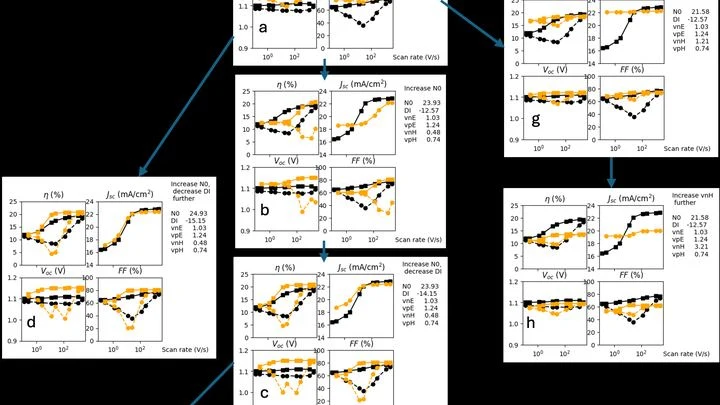
تشبه الخلية الشمسية البيروفسكايتية رياضية شابة: تظهر أداءً مذهلاً في البداية، لكنها تتعب بسرعة. ففي غضون ثماني ساعات فقط، تنخفض كفاءتها بشكل ملحوظ، رغم عدم وجود عيوب ظاهرة — لا شقوق ولا غبار ولا انفصالات.
عندما تدير ببطء مقبض ضبط جهاز راديو قديم، تسمع الصوت يخرج من الضوضاء ليس تدريجيًا بل فجأة — في اللحظة التي يدخل فيها الهوائي في رنين مع الموجة. تقريبًا بنفس الطريقة تتصرف الجينات في الخلية الحية. فهي لا تعمل كصنبور متدفق بسلاسة، بل كمفتاح تبديل بوضعين: «صامت» و«مُذيع».
داخل كل خلية، تلتقي الجزيئات وتفترق باستمرار. بعض الأزواج تتماسك بقوة، مثل شريط لاصق، بينما يتلامس البعض الآخر بالكاد، مثل حبوب اللقاح في مهب الريح. هذه الاتصالات العابرة، التي تقارن قوة تماسكها بطاقة إذابة حبة ملح في كوب ماء، هي التي تتحكم في العديد من الإشارات والقرارات الخلوية.
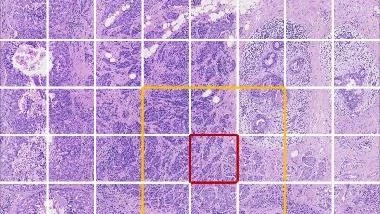
تخيّل أوركسترا ضخمة بلا قائد. كل عازف هو جين (جزء من الحمض النووي يرمز لبروتين أو RNA)، واللحن هو العمل المعقّد للخلية. في السابق، عند النظر إلى صورة نسيج، كان الكمبيوتر يحاول تخمين دور كل آلة على حدة. لم يكن يعلم أن الكمانات تعزف عادةً مع الفيولات، وأن الأبواق تعزف مع الترومبون. كان البرنامج ببساطة يُخرج قائمة من النوتات دون أن يشعر بالتناغم.
البروتين في الخلية ليس قطعة صلبة، بل هو أقرب إلى قفاز مرن يمكنه الإمساك بأشياء مختلفة. حتى الآن، عمل مصممو البروتينات مثل النحاتين، يصنعون مفتاحًا لقفل واحد فقط: هدف واحد، شكل واحد. لكن الحياة أكثر تعقيدًا: أحيانًا نحتاج إلى بروتين يتعرف على فيروسين مختلفين في نفس الوقت، أو يغير شكله اعتمادًا على الجزيئات المجاورة.
الطريقة الجديدة Chamaileon تتعامل مع هذه المهمة.
يشبه الغشاء الحيوي البكتيري مدينة من المخاط. المنازل فيها هي الميكروبات نفسها. الشوارع والجسور هي جزيئات بوليمرية طويلة تفرزها البكتيريا إلى الخارج. هذا البناء بأكمله ليس جامدًا: الجسور تتمزق أحيانًا وتُعاد ربطها من جديد.
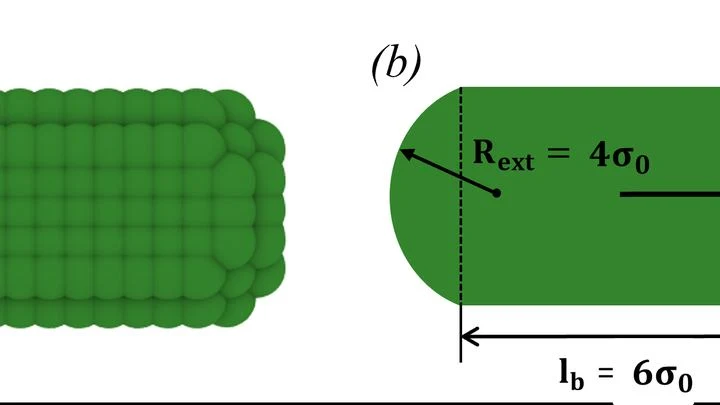
جمع مؤلفو العمل نموذجًا حاسوبيًا "لعبة" لمثل هذه المدينة. فيه كل بكتيريا وكل جزيء-جسر هو جسيم كبير يتحرك وفق قواعد فيزيائية بسيطة.
أربعة خطوط خافتة على الصورة – كل ما يراه الفلكي. هكذا يستعيد النحّات شكل الزجاج غير المرئي من أربعة ظلال. قبل نحو مئة عام، تنبأ ألبرت أينشتاين بها، واقترح فريتز زفيكي استخدام العدسات الثقالية – تلسكوبات طبيعية من المادة المظلمة، تعزز ضوء النوى المجرية النشطة البعيدة بمئات المرات.
ينزلق البروتين على خيط الحمض النووي مثل مفتاح على حلقة مفاتيح، باحثًا عن قفله. أي انعطاف خاطئ، ويبقى الجين معطلاً. لفهم أين سيقبض البروتين بإحكام، يجب قياس قوة هذه القبضة — طاقة الارتباط. لكن استعراض كل المواقع الممكنة يدويًا مستحيل: جينوم الثدييات يتكون من مليارات "الحروف".
في عام 2025، لم تعد النماذج اللغوية الكبيرة مثل GPT مجرد أدوات للدردشة — بل تساعد العلماء في تصميم التجارب. لكن الأداة نفسها قد تقع في أيدي الأشرار. مجموعة من الباحثين بنت ميدانًا رقميًا لاختبار ذلك.
لقد أنشأوا نموذجًا مخترقًا باسم Intern-BioBreaker — وهو بمثابة لص أقفال افتراضي يلتقط مفاتيح لاختراق دفاعات الشبكات العصبية.
مكتبة ضخمة، كل كتاب فيها تعليمات دقيقة لتجميع جزيء بروتين واحد. قرأت الشبكة العصبية AlphaFold2 ملايين من هذه الكتب وتعلمت أن تُخرج فوراً نموذجاً ثلاثي الأبعاد جاهزاً. لكن داخل هذه الشبكة، في «دماغها»، بقي شيء أكبر — ليس مجرد قواعد التجميع، بل أطلس كامل للحركات الممكنة للبروتين، حياته الخفية.
ابتكر الباحثون طريقة للاطلاع على هذا الأطلس.
الذكاء الاصطناعي التقليدي ينظر إلى الصور الطبية كما لو كانت أحجية من قطع غير مألوفة — فهو يعتبر أي صورتين غير متطابقتين مختلفتين تمامًا. هذا أشبه بمحاولة التمييز بين توأمين دون معرفة قرابتهما. أما في الطب، فالمرضى المصابون بنفس المرض يبدون متشابهين تقريبًا في صور الرنين المغناطيسي، فيخطئ الخوارزم ويخلط بين "الأقارب".
الذكاء الاصطناعي الذي يتنبأ بصوتيات قاعة ما يشبه طالباً في امتحان يحفظ الإجابات دون فهم. إذا كانت نقاط الفحص هي نفسها نقاط التدريب، يقوم النموذج ببساطة بحفظ "البصمة" الصوتية لكل موضع – كطالب يتعرف على ورقة الأسئلة من ثنية صغيرة فيها. شَدِّد القواعد – جمِّع البيانات حسب المواقع وأخفِ الدلائل الترددية – وستنهار الدقة من 85% إلى 9–57%.
النماذج التي تحول النص إلى صوت تتقن إعادة إنتاج الأصوات المنفردة، لكنها تحتار عندما يتضمن السيناريو عدة أحداث. على سبيل المثال، وفقًا للسيناريو يأتي رنين الجرس أولاً، ثم خطوات الأقدام، ثم صوت إغلاق الباب. قد يعيد المولد ترتيب الأحداث، فيسمع المستمع خطوات الأقدام قبل رنين الجرس.
وجد الباحثون حلاً غير متوقع: بدلاً من برمجة قواعد معقدة، أخذوا شبكة عصبية 'تفهم' الصوت، وجعلوها مراقبًا صارمًا.
حكّام الكلام الآليون هم خوارزميات تُقيّم النطق والعواطف. لكنهم غالبًا ما يعملون كناقد طعام يُصدر حكمه بعد قراءة القائمة دون تذوّق الطبق. فبدلاً من تحليل الصوت، يتشبث النموذج بالمؤشرات النصية — كما لو كان يحكم على طبق من خلال وصفتها لا مذاقها. أظهرت التجارب أنه إذا قمت ببساطة بتبديل تسجيلين صوتيين، فإن حكم الذكاء الاصطناعي يغيّر درجته، رغم بقاء الصوت كما هو.
أنت تقف تحت الدش: تدير الصمام، والماء إما مثلج وإما حارق. الأنابيب تعيش حياتها الخاصة: الضغط يقفز بشكل غير متوقع، وكأنه أوركسترا متقلبة بلا قائد. وحدة التحكم الجديدة هي نظام تكيفي يتعلم في الزمن الحقيقي: دون نموذج مسبق لشبكة الأنابيب، يضبط نفسه مع ديناميكيتها في دقائق معدودة ويُخرج درجة الحرارة بلطف إلى منطقة الراحة، دون أن يتجاوز حدود الأمان ولو مرة واحدة.
النهج المعياري الحالي لتعلم الذكاء الاصطناعي يشبه طفلًا محبوسًا في مكتبة: يتذكر ملايين الكتب، لكنه لا يعلم أن النار تحرق، وأن السقوط يسبب الألم. أدمغتنا، المبنية من الكربون ومواد بسيطة أخرى، تعمل بطريقة مختلفة: أولاً يستكشف الجسد العالم من خلال الحركات واللمسات والأخطاء، وعندها فقط تكتسب الكلمات معناها.
الدماغ يتحدث عبر طقطقات كهربائية قصيرة. في السابق، لتعلم هذه اللغة، كانت هناك حاجة إلى آلاف الأمثلة المترجمة من قبل المجرِّب. طريقة MOJO تسلك مسارًا مختلفًا: كما يحدث عند تعلم لغة عن طريق الانغماس، فهي أولاً 'تستمع' إلى 'تيار الوعي' دون أي تلميحات وتجد بنفسها الأنماط المتكررة.
في قدر الحساء، يكفي مقياسا حرارة لمعرفة درجة الحرارة في كل مكان — إذا عرفنا أن الحرارة تسري في دوائر من القاع. وهكذا في العلم: بقياسات قليلة، ينبغي استعادة الصورة الكاملة لحقل الحرارة.
النظام يلتقط جوهر العمليات الحرارية، بضغطها في بضعة أرقام - قواعد. كما يعرف الطبّاخ أن الحساء أشد سخونة في الوسط.
خلايا الكائن الحي الواحد تشبه توأمًا من الخبازين يعملان في مطبخ مشترك وفق كتاب وصفات واحد — جزيء الحمض النووي. ومع ذلك، أثناء النسخ (نسخ الوصفة إلى جزيئات الرنا المرسال — "أوراق الغش") والترجمة اللاحقة (تجميع البروتينات وفق هذه التعليمات) تنشأ حتمًا تقلبات عشوائية.
السائق على طريق زلق لا يعرف كيف ستستجيب السيارة لعجلة القيادة، فيتعلم أثناء القيادة تاركاً هامشاً للخطأ. على نحو مماثل، تتصرف خوارزمية التحكم الذكية. فبدلاً من المطالبة بنموذج دقيق، تجمع البيانات بشكل فوري، وتقدّر عدم اليقين والتشويشات الخارجية، وكأن الصندوق الأسود يكشف عن إعداداته تدريجياً.
تقييم جودة الصورة مهمة تحتاج إلى مفتش دقيق يحمل مجموعة من الأدوات. شبكة IQA-T1 العصبية تتصرف تمامًا هكذا: فهي لا تكتفي بالتحديق في الصورة، بل تستخدم تارة مطيافًا وتارة مقياس إضاءة. الضوضاء الرقمية، مثل تموجات على سطح الماء، تخفي العيوب، لكن تحليل الترددات — مطيافية الصورة — يكشف فقدان الوضوح.
من الملائم تمثيل الإشارة الصوتية بعدد مركب: معامله (السعة) يعكس شدة الصوت، ووسيطه (الطور) يحدد موضع الموجة في الزمن وإزاحتها اللحظية. الشبكات العصبية التقليدية تقسم هذا الوصف الموحد إلى إحداثيين مستقلين – ببساطة، تحدد عنوانًا في شبكة ديكارتية: «خطوتان شرقًا وخطوة شمالًا».
تقليديًا، تعمل خوارزميات التعلم الآلي في بيئة ثابتة، تمامًا مثل الماء الذي يتدفق في مجرى محفور مسبقًا دون أن يغير شكله. الطريقة الجديدة تقلب هذا النموذج رأسًا على عقب: فهي تسمح للوكيل بأن يتعلم الأفعال ويغير البيئة التي يعيش فيها بشكل هادف في الوقت نفسه. تخيل جدولًا لا ينساب فقط إلى أسفل المنحدر، بل يعمل بنشاط على تآكل التربة الرخوة، شاقًا طريقه بشكل أقصر وأكثر كفاءة.
في غرفة صاخبة، يميز الإنسان الصوت المطلوب بفضل الأذنين اللتين تلتقطان الفرق في وصول الصوت. يعمل الكمبيوتر المزود بعدة ميكروفونات بالطريقة نفسها: يحصل على تلميحات مكانية — من أين يتحدث كل شخص.
في السابق، كانت هذه التلميحات تُستخدم للتركيز على اتجاه واحد، مثل شعاع المصباح. لكن عند تداخل الأصوات، كان التركيز يتشتت ويُفقد جزء من الإشارة — كما لو كنا نحاول رؤية ممثلَين في نفس شعاع الكشاف دفعة واحدة.
يتطلب تحضير طبق معقد وصفة دقيقة: اِبدأ بالتقطيع، ثم القلي، وأضف التوابل في الوقت المناسب. التحولات الكيميائية أيضاً تسير وفق وصفات خطوة بخطوة — آليات تعيد فيها ذرات الكربون والهيدروجين ترتيب نفسها بترتيب صارم.
في السابق، كانت الشبكات العصبية غالباً ما تختلق خطوات غير موجودة، مثل طباخ خيالي يستبدل الملح بالسكر.
أنظمة الطاقة المزودة بألواح شمسية وتوربينات الرياح تُشبه مباراة شطرنج: الغيوم وتغيّر الأحمال هي تحركات الخصم التي لا يمكن توقعها. للحفاظ على التوازن، كان المُشغّلون سابقاً يستعرضون عشرات السيناريوهات (عدم اليقين)، مما كان يتطلب وقتاً وحسابات كثيرة جداً.
الخوارزمية الجديدة تعمل مثل أستاذ كبير في الشطرنج: فهي لا تكتفي بحساب الخيارات، بل تُقسّم رقعة الشطرنج إلى أجزاء مستقلة وتحلّلها في آنٍ معاً.
عندما تكتب "سلطة" وتقترح لوحة المفاتيح الذكية "قيصر"، خلف الكواليس تتعلم ملايين الهواتف معًا التنبؤ بالكلمات. إنها لا تتبادل رسائلك، بل فقط تحسينات الخوارزمية المشتركة — مثل مدرب يرسل للرياضيين فقط التغييرات في خطة التدريب: "أضف 5 تمارين ضغط إلى برنامج الأمس".
الشبكة العصبية التي تولد الأصوات من النصوص تشبه مطبخاً يحضّر فيه عشرات الطهاة كل «طبق». كثير منهم لا يضيفون شيئاً سوى الإشارات الخاطئة وإهدار الموارد. أجرى العلماء مراجعة: باستخدام مطيافية (تحليل طيف المعلمات) حددوا من هو ضروري حقاً، واستغنوا عن الزائدين — بإزالة الوصلات غير المفيدة. بعد هذا التنظيف، تخلص النموذج من 83% من معلماته وأصبح يعمل أسرع بنسبة 39%.
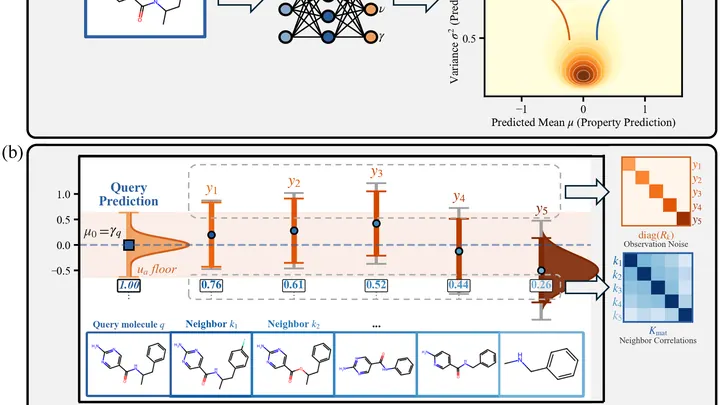
توقّع خصائص جزيء جديد يشبه تخمين طعم طبق غير مألوف. يعمل البرنامج كطاهٍ خبير: «يتذوق» جزيئات مماثلة معروفة الخصائص، وبناءً على «مذاقها» يُنقِّح تخمينه. على سبيل المثال، بالنسبة لـ ماء أو ثاني أكسيد الكربون، تجد الخوارزمية نظائر مدروسة وتُصحِّح درجة الغليان أو الذوبانية.
لا يكتفي الطاهي بنسخ الجيران، بل يُقيِّم مدى ثقته بتنبؤه الذاتي.