شبكة عصبية تتعلم المناخ من ثلاثة دفاتر ✛
طالب حلّ مسائل من كتب الآخرين لسنوات، فجأة يحصل على ثلاثة دفاتر تحتوي ملاحظات حقيقية عن المحيط. المسائل قليلة، لكنه شاهد مئات المسائل المشابهة من قبل، والآن يكفيه مثالان ليلتقط أسلوب المعلم الجديد. هكذا تتعلم نماذج الانتشار (Diffusion Models)، وهي شبكات عصبية تتعلم إزالة الضوضاء من البيانات، مناخ المحيط الهادئ حيث تحل المرحلة الدافئة (النينيو) محل المرحلة الباردة (النينيا) وتتحكم في طقس الكوكب.
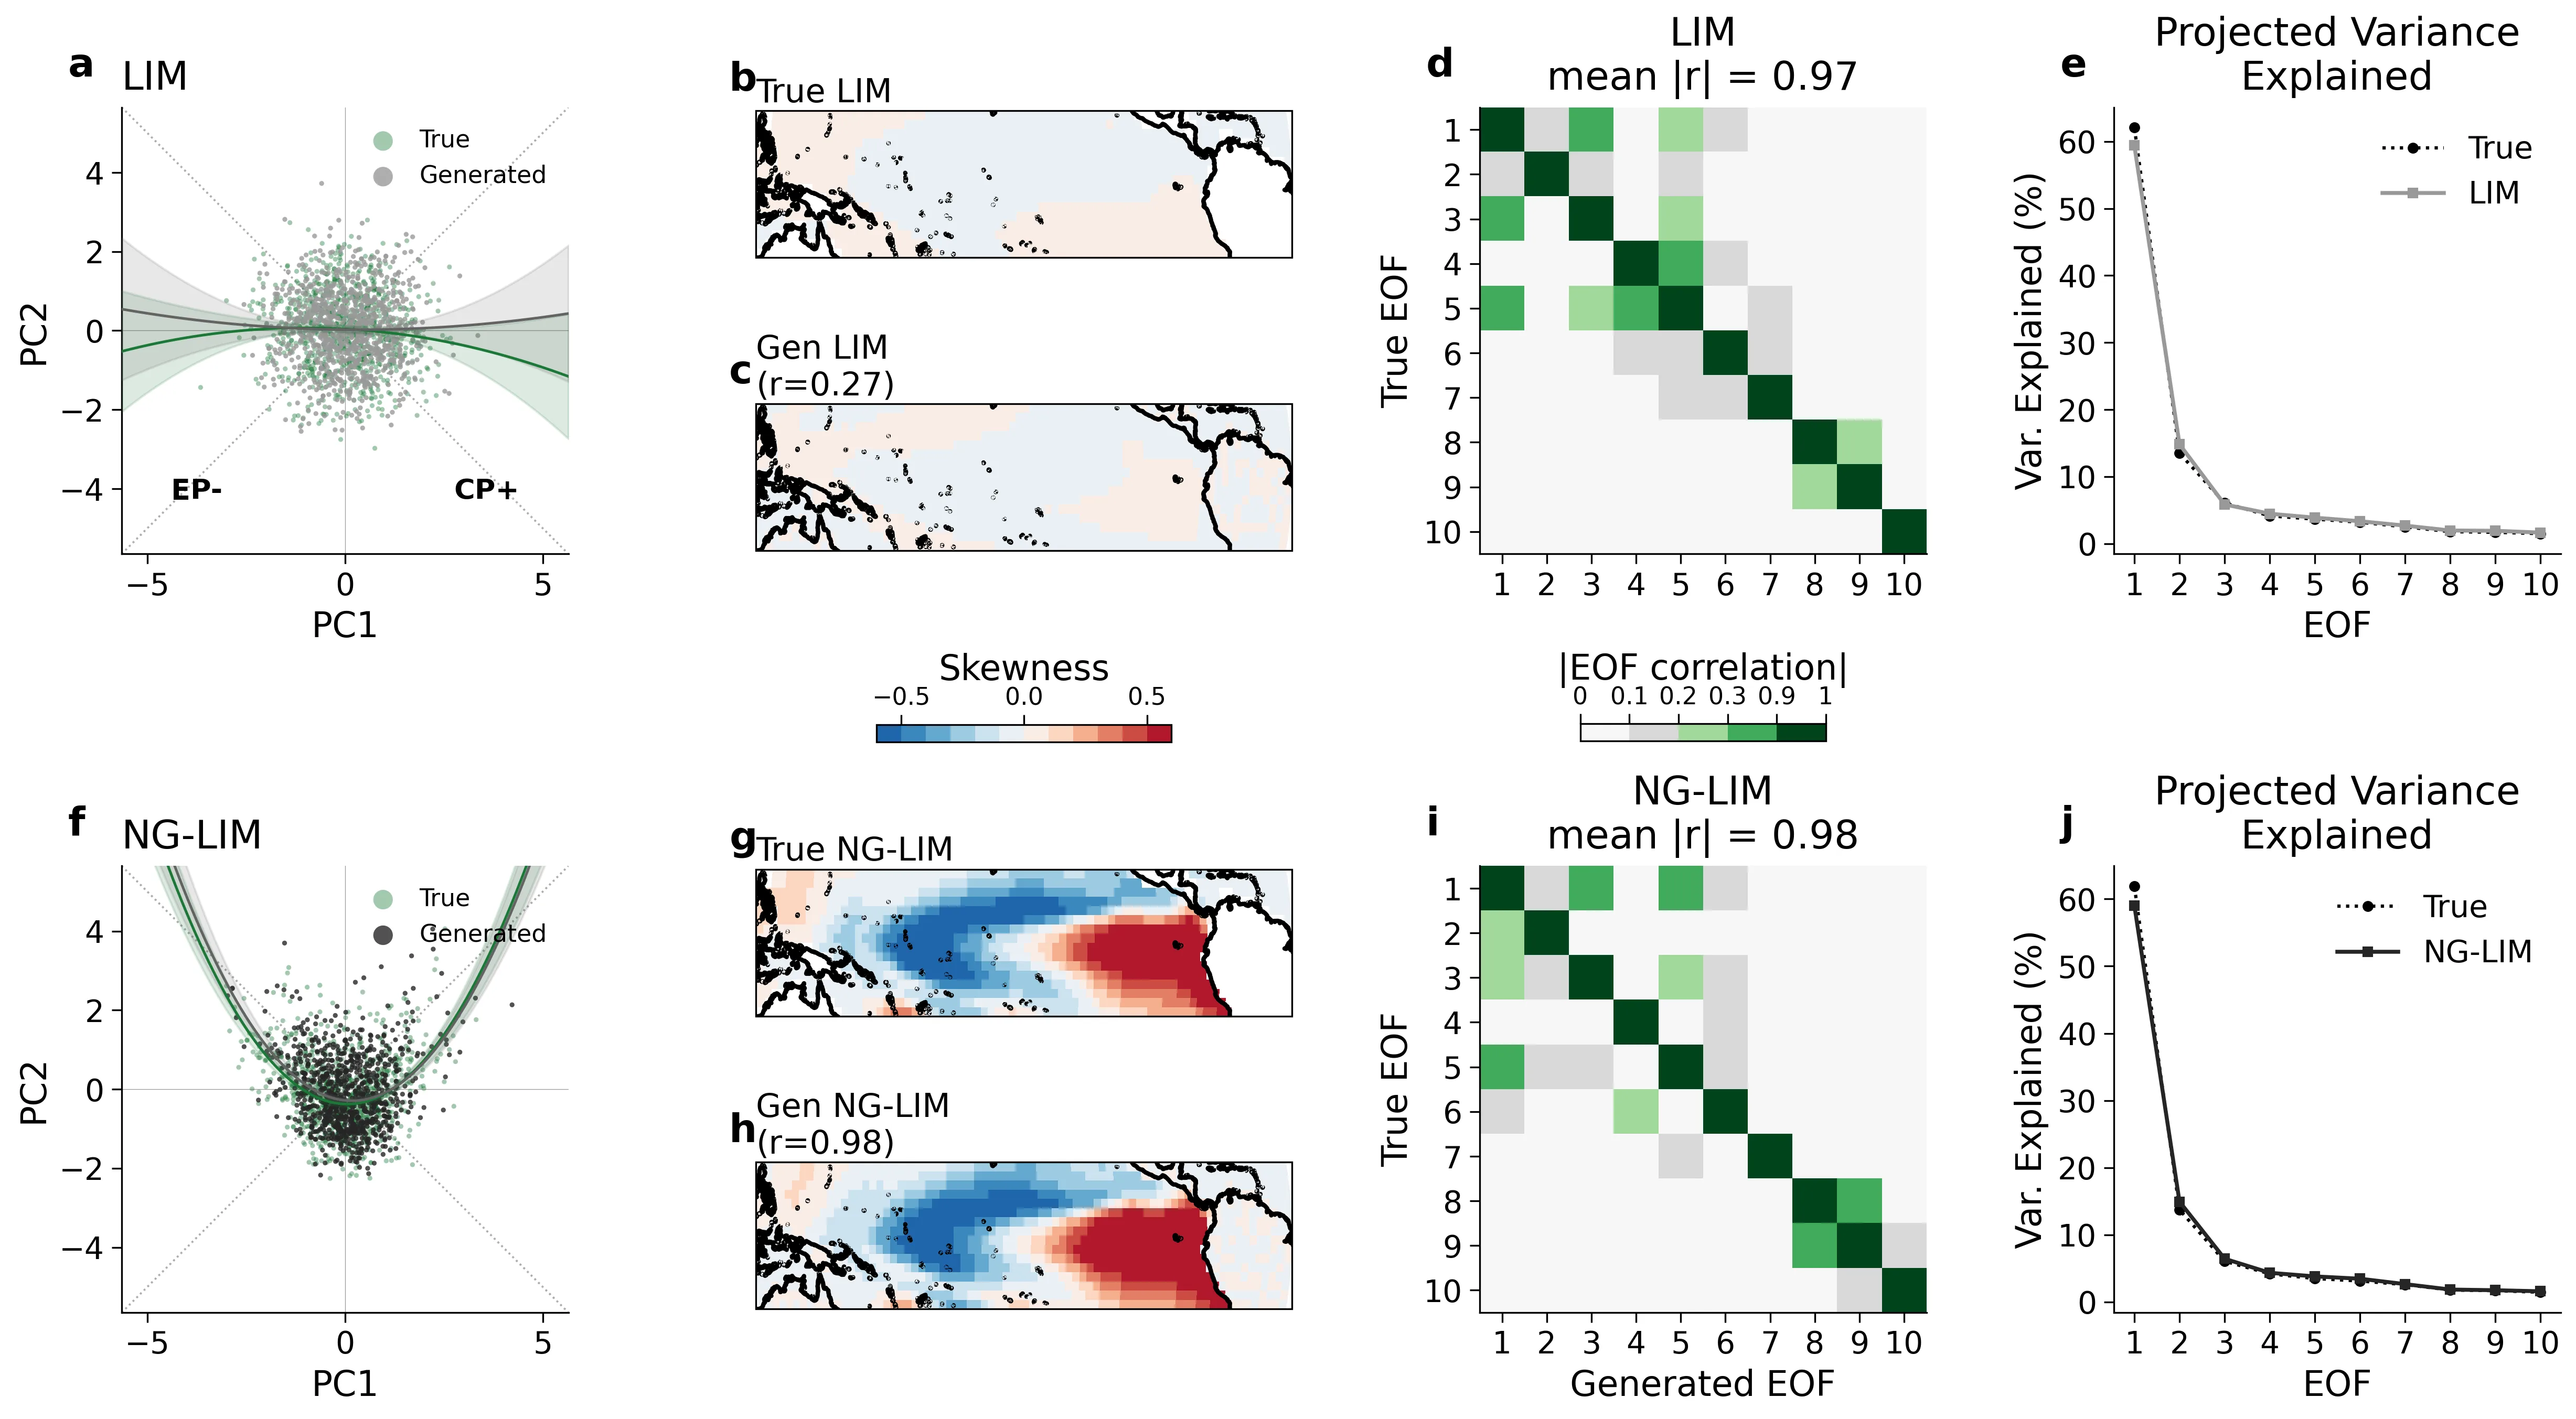
المشكلة أن قياسات درجة حرارة سطح المحيط عبر الأقمار الصناعية والعوامات بدأت فقط في منتصف القرن العشرين. خلال هذه الفترة، تراكمت حوالي 720 خريطة شهرية متوسطة، بينما تحتاج الشبكات العصبية ذات الملايين من المعاملات عادةً إلى آلاف الأمثلة. للتحقق بصدق مما تعلمته النماذج بالضبط، أنشأ المؤلفون ساحة اختبار: ولّدوا 120 ألف حقل اصطناعي ببنية معروفة. على هذه البيانات، أعاد النموذج إنتاج التباين المتماثل وغير المتماثل التباين بدقة، لكن عندما قُصّت العينة إلى الحجم الحقيقي، بدأ في حفظ أمثلة التدريب بدلاً من التعميم.
الحل جاء من طبيعة التعلم نفسها. أولاً، دُرّب النموذج مسبقًا على الحقول الاصطناعية من 30 نموذجًا مناخيًا من مشروع CMIP6، مع إضافة متجه ثماني الأبعاد إلى البنية يشفر هوية كل نموذج. ثم، على 720 ملاحظة حقيقية، دُرّب هذا المتجه فقط. هذا النهج حقق ارتباطًا للأنماط أعلى من 0.85 وارتباطًا لعدم التماثل أعلى من 0.9، متجاوزًا النماذج الخطية الكلاسيكية. الطالب الذي تدرّب على عوالم افتراضية متعددة يتقن العالم الحقيقي الوحيد من خلال أمثلة قليلة.
نماذج الانتشار، التي تولد الآن وجوهًا ومناظر طبيعية واقعية، كانت مستوحاة في الأصل من الديناميكا الحرارية غير المتوازنة، وهي علم كيفية انتقال الأنظمة من النظام إلى الفوضى. في هذا العمل، طُبّق المبدأ نفسه بشكل معاكس لاستعادة البنى المنظمة للمناخ من الضوضاء.
فكرة تدريب آلة على عوالم افتراضية متعددة ثم ضبطها على العالم الحقيقي الوحيد تذكرنا بقصة تيد تشانغ "قصة حياتك"، حيث تتعلم لغوية لغة الكائنات الفضائية بالاعتماد على قواعد نحوية افتراضية متعددة لفهم القاعدة الحقيقية الوحيدة.