يحدث الإفراط في التلاؤم عندما يصف النموذج الإحصائي الخطأ العشوائي أو الضوضاء بدلاً من العلاقة الأساسية. يؤدي النموذج أداءً جيدًا على بيانات التدريب لكنه ضعيف على البيانات الجديدة غير المرئية. هذه مشكلة مركزية في التعلم الآلي والإحصاء، حيث أن الهدف هو بناء نماذج تعمم، وليس مجرد حفظ.
التاريخ
عُرف هذا المفهوم منذ الأيام الأولى للإحصاء وملاءمة المنحنيات. أصبح مصطلح 'الإفراط في التلاؤم' بارزًا في ستينيات وسبعينيات القرن العشرين مع ظهور الشبكات العصبية وأشجار القرار.
كيف يعمل
يمكن للنماذج ذات المرونة العالية (مثل تلك التي تحتوي على العديد من المعاملات) أن تلائم بيانات التدريب بشكل شبه مثالي، بما في ذلك خصائصها الفريدة. عندما يكون النموذج معقدًا جدًا مقارنة بكمية البيانات، فإنه يلتقط أنماطًا زائفة غير موجودة في المجتمع الحقيقي. يؤدي هذا إلى تباين عالٍ: تغييرات صغيرة في مجموعة التدريب تسبب تغييرات كبيرة في النموذج. تُستخدم تقنيات مثل التحقق المتقاطع والتنظيم والتقليم لكشف ومنع الإفراط في التلاؤم.
في التطبيق
في النمذجة التنبؤية، يُعد الإفراط في التلاؤم مصدر قلق دائم. يستخدم الممارسون مجموعات التحقق والتنظيم لضمان بقاء النماذج مثل تلك المستخدمة في تسجيل الائتمان أو التشخيص الطبي موثوقة مع المرضى الجدد.
حقيقة طريفة
النموذج الذي يحفظ بيانات التدريب تمامًا (مثل جدول بحث) لديه خطأ تدريب صفري لكنه عادةً ما يؤدي أداءً لا يختلف عن التخمين العشوائي على البيانات الجديدة—وهذا مثال كلاسيكي على الإفراط في التلاؤم.
خريطة الكنز التي ترسمها الشبكة العصبية تعد بإظهار مكان دفن الذهب. ولكن إذا نُقلت الخريطة إلى جزيرة أخرى، فقد تشير العلامات إلى الفراغ. هذا بالضبط ما حدث مع تفسيرات النموذج الذي يقيس النبض من تسجيل الفيديو للوجه.
تلتقط الشبكة العصبية RhythmFormer التغيرات الطفيفة في لون الجلد الناتجة عن نبضات القلب.
تخيّل أنك تحاول فهم ما حدث في غرفة ما من خلال الصدى الذي تبقى بعد إطلاق رصاصة. لم يعد هناك رصاصة، لكن الصدى ما زال يتردد في الجدران. هذا تقريبًا ما يفعله أخصائي علم الأمراض العصبية عندما ينظر إلى شريحة من نسيج دماغي لا تحتوي على الورم نفسه: فالخزعة أخذت فقط نسيجًا سليمًا استجاب للمرض.
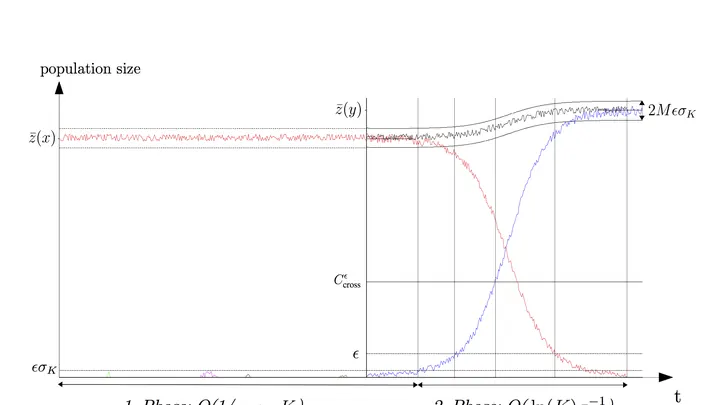
عداءان يبدآن سباقًا على مضمار يتغير ميله. أحدهما ينطلق مبكرًا والآخر متأخرًا، والحكم يقيس سرعتيهما دون أن يعلم بفارق الانطلاق. هكذا الحال مع المتحورات الفيروسية: البيانات عنها تصل بتأخيرات، وإذا لم تكن هذه التأخيرات متساوية، فقد يكون تقدير الأفضلية التنافسية خاطئًا بشكل فادح.
في علم الأحياء التطوري، تُقدَّر الأفضلية غالبًا من ميل منحنى اللوجيت لتردد النوع الغازي.
تخيل مستودعًا به صناديق من التفاح والكمثرى. التفاح كثير، والكمثرى قليل. ولكن عندما يقول أمين المستودع «فاكهة ذات قشرة ناعمة»، فإننا نتذكر غالبًا الكمثرى النادرة بدلًا من التفاح الشائع. هذا مظهر من مظاهر تأثير المعدل الأساسي العكسي (inverse base-rate effect) — وهو انحياز معرفي مستقر يجعل الدماغ، عند حل الغموض بين الفئات، يبالغ بشكل منهجي في تقدير الخيارات النادرة على حساب الشائعة.
مائة ألف نجم في النواة المزدحمة لعنقود نجمي كروي تتحرك ككرات فولاذية في آلة بينبول عملاقة. كل «دفعة» — لقاء ثقالي بين نظام مزدوج ونجم منفرد — تشعل سلسلة من الأحداث غير المتوقعة. قد يتفرق الزوجان، وقد يُزيح النجم الدخيل أحد الشريكين ويحتل مكانه، وأحياناً يعلق الثلاثة في رقصة هرمية معقدة.
يتدفق التطور كالماء. ففي النهر الواسع تكون التغيرات سلسة وبطيئة، بينما يهدر الجدول الجبلي عند كل حجر. حجم الجماعة وتواتر الطفرات يحددان المجرى: واسعًا وهادئًا أم ضيقًا ومليئًا بالمنحدرات.
التعلم الآلي لم يعد مجرد أداة — بل أصبح مستكشفاً، يستخلص قوانين الطبيعة من البيانات بنفسه. ولكن كيف يتوصل العقل السليكوني إلى الفهم؟ للإطلاع على هذه العملية، لجأ الفيزيائيون إلى نموذج صغير لكنه عميق — شبكة إيزينج، حيث تتراقص اللفات المغزلية تحت إملاء درجة الحرارة.
الإشارات الثقالية الصادرة عن النجوم الضخمة المحتضرة هي همسات تصل إلينا من أقسى مختبرات الكون. تنبأ أينشتاين بهذه الموجات الثقالية قبل أكثر من قرن، لكننا اليوم، ومع كواشف مثل LIGO، بدأنا نسمعها.
60 فأرًا، 1980 عينة، 234 مريضًا بسرطان الرئة. خلف كل رقم آلاف الجينات. يُقاس نشاطها لفهم المرض. لكن البيانات ليست متجانسة: بالنسبة لمريض واحد يتم تقييم مستوى البروتين (رقم متصل)، وإعطاء تشخيص (نعم/لا)، وتحديد النوع الفرعي للورم (فئة). دمجها في نموذج واحد كجمع درجات الحرارة المئوية مع الكيلومترات. المتخصصون في التعلم الآلي يضبطون أوزان الأخطاء يدويًا لكل مهمة.
النماذج الإحصائية هي محاولة لمد شبكة رياضية مثالية على تضاريس البيانات غير المنتظمة. عندما يقاوم النموذج، يصدر توترًا، لكننا اعتدنا تجاهله. يقضي الباحثون ساعات محدقين في رسوم البواقي محاولين تخمين حيث يبدأ النموذج في "التفكك". سكويلر يحوّل هذه المقاومة إلى صوت. لم تعد تنظر إلى منحنًى — بل تسمع صريره عندما يُجبر على الانصياع لنقاط بعينها.
طالب حلّ لسنوات مسائل من كتب الآخرين المدرسية، يجد فجأة ثلاثة دفاتر تحتوي على ملاحظات حقيقية عن المحيط. عدد المسائل قليل، لكنه شاهد مئات المسائل المشابهة من قبل، والآن تكفيه بضعة أمثلة ليلتقط أسلوب المعلم الجديد.
في ملعب كرة القدم، تنشأ مشاعر الجمهور من أحاديث المشجعين الأفراد. لو كان باستطاعة المزاج أن يكون فرحًا وحزينًا في آنٍ واحد، لتشكل تراكب كمومي. لكن همسات آلاف الأصوات تُحيل هذا المزيج فورًا إلى حالة واحدة محددة.
تدريب نموذج دقيق للديناميكا الهوائية يشبه فن الطهي: أولاً يتعلم الطاهي مئات الوصفات لاستيعاب المبادئ العامة، ثم يتقن بسهولة طبقاً معيناً. المهندسون صمموا AeroTransformer — بنية شبكة عصبية دُرِّبت على مجموعة بيانات ضخمة — و"أطعموها" 30 ألف شكل جناح مختلف، مجرة كاملة من أفكار الطهي مجرة.
نواة اليورانيوم تشبه محفظة مشدودة مقفلة على نصفين. لكي تنفجر وتطلق الطاقة – أي لكي تنقسم النواة – يجب تجاوز حاجز الطاقة. ارتفاع هذه العتبة يحدد ما إذا كانت المادة مستقرة أم عرضة للتفكك في أي لحظة. ظل الفيزيائيون لعقود يحسبونها بالمعادلات، لكن بالنسبة لأكثر النوى تقلباً – شديدة الاستطالة، ذات عدد غير معتاد من الجسيمات – كانت الحسابات كاذبة.
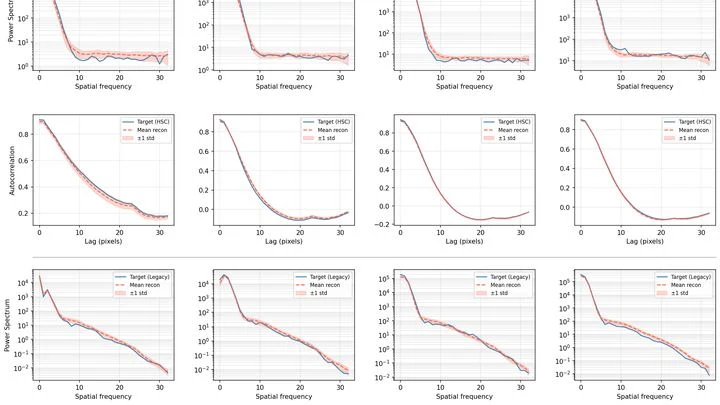
إذا صوّرتَ الجبل نفسه بكاميرا فيلمية وبالهاتف الذكي الحديث، فستحصل على صورتين مختلفتين: في إحداهما تكون الألوان أكثر إشراقًا، وفي الأخرى تكون التفاصيل غير واضحة. وكذلك الأمر مع التلسكوبات: فكل أداة ترى السماء بطريقتها الخاصة، مضيفةً إلى الضوء الحقيقي للمجرات تشوهاتها الخاصة — مثل مرشح ننظر من خلاله.
ويقدم العمل الجديد طريقة لإزالة هذا "المرشح".
الحاسوب الكمومي يشبه أوركسترا يعزف فيها كل موسيقي دوره الخاص. إذا أخطأ قائد الأوركسترا، تتدمر الموسيقى. في المحاكاة الكمومية الرقمية، يقوم قائد الأوركسترا بدور تسلسل العمليات البسيطة، وتتراكم الأخطاء مثل النغمات الخاطئة. لكن في بعض الأحيان تعزف الأوركسترا بشكل نقي حتى لو لم يكن قائدها مثاليًا.
وجد مؤلفو المقالة تفسيرًا لهذا الحظ.
يبدو التدفق المضطرب للماء في أنبوب واهتزازات البندول مختلفين. لكن بينهما قاسم مشترك: كلاهما يخضع لقوانين حركة خاصة يمكن وصفها بالأرقام. شبكة عصبية تدرّبت على واحدة فقط من هذه «رقصات الأرقام» تبدأ فجأة في فهم الأخرى — دون أي مثال إضافي. هذا مثل موسيقي تعلم لحنًا واحدًا، ثم يعزف مقطوعة غير مألوفة من النظرة الأولى بعد أن يلتقط تناغمها.
يمكن تشبيه الشبكة العصبية بسكن جامعي، حيث يحصل كل قاطن على غرفته الخاصة. عادةً، تشغل كل علامة في البيانات خلية عصبية منفصلة، ويتم التعلّم بالتتابع: أولاً علامة، ثم أخرى. هذا بطيء ويعتمد على البيانات المتاحة.
لكن إذا سمحنا لعدة علامات بالسكن في غرفة واحدة — أي تداخلها فوق بعضها — يتغيّر المشهد. بنى العلماء نموذجًا بسيطًا «معلّم-تلميذ» واستخرجوا معادلات للتعلّم دون تداخل.