ماسح طبي ثلاثي الأبعاد يتعلم رؤية كل شيء دفعة واحدة سريع
لنقل شكل تمثال بأدق التفاصيل، يمكن تقسيمه إلى ملايين المكعبات الصغيرة ووصف كل منها — وهذا طويل وشاق، وتتفتت ذاكرة الحاسوب تحت الضغط. هكذا تُعالج عادةً الصور الطبية ثلاثية الأبعاد: التصوير المقطعي المحوسب أو الرنين المغناطيسي عبارة عن مصفوفة ضخمة من هذه المكعبات (فوكسلات)، ولكي تُنشئ الصورة أو تحسّنها، على الآلة أن تقلبها جميعًا.
النهج الجديد يشبه عمل نحّات لا يشكّل قطعة قطعة، بل يرسم انحناءات انسيابية بخط رياضي واحد. أنشأ الباحثون نظامًا يصف الحجم بأكمله — الكبد أو الدماغ أو الرئتين — كدالة مستمرة التعلم العميق في التصوير الطبي للإحداثيات. يكفي إدخال ثلاثة أرقام (x, y, z) في المعادلة، فيخبرنا النموذج بكثافة الأنسجة في تلك النقطة. قلب الطريقة هو مُرمّز ذاتي مضغوط: يضغط الصورة أولًا إلى مجموعة صغيرة من السمات الأساسية (مثل ملاحظات محاضرة)، ثم يعيد بناءها، لكن ككائن مستمر. هذه الحيلة تتيح تجنب تقطيع الصورة إلى أجزاء متداخلة، وهو ما كان حتميًا في السابق.
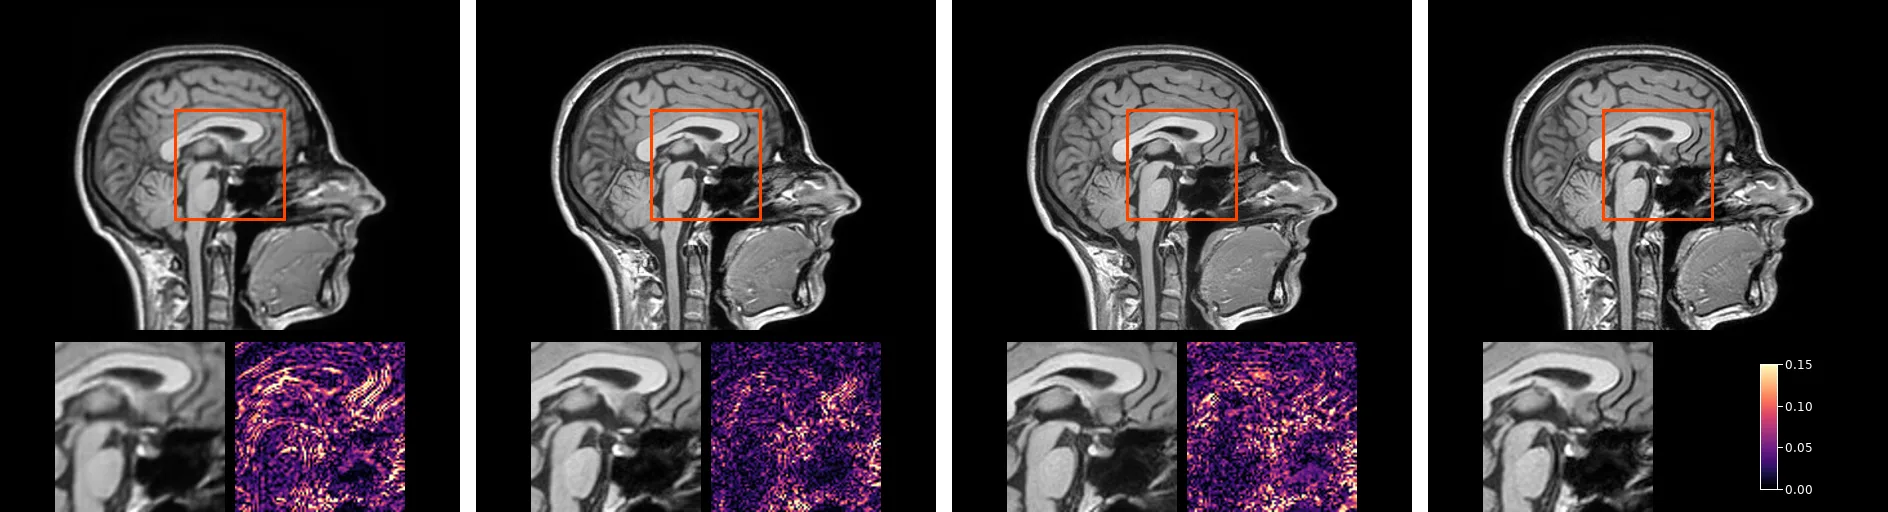
الفائدة العملية تظهر في سيناريوهين. الأول: إنشاء صور ثلاثية الأبعاد اصطناعية لكنها واقعية تشريحيًا لتدريب الأطباء أو الخوارزميات. الثاني: استعادة صورة عالية الجودة من بيانات غير مكتملة. مثلًا، في التصوير بالرنين المغناطيسي المتسارع، يجري الجهاز قياسات أقل ليقلّ مكوث المريض داخل الأنبوب، والنموذج يكمل الناقص بالاعتماد على «التشريح المستمر» الذي تعلّمه. وكل هذا على بطاقة رسوميات واحدة عادية، دون تجميع الصورة من رقع بدرزات ظاهرة.
بالطبع، الاستعادة المباشرة بكسلًا بكسل ما تزال أدق قليلًا في التفاصيل. لكن الكسب في السرعة وسلامة الصورة هو ذلك الحل الوسط الذي يفتح الطريق لمعالجة صور ثلاثية الأبعاد عالية الدقة في الممارسة السريرية الروتينية، دون انتظار الحواسيب الخارقة. وعندها، التمثال الذي جُمّع يومًا من مكعبات، سيحصل أخيرًا على ملامح انسيابية حيّة.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2607.16491
High-resolution three-dimensional (3-D) medical diffusion models remain constrained by the cost of processing full volumes, even when denoising is performed in a compact latent space. We introduce a continuous 3-D latent diffusion model (LDM) framework for computed tomography (CT) and magnetic resonance imaging (MRI) generation and measurement-guided reconstruction. Its central component is a compact autoencoder (AE) with a coordinate-conditioned local implicit image function (LIIF) decoder that represents a volume as a continuous function of spatial coordinates. By evaluating the convolutional decoder once on the latent grid and restricting repeated computation to a lightweight implicit head, the proposed design avoids overlapping sub-volume decoding while remaining differentiable for inverse-problem optimization. We evaluate the framework on CT volumes of 512^3 voxels and MRI volumes of 256^3 voxels. On high-resolution CT, the proposed AE is approximately x12-32 faster than the evaluated reference autoencoders, achieves the lowest peak graphics processing unit (GPU) memory use, and retains comparable structural fidelity despite a moderate reduction in voxel-level accuracy. The resulting frozen 3-D latent prior generates coherent full volumes without visible patch seams and can be applied, without task-specific retraining, to sparse-view CT and accelerated MRI reconstruction through hard data consistency. Although direct pixel-domain reconstruction remains more accurate, the results demonstrate that a single volumetric latent prior can support both unconditional generation and measurement-conditioned reconstruction on one GPU. Overall, the framework provides a practical trade-off between continuous volumetric decoding, computational efficiency, and fine-detail preservation. Our code will be made available at https://github.com/mellak/.
حجم صورة التصوير المقطعي المحوسب النموذجية عالية الدقة (512×512×512 فوكسلات) يعادل 134 مليون بكسل — أي ما يقارب 17 إطارًا بدقة 4K معبأة في مكعب واحد.
في فيلم «تذكر كل شيء» (Total Recall)، يمر بطل الفيلم أرنولد شوارزنيجر عبر ماسح ضوئي ينشئ فورًا نسخة ثلاثية الأبعاد هولوغرامية لجسده — النموذج الجديد يخطو خطوة نحو جعل هذا النوع من إعادة البناء أمرًا روتينيًا، لا خيالًا علميًا.