مرشد إلكتروني للرؤية الاصطناعية سريع
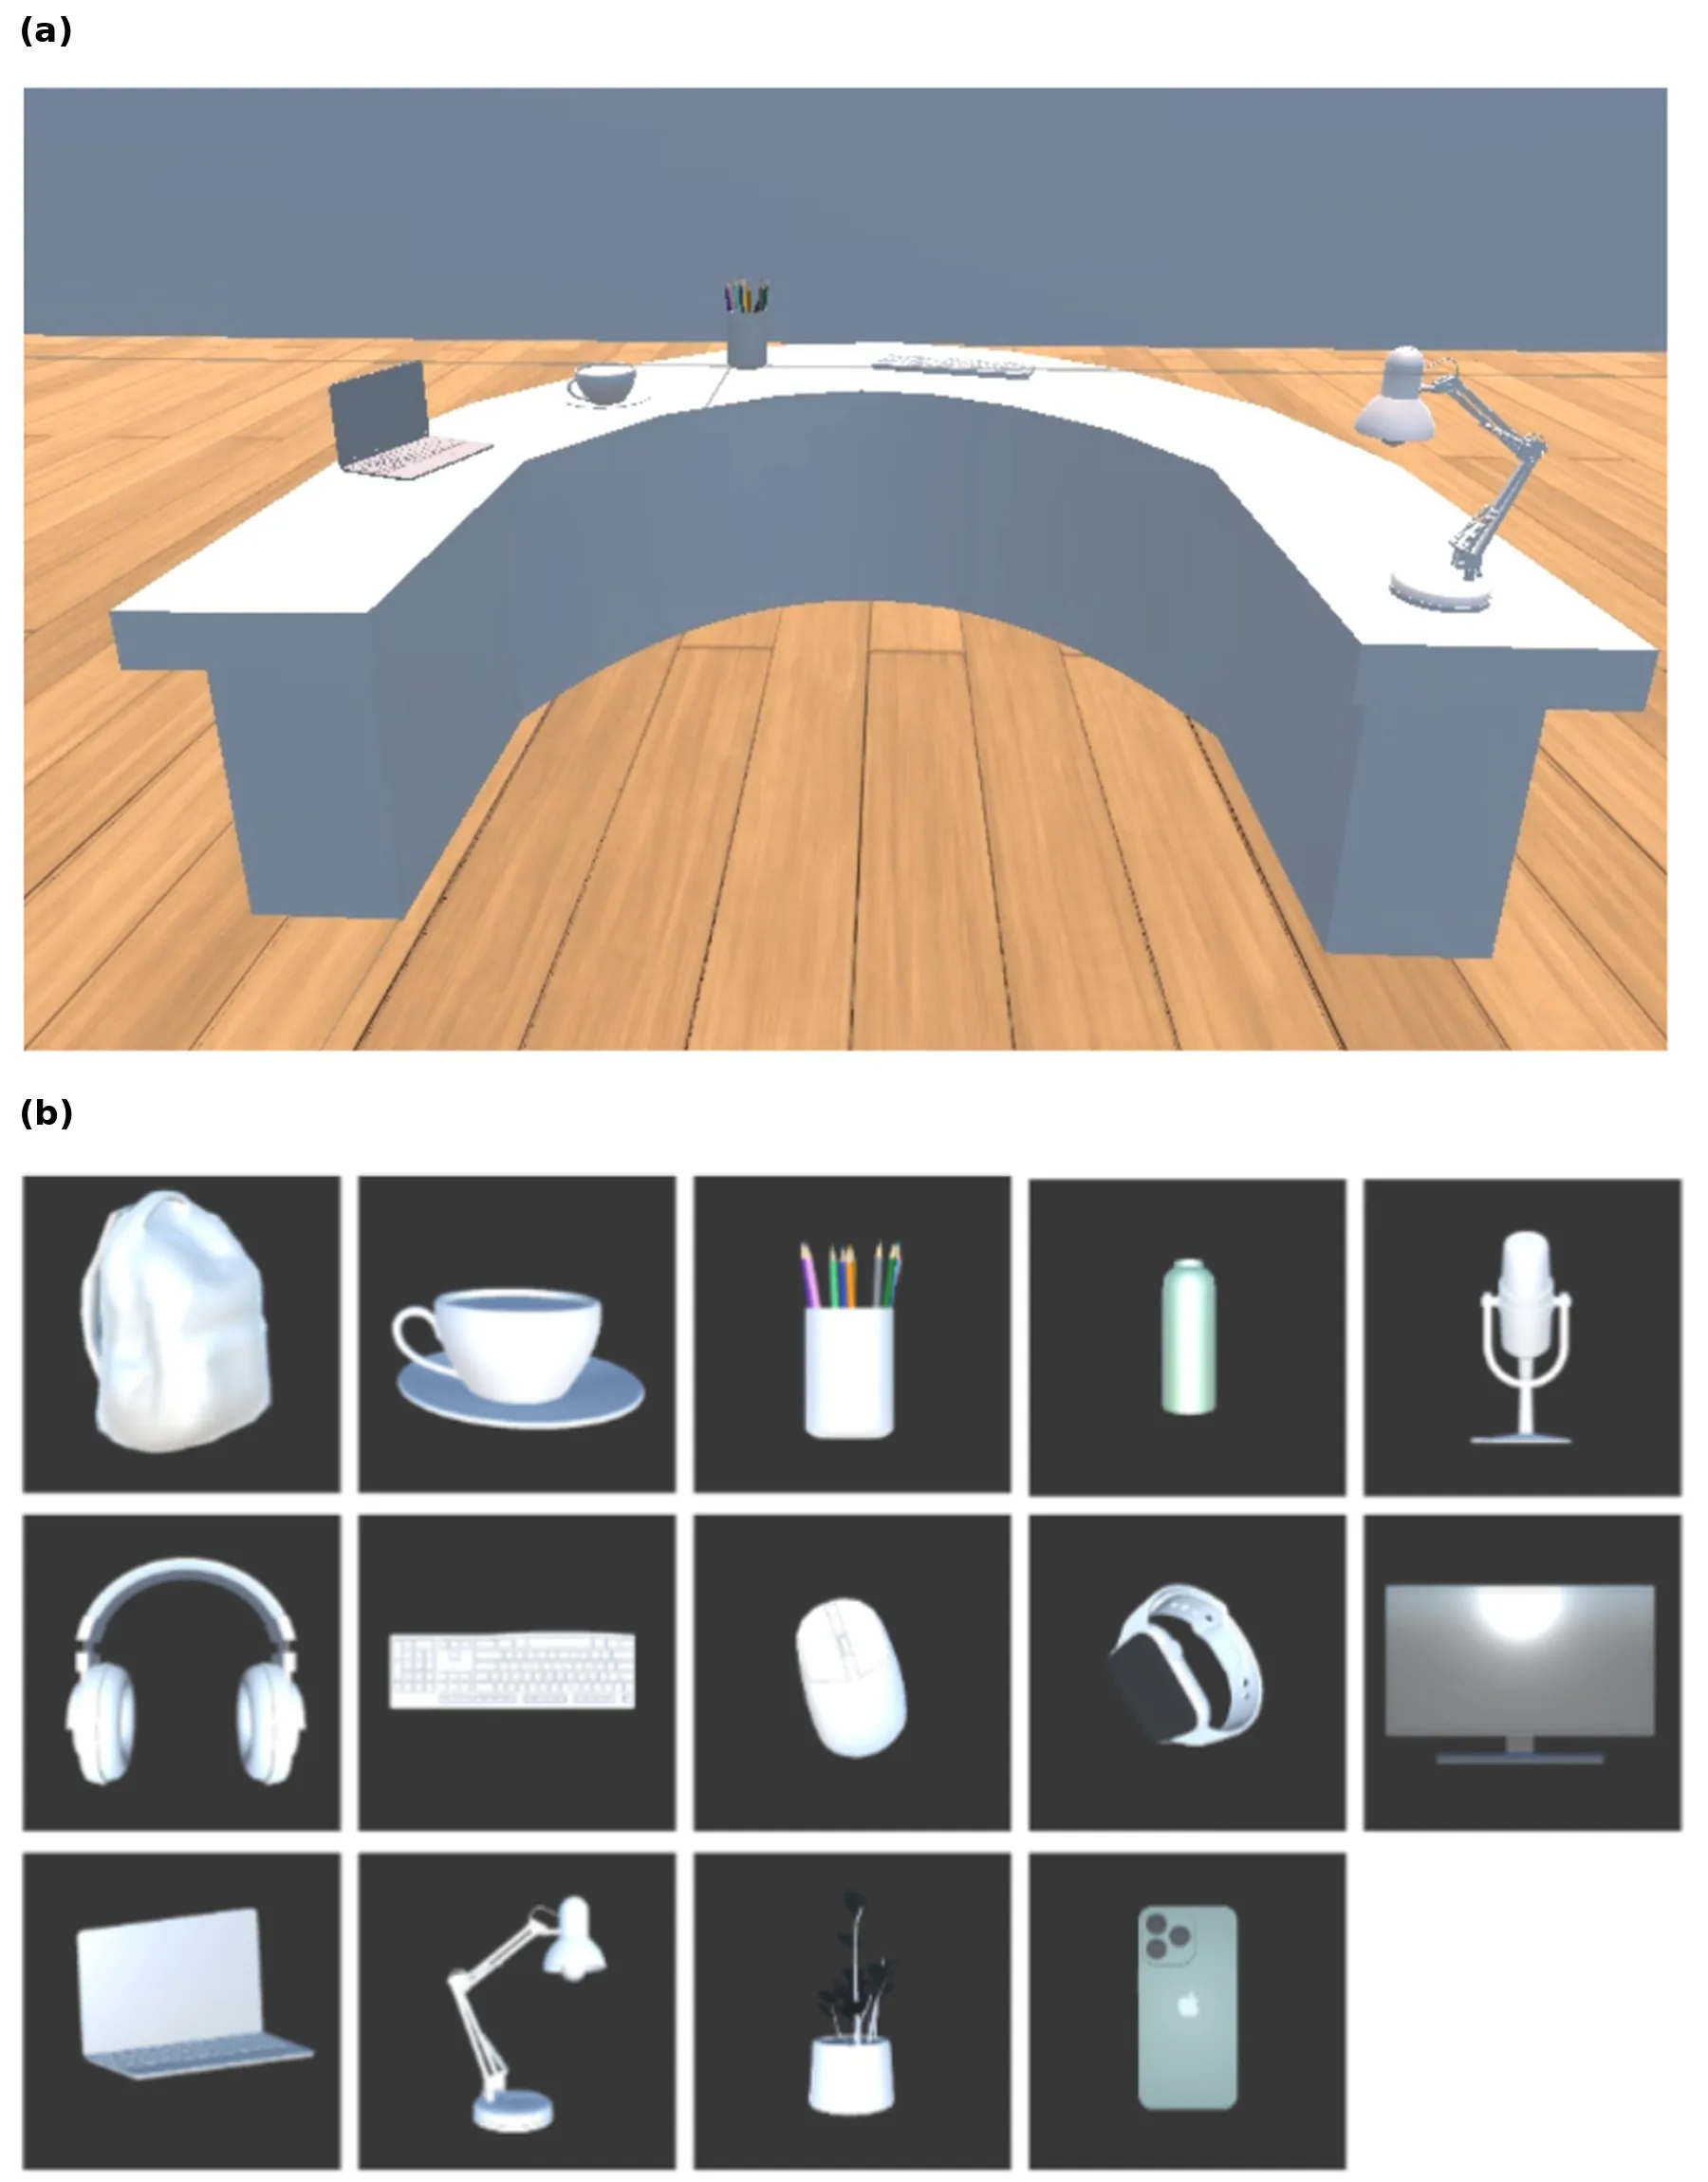
زرعة العين لا تنقل إلى الدماغ صورة فوتوغرافية، بل نقاطًا ضوئية متفرقة نادرة تُعرف بالفوسفينات. لتمييز كوب أو مفاتيح في هذا الرذاذ، يضطر الشخص إلى تحريك رأسه مثل مصباح يدوي في الظلام، وجمع ملامح الجسم شيئًا فشيئًا. هذه عملية بطيئة تشبه تجميع أحجية أُلقيت معظم قطعها.
حاولت مجموعة من الباحثين تلميح الدماغ عندما يكون مركزًا حقًا في البحث. ارتدى اثنان وعشرون مشاركًا خوذة واقع افتراضي بأقطاب كهربائية جافة تقرأ النشاط الكهربائي للدماغ (تخطيط كهربية الدماغ). أمامهم ظهرت طاولة افتراضية مرسومة بنقاط مضيئة متناثرة. المهمة هي العثور على الجسم المحدد في أسرع وقت ممكن. بعد كل محاولة، ظهرت علامة ملونة على الشاشة: ضوء أخضر إذا كان مؤشر الانخراط الخاص — نسبة موجات بيتا السريعة إلى مجموع موجات ألفا وثيتا البطيئة — مرتفعًا، وأحمر إذا كان منخفضًا. المجموعة الثانية رأت علامات مماثلة لكنها عشوائية، دون ارتباط بالدماغ.
حدث التحسن لدى الجميع: بحلول نهاية الجلسة، كان الأشخاص يعثرون على الأشياء بشكل أسرع وأدق. لكن التلميح "الذكي" لم يمنح أي ميزة — لا في السرعة ولا في الأخطاء ولا في العبء المحسوس. تعلم الدماغ بنفسه، ببساطة عن طريق التعود على فسيفساء الفوسفينات وتطوير استراتيجيات مسح خاصة به. كان التباين بين المشاركين هائلًا: عند البعض نما الانخراط بالتزامن مع النجاح، وعند آخرين لا.
لا يتخلى المؤلفون عن فكرة المساعد العصبي التكيفي. لقد أظهروا أنه يمكن دمج تخطيط كهربية الدماغ والرؤية الاصطناعية في نظام واحد قابل للارتداء. لكن جلسة تدريب واحدة ومؤشر انخراط خشن لا يكفيان. ربما سيتعين على المساعد المستقبلي اختيار إيقاع شخصي لكل مستخدم — مثل ضبط آلة موسيقية قبل الحفل.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2607.23889
Visual prostheses require users to interpret sparse and distorted artificial percepts through active visual search. We developed an EEG-guided neuroadaptive training platform for simulated prosthetic vision in immersive virtual reality and evaluated its feasibility in a sham-controlled object-localization task. Twenty-two sighted participants searched a virtual desk scene rendered through a low-resolution phosphene simulation while EEG was recorded using a dry-electrode headset integrated with a head-mounted display. During training, participants received post-trial visual feedback based either on a commonly used EEG engagement index, $$\beta/(\alpha+\theta)$$, or on visually matched non-contingent sham values. Both groups showed comparable within-session improvements in localization performance, consistent with practice, increasing familiarity with the simulated percepts, or refinement of search strategies. EEG-contingent feedback did not produce reliable group-level benefits in localization accuracy, completion time, workload, or modulation of the targeted index. Exploratory analyses showed substantial individual variability, but did not establish a feedback-specific relationship between the engagement index and behavioral performance. These findings demonstrate the feasibility of integrating EEG-contingent feedback with immersive simulated prosthetic vision, while identifying important limitations of the EEG measure, single-session training protocol, and post-trial feedback design.
الفوسفينات هي تلك "النجوم" التي نراها إذا ضغطنا بقوة على أعيننا المغلقة. من هذه الومضات تحديدًا تتكون الصورة في معظم زرعات الرؤية الحديثة.