46 façons de calculer le risque express
Les généticiens lisent l'ADN comme une longue liste de lettres. Ils en tirent un « score de risque polygénique » — un nombre qui indique si une personne a un risque de maladie, comme le diabète, supérieur ou inférieur à la moyenne. Il existe aujourd'hui des dizaines de méthodes pour calculer ce risque, et chacune procède à sa manière : l'une examine mille lettres, une autre un million, une troisième exige un ordinateur puissant, une quatrième échoue au milieu des données.
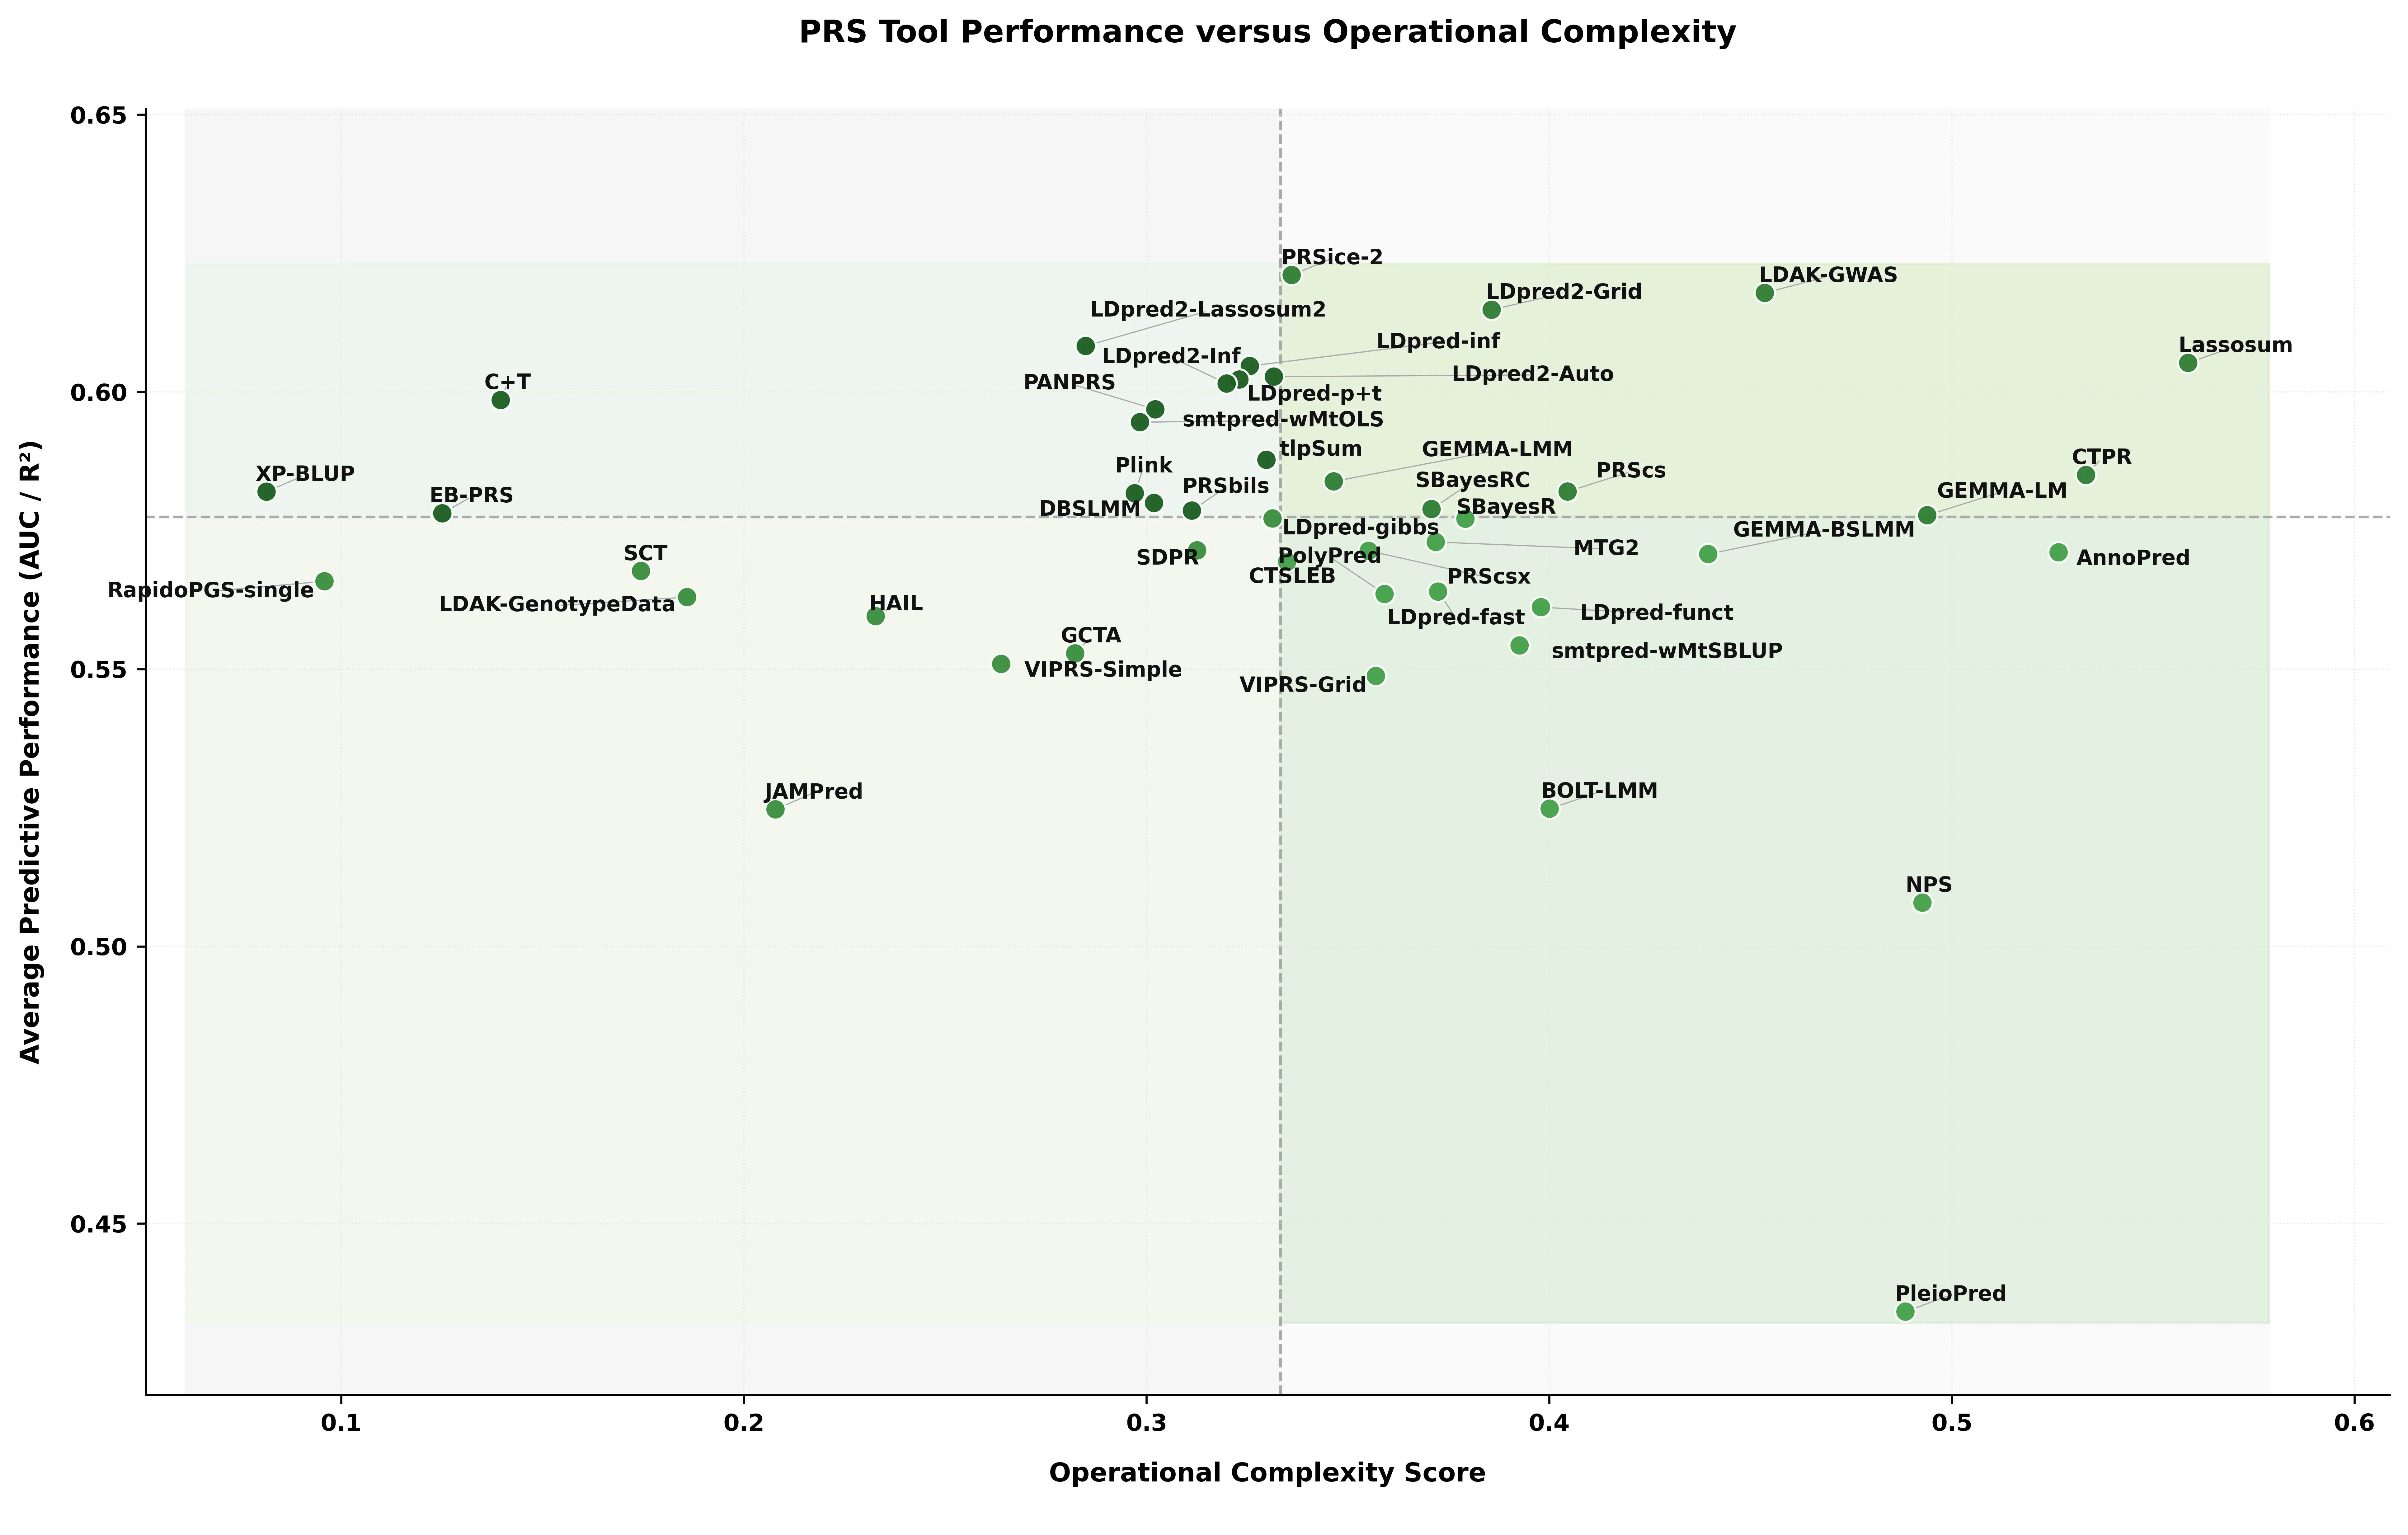
Les auteurs de l'étude ont rassemblé 46 de ces outils et leur ont fait passer un examen honnête. Ils ont utilisé les données de la biobanque britannique, qui contient des échantillons d'ADN et des dossiers médicaux de centaines de milliers de personnes. Chaque outil devait prédire sept maladies et un trait courant (par exemple, la taille). Les tests ont été effectués dans trois situations : sans données supplémentaires, uniquement avec l'ADN, et avec l'âge, le sexe et d'autres informations. Il s'est avéré qu'il n'y a pas de gagnant universel : un outil est bon pour le diabète, un autre pour l'asthme, un troisième est le plus rapide mais légèrement moins précis.
La conclusion pratique est simple : le choix d'un outil ne relève pas uniquement des mathématiques. Il faut tenir compte de la quantité de données disponibles, de la puissance de l'ordinateur, et de la capacité du programme à ne pas planter en cours de calcul. Les auteurs ont rendu leur cadre ouvert, afin que tout chercheur puisse reproduire la comparaison sur ses propres données et éviter de commettre les mêmes erreurs.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2603.21201
Polygenic risk score (PRS) tools differ substantially in statistical assumptions, input requirements, and implementation complexity, making direct comparison difficult. We developed a harmonized, implementation-aware benchmarking framework to evaluate 46 PRS tools across seven binary UK Biobank phenotypes and one continuous trait under three model configurations: null, PRS-only, and PRS plus covariates. The framework integrates standardized preprocessing, tool-specific execution, hyperparameter exploration, and unified downstream evaluation using five-fold cross-validation on high-performance computing infrastructure. In addition to predictive performance, we assessed runtime, memory use, input dependencies, and failure modes. A Friedman test across 40 phenotype--fold combinations confirmed significant differences in tool rankings ($$\chi^2 = 102.29$$, $$p = 2.57 \times 10^{-11}$$), with no single method universally optimal. These findings provide a reproducible framework for comparative PRS evaluation and demonstrate that tool performance is shaped not only by statistical methodology but also by phenotype architecture, preprocessing choices, covariate structure, computational demands, software robustness, and practical implementation constraints.
L'un des outils testés pouvait occuper 100 fois plus de mémoire qu'un autre, avec une précision de prédiction presque identique.