Atlas cellulaires : qui lit le mieux le langage des tissus ? express
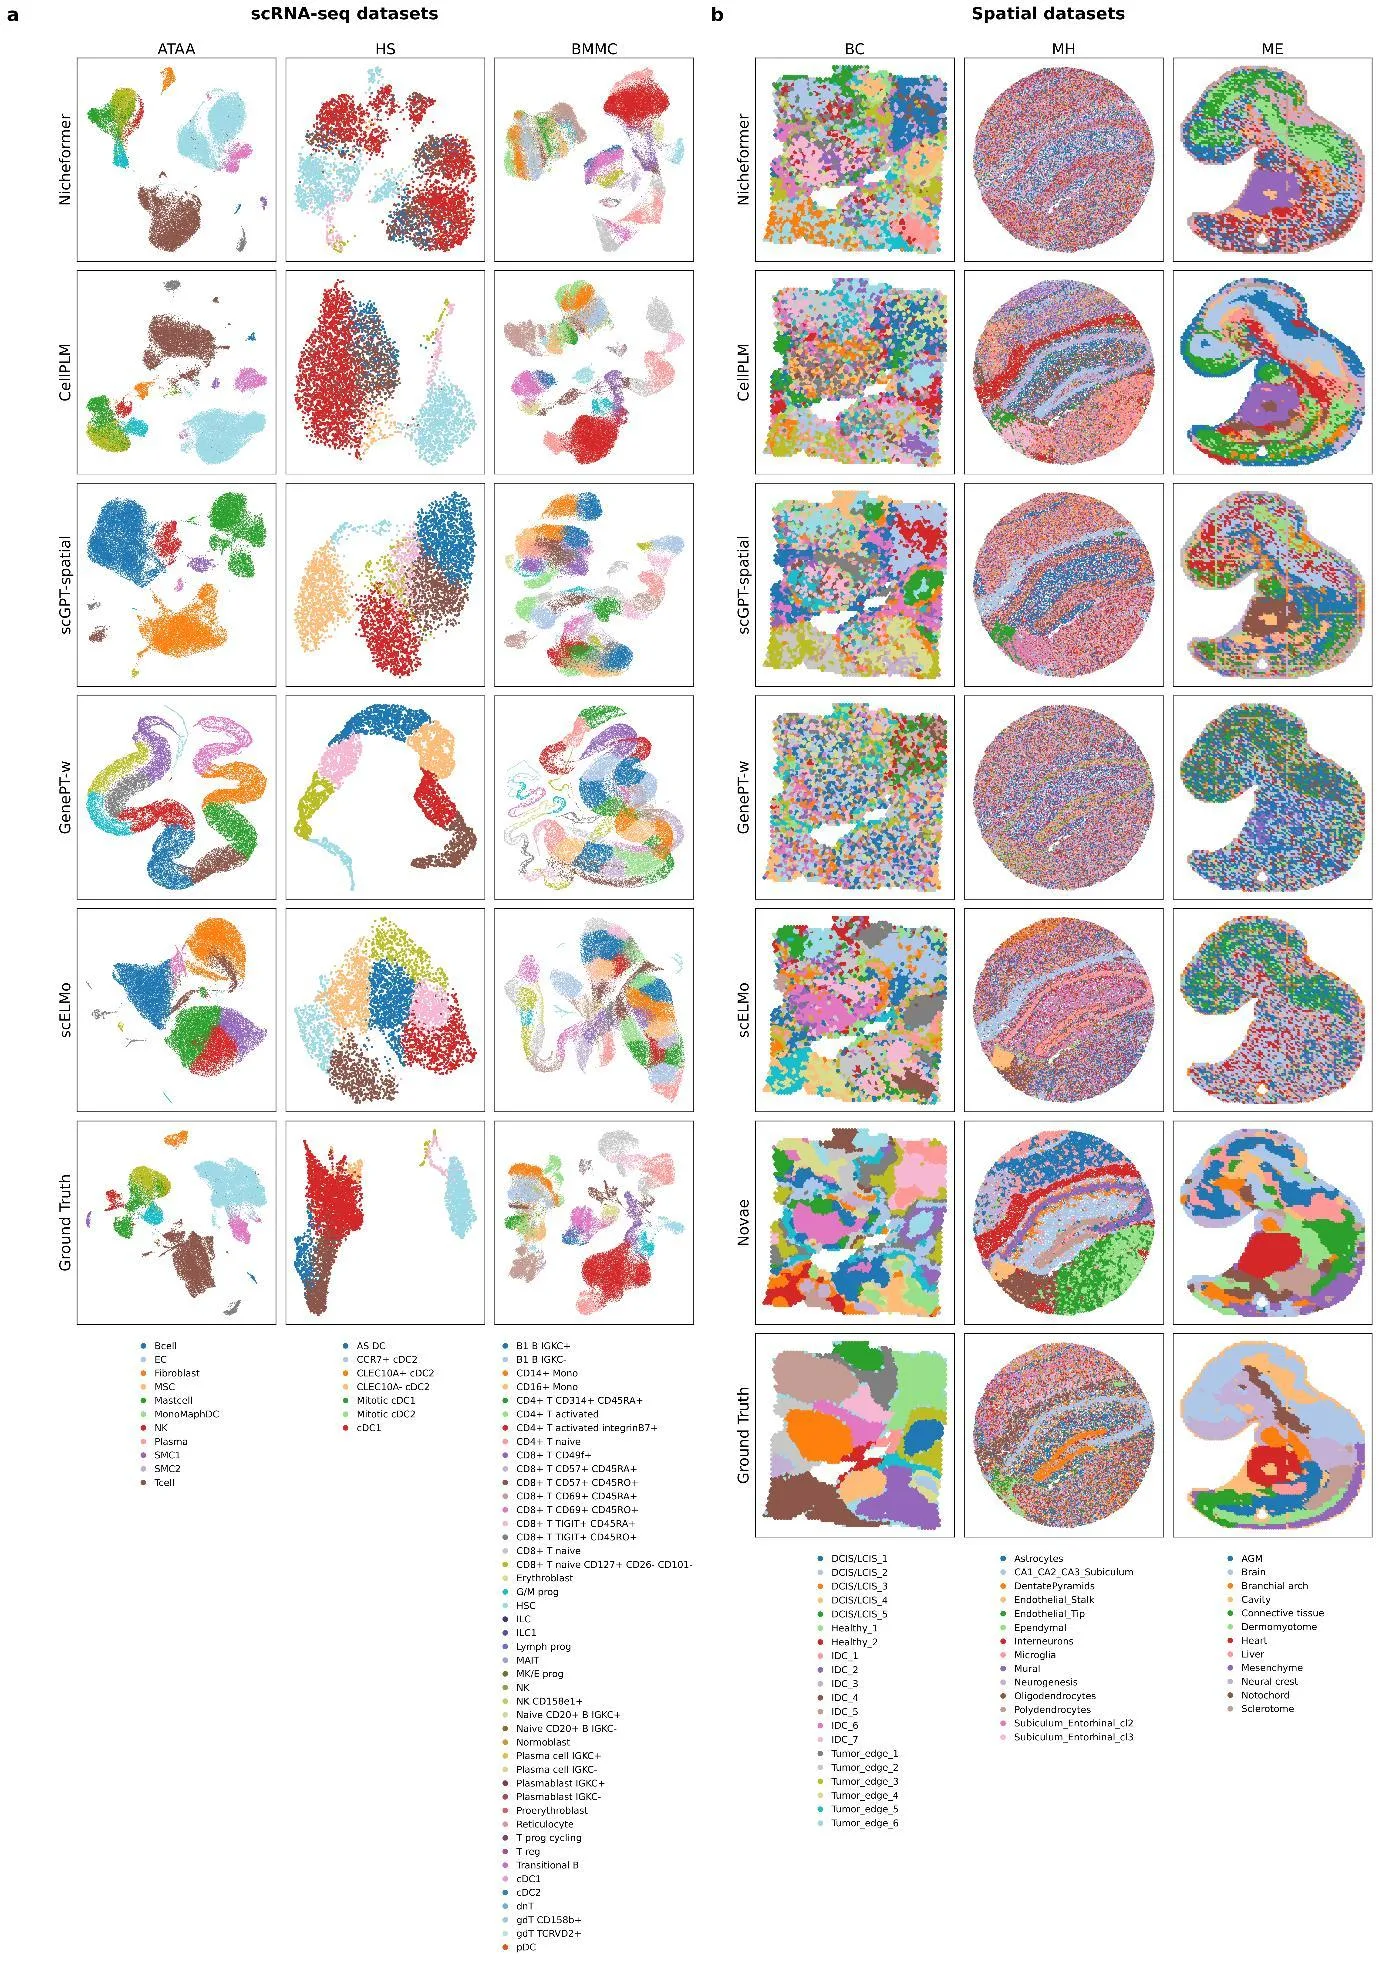
Les biologistes confient de plus en plus aux ordinateurs la lecture des « modes d'emploi » de la cellule vivante. Six modèles récents d'intelligence artificielle — Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo et Novae — sont comme six traducteurs de dialectes différents d'un même langage cellulaire. Chacun a appris sur ses propres textes : certains ont mémorisé des séquences de gènes actifs, d'autres des cartes spatiales de tissus, d'autres encore ont commencé avec le langage humain ordinaire.
Les auteurs de l'étude leur ont fait passer un examen honnête. Les modèles ont reçu les mêmes tâches : regrouper les cellules par type, trouver des gènes marqueurs (les « passeports » moléculaires des cellules) ou prédire comment une cellule réagira à un médicament. Les données d'entrée étaient également variées, allant d'une simple liste de gènes exprimés à des images montrant la position de chaque cellule dans le tissu.
Le résultat est déconcertant. Les modèles entraînés sur des listes « plates » de gènes ont été les meilleurs pour déterminer les types cellulaires. Les modèles spatiaux, qui voient la carte du tissu, ont mieux préservé l'architecture de l'organe. Et les modèles de langage, pour lesquels un gène n'est qu'un mot dans une phrase, ont étonnamment bien prédit l'effet des médicaments. Aucun modèle n'a gagné dans toutes les catégories, et le classement changeait au moindre détail — la méthode de prétraitement des données, le choix de la métrique, ou même la façon dont les gènes étaient « découpés » en morceaux pour l'analyse.
Ce n'est pas une course au champion absolu. C'est plutôt l'émergence d'une gamme d'outils, chacun bon pour son usage. L'avenir appartient aux modèles qui pourront non seulement marquer des points dans les tests, mais aussi expliquer au biologiste pourquoi une cellule a emprunté telle voie de développement.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2607.17227
Single-cell and spatial foundation models promise transferable biological representations, yet their generality remains largely untested across modalities, biological domains and analytical tasks. We benchmarked six representative models, Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo and Novae, using a harmonised framework spanning scRNA-seq, spatial transcriptomics and Perturb-seq. We evaluated zero-shot and continually pretrained clustering, supervised annotation, marker-gene concordance and perturbation prediction. Model performance was strongly conditional: expression-trained cell-level transformers best resolved many cell-identity tasks, spatial and graph-aware models better preserved tissue architecture, and language-derived gene embeddings were competitive for selected perturbation-response metrics. No model dominated across tasks, and rankings shifted with modality, preprocessing, tokenisation, biological prior, domain shift and metric choice. This benchmark provides practical guidance for model selection and argues that future models should be judged by biological generalisation, interpretability and perturbation-grounded validity, not by scale or leaderboard performance alone.
Certains modèles ont appris à comprendre les gènes en « lisant » simplement des articles scientifiques. Pour eux, un gène est comme un mot, et une cellule comme un paragraphe.