Un modèleprédictif dans ce contexte est un cadre computationnel qui prévoit où les protéines se lient à l'ADN en fonction des caractéristiques de la séquence. Ces modèles sont essentiels pour comprendre la régulation génique, car ils aident à identifier les segments d'ADN reconnus par les facteurs de transcription—des protéines qui contrôlent l'expression des gènes. En prédisant les sites de liaison à travers le génome, les chercheurs peuvent cartographier les réseaux de régulation et relier les variations génétiques aux maladies.
Histoire
Les premières approches computationnelles dans les années 1980 utilisaient de simples séquences consensus, mais les modèlesprédictifs modernes ont émergé dans les années 2000 avec des méthodes d'apprentissage automatique comme les machines à vecteurs de support et plus tard l'apprentissage profond.
Comment ça marche
Le modèle est entraîné sur des données connues de liaison protéine-ADN, apprenant des motifs dans les séquences d'ADN qui corrèlent avec la liaison. Des caractéristiques comme la composition en nucléotides, les correspondances de motifs et l'accessibilité structurelle sont encodées en entrées. Des algorithmes d'apprentissage automatique, souvent des réseaux de neurones profonds, apprennent ensuite une fonction qui mappe ces caractéristiques à la probabilité de liaison. Une fois entraîné, le modèle peut scanner des génomes entiers pour prédire de nouveaux sites de liaison.
En pratique
Ces modèles sont utilisés pour annoter les génomes, identifier les mutations régulatrices associées aux maladies et concevoir des circuits génétiques synthétiques en biotechnologie.
Anecdote
Certains modèlesprédictifs peuvent désormais atteindre une précision comparable aux méthodes expérimentales comme le ChIP-seq, mais à une fraction du coût et du temps.
Imaginez une carte des vents au-dessus d'une chaîne de montagnes. Le vent souffle principalement vers le bas des pentes, obéissant aux différences d'altitude. Mais si l'on y regarde de plus près, dans certaines vallées, l'air s'enroule en petits tourbillons qui empêchent le vent de simplement descendre.
Imaginez que vous essayez de comprendre ce qui s'est passé dans une pièce à partir du son qui subsiste après un coup de feu. Le coup de feu n'est plus là, mais l'écho résonne encore contre les murs.
Dans la glace antarctique, une particule fantôme ne laisse qu'un faible éclat de lumière bleue. Le détecteur IceCube capture ces éclats, et à partir d'eux, il faut déterminer d'où vient la particule. Le modèle PolarBERT a appris à le faire, mais ce qu'il voit réellement à l'intérieur restait un mystère.
Une protéine dans une cellule ne reste pas immobile comme un mannequin en vitrine. Ses atomes tremblent, s'étirent et se plient constamment, un peu comme une corde de guitare tendue qui continue de vibrer après qu'on l'a pincée. Pour comprendre comment une protéine fonctionne, il faut savoir à quel point chaque partie est fermement liée à ses voisines.
Sous un microscope électronique, une protéine apparaît comme une série d'ombres floues — des centaines de milliers de clichés de la même molécule, mais sous des angles différents et avec un fort bruit.
Une molécule d'ADN, coincée dans une minuscule fente métallique, tremble et scintille sous le laser. Son signal n'est pas une ligne claire de lettres, mais un mélange chaotique d'éclairs et d'ombres. Déchiffrer ce bruit, c'est comme essayer de comprendre un murmure dans une salle bondée.
Le nouveau réseau de neurones agit comme un interprète attentif.
Une protéine ressemble à une minuscule machine qui s'allume et s'éteint sur commande. La commande arrive lorsqu'une autre molécule s'y fixe, comme une clé dans une serrure. Ensuite, la protéine change de forme et transmet le signal plus loin. Mais comment exactement le signal circule à l'intérieur de la protéine est longtemps resté un mystère.
En tournant lentement le bouton de réglage d'un vieux poste de radio, vous entendez le son émerger du bruit non pas progressivement, mais par un saut brusque, au moment où l'antenne entre en résonance avec l'onde. C'est à peu près ainsi que se comportent les gènes dans une cellule vivante.
Un caillot grossit comme une boule de neige qui dévale une pente : d'abord petit, il accroche de nouvelles couches, et le moment où il se transforme en avalanche est difficile à deviner. Dans le sang, une longue chaîne de réactions se déclenche — la cascade de coagulation — où une substance en éveille une autre, et le caillot prend de la masse.
Une cloche cachée dans un épais coffret peut être mise à sonner sans ouvrir le couvercle. Il suffit d'envoyer une onde sonore à travers les parois — et le battant se met à vibrer.
Un immense orchestre sans chef. Chaque musicien est un gène, et la mélodie est le travail complexe de la cellule. Autrefois, en regardant une photo de tissu, l'ordinateur essayait de deviner la partition de chaque instrument individuellement. Il ne savait pas que les violons jouent généralement avec les altos, et les trompettes avec les trombones.
Le cerveau ne se contente pas de réagir au monde – il ne cesse de deviner ce qui va se passer l'instant d'après. Ce principe porte le nom de codage prédictif : les neurones comparent leurs attentes à la réalité et mettent à jour leur représentation interne lorsqu'une erreur survient. Mais comment un système aussi complexe peut-il être organisé dans le tissu vivant du cortex ?
Un réseau où les lions mangent les zèbres et où les hyènes finissent les restes, ce n'est pas qu'une liste de repas. C'est une carte de survie pour toute une région. Quand le climat change, les animaux se déplacent et la carte se déchire. Pour comprendre où elle se déchirera et où elle tiendra, il faut trouver son « squelette » immuable – ces connexions qui se répètent d'un endroit à l'autre.
Une protéine dans la cellule n'est pas une pièce rigide, mais plutôt un gant souple qui peut saisir différents objets. Jusqu'ici, les concepteurs de protéines travaillaient comme des sculpteurs, créant une clé pour une seule serrure : une cible, une forme.
Une protéine glisse le long du brin d'ADN comme une clé sur un trousseau, cherchant sa serrure. Un mauvais tournant, et le gène reste éteint. Pour savoir où la protéine s'agrippera solidement, il faut mesurer la force de cette prise, c'est-à-dire l'énergie de liaison.
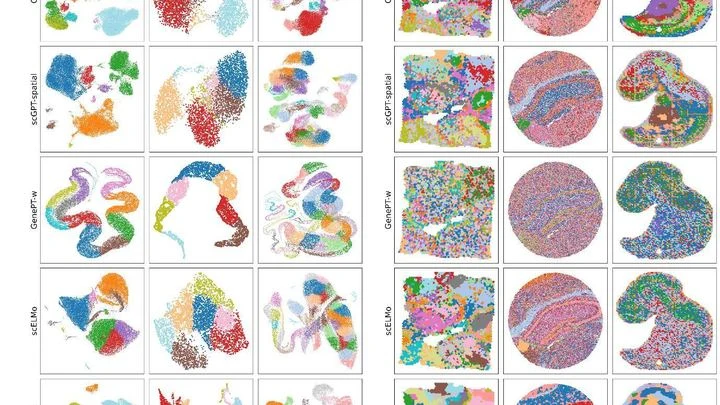
Les biologistes confient de plus en plus aux ordinateurs la lecture des « modes d'emploi » de la cellule vivante. Six modèles récents d'intelligence artificielle — Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo et Novae — sont comme six traducteurs de dialectes différents d'un même langage cellulaire.
Une immense bibliothèque où chaque livre est une instruction précise pour assembler une molécule de protéine. Le réseau de neurones AlphaFold2 a lu des millions de ces livres et a appris à fournir instantanément un modèle tridimensionnel prêt à l'emploi.
Les gènes sont comme des maisons dans une ville : dans certaines, la vie grouille, dans d'autres, c'est le silence. Ce paysage génétique « urbain » a été analysé chez mille femmes atteintes d'un cancer du sein.
En mesurant l'activité de milliers de gènes, les biologistes ne voient généralement qu'une liste de coïncidences — comme deux ingrédients d'une soupe qui se retrouvent souvent ensemble. Le modèle standard recherche ce genre de paires liées, mais ne montre pas qui influence qui.
Les données sur l'activité des gènes ressemblent généralement à une longue rangée de chiffres, comme une bande arc-en-ciel (spectroscopie) sans liens visibles. Dans le modèle scVision, ces chiffres sont transformés en une image signifiante — non pas une liste d'ingrédients, mais une photo du plat fini.
Les cellules d'un même organisme sont comme des jumeaux boulangers dans une cuisine commune. Ils partagent le même livre de recettes (l'ADN), mais des erreurs aléatoires surviennent lorsqu'ils recopient la recette sur une antisèche et lorsqu'ils assemblent le plat.
Sur une cuisinière à gaz, chaque brûleur chauffe différemment. Si le cuisinier déplace les casseroles, la nourriture peut brûler. Il en va de même dans un réseau sans fil : les antennes-brûleurs et les utilisateurs-casseroles nécessitent un placement précis. Les réseaux de neurones classiques ne distinguent pas les positions, considérant tous les brûleurs comme identiques.
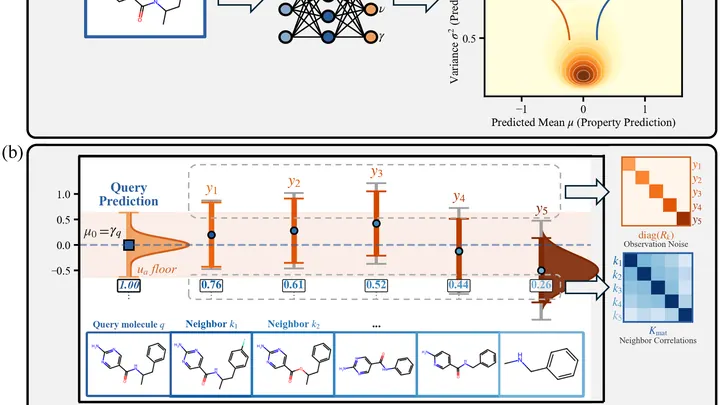
Prédire les propriétés d'une nouvelle molécule, c'est un peu comme deviner le goût d'un plat inconnu. Le programme agit comme un chef expérimenté : il « goûte » des molécules similaires dont les propriétés sont déjà connues et, en se basant sur leur « saveur », affine son estimation.
Les machines complexes — des drones aux robots chirurgiens — se comportent parfois comme un mustang sauvage : pleines de désordre et de caprices, où un léger contact déclenche une tempête. Plutôt que de mémoriser des formules, la nouvelle méthode observe le système, tel un dresseur.
Un détective expérimenté ne calcule pas la trajectoire d'un criminel selon les lois de la physique — il consulte sa bibliothèque d'affaires similaires.
Vous recevez un rapport : une « lettre » a été remplacée dans votre gène. Mais qu'est-ce que cela change ? Une protéine n'est pas une ligne plate, c'est une pelote dense où chaque boucle a sa place dans un creux. Un remplacement au cœur de cette pelote, c'est comme une fissure dans les fondations ; à la surface, c'est une égratignure sur la façade.
Une protéine dans la cellule n'est pas une sculpture figée. Elle bouge sans cesse : elle se plie, respire, tremble. Ce mouvement, que l'on appelle dynamique, détermine le fonctionnement de la protéine. Mais observer cette danse directement est difficile, et la modélisation informatique exige souvent d'énormes puissances de calcul.
Distinguer le signal d'une paire de trous noirs supermassifs, c'est comme entendre les pas d'un danseur dans le fracas d'un ouragan. Quelque part dans l'espace, ces monstres tournent dans un tango gravitationnel lent, déformant l'espace-temps lui-même.
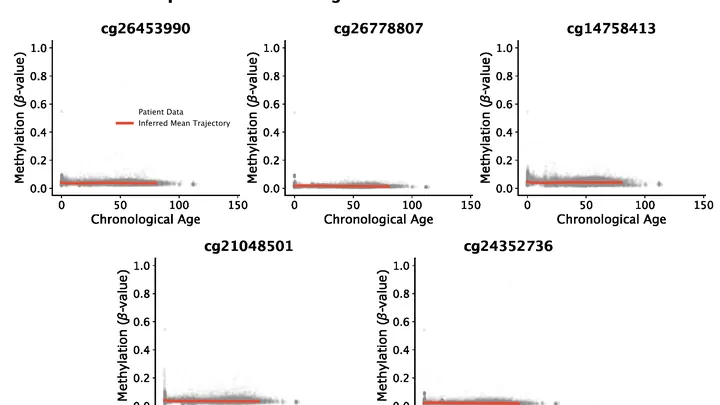
La méthylation de l'ADN, ce sont de minuscules marques chimiques sur nos gènes. Au fil des ans, elles évoluent selon un calendrier assez strict. Les horloges épigénétiques classiques observent ces marques et affichent un seul chiffre : l'âge biologique. Mais un chiffre ne raconte pas comment le motif des marques s'est réorganisé jour après jour, année après année.
Imaginez une audition pour un orchestre symphonique, où sur des centaines de candidats, seuls ceux dont les instruments sonnent juste et résistent à un crescendo furieux restent.
Un médecin ne pose pas un diagnostic au hasard. Il ouvre le manuel médical et montre sur quel article il s'appuie. C'est à peu près ainsi que fonctionne le nouveau système KG-TRACE.
Le système immunitaire ressemble à un éditeur infatigable qui corrige le brouillon des anticorps, les rendant de plus en plus accrocheurs aux virus et aux bactéries.
Un ingénieur règle une antenne : il tire sur un segment — la fréquence dérive, il change l'angle — le gain chute. C'est à peu près ainsi que fonctionne le développement des peptides thérapeutiques (de courtes chaînes protéiques).
Un réseau de neurones, telle une feuille de papier quadrillé, reçoit des signaux homogènes en entrée – et trace lui-même sa grille de coordonnées. D'abord, les connexions entre les entrées et les cellules du réseau deviennent semblables à une colline douce : la réponse est plus forte au centre et s'atténue vers les bords.
Vous achetez une nouvelle balance de cuisine, mais au lieu d'un poids précis, elle n'affiche que l'écart par rapport à une « norme » quelconque. Pour connaître le poids d'une pomme, il faut d'abord peser des dizaines d'autres pommes et calculer la moyenne.
Pendant longtemps, nous n'avons vu les protéines que dans leur position finale, comme des photos de danseurs figés dans une pose élégante. Des programmes comme AlphaFold ont appris à prédire cette pose à partir d'une chaîne de maillons de carbone.
Deux équipes de cantonniers posent de l'asphalte depuis les deux extrémités d'une rue. Elles avancent l'une vers l'autre, et c'est de leur coordination que dépend le moment où la rue sera prête.
Un laboratoire envoie à un robot une liste de mille molécules candidates pour un nouveau médicament. Le robot-prédicteur, entraîné sur d'anciennes données, donne pour chacune une évaluation « convient – ne convient pas ». Mais lorsque la liste provient d'un domaine inconnu – un autre virus ou une tumeur rare – le robot commence à se tromper.
Un fil téléphonique coupé, c'est embêtant, mais de l'ADN cassé, c'est une catastrophe. Une cassure double brin (lorsque les deux brins de l'hélice se brisent au même endroit) menace la cellule de mort ou de transformation cancéreuse.
Un traducteur n'apprend pas une langue dans un manuel, mais en écoutant la parole vivante et en voyant immédiatement ce que les gens font en réponse aux mots. C'est exactement ainsi que fonctionne la nouvelle méthode C3P pour lire l'ADN bactérien.