Кто лечит лучше: универсальный ИИ или узкий специалист экспресс
Каждую неделю врачи задают ИИ-помощникам миллионы вопросов у постели больного. Но проверяют эти инструменты обычно на экзаменационных задачках, а не на том, что спрашивают в реальной клинике. Группа исследователей решила это исправить.
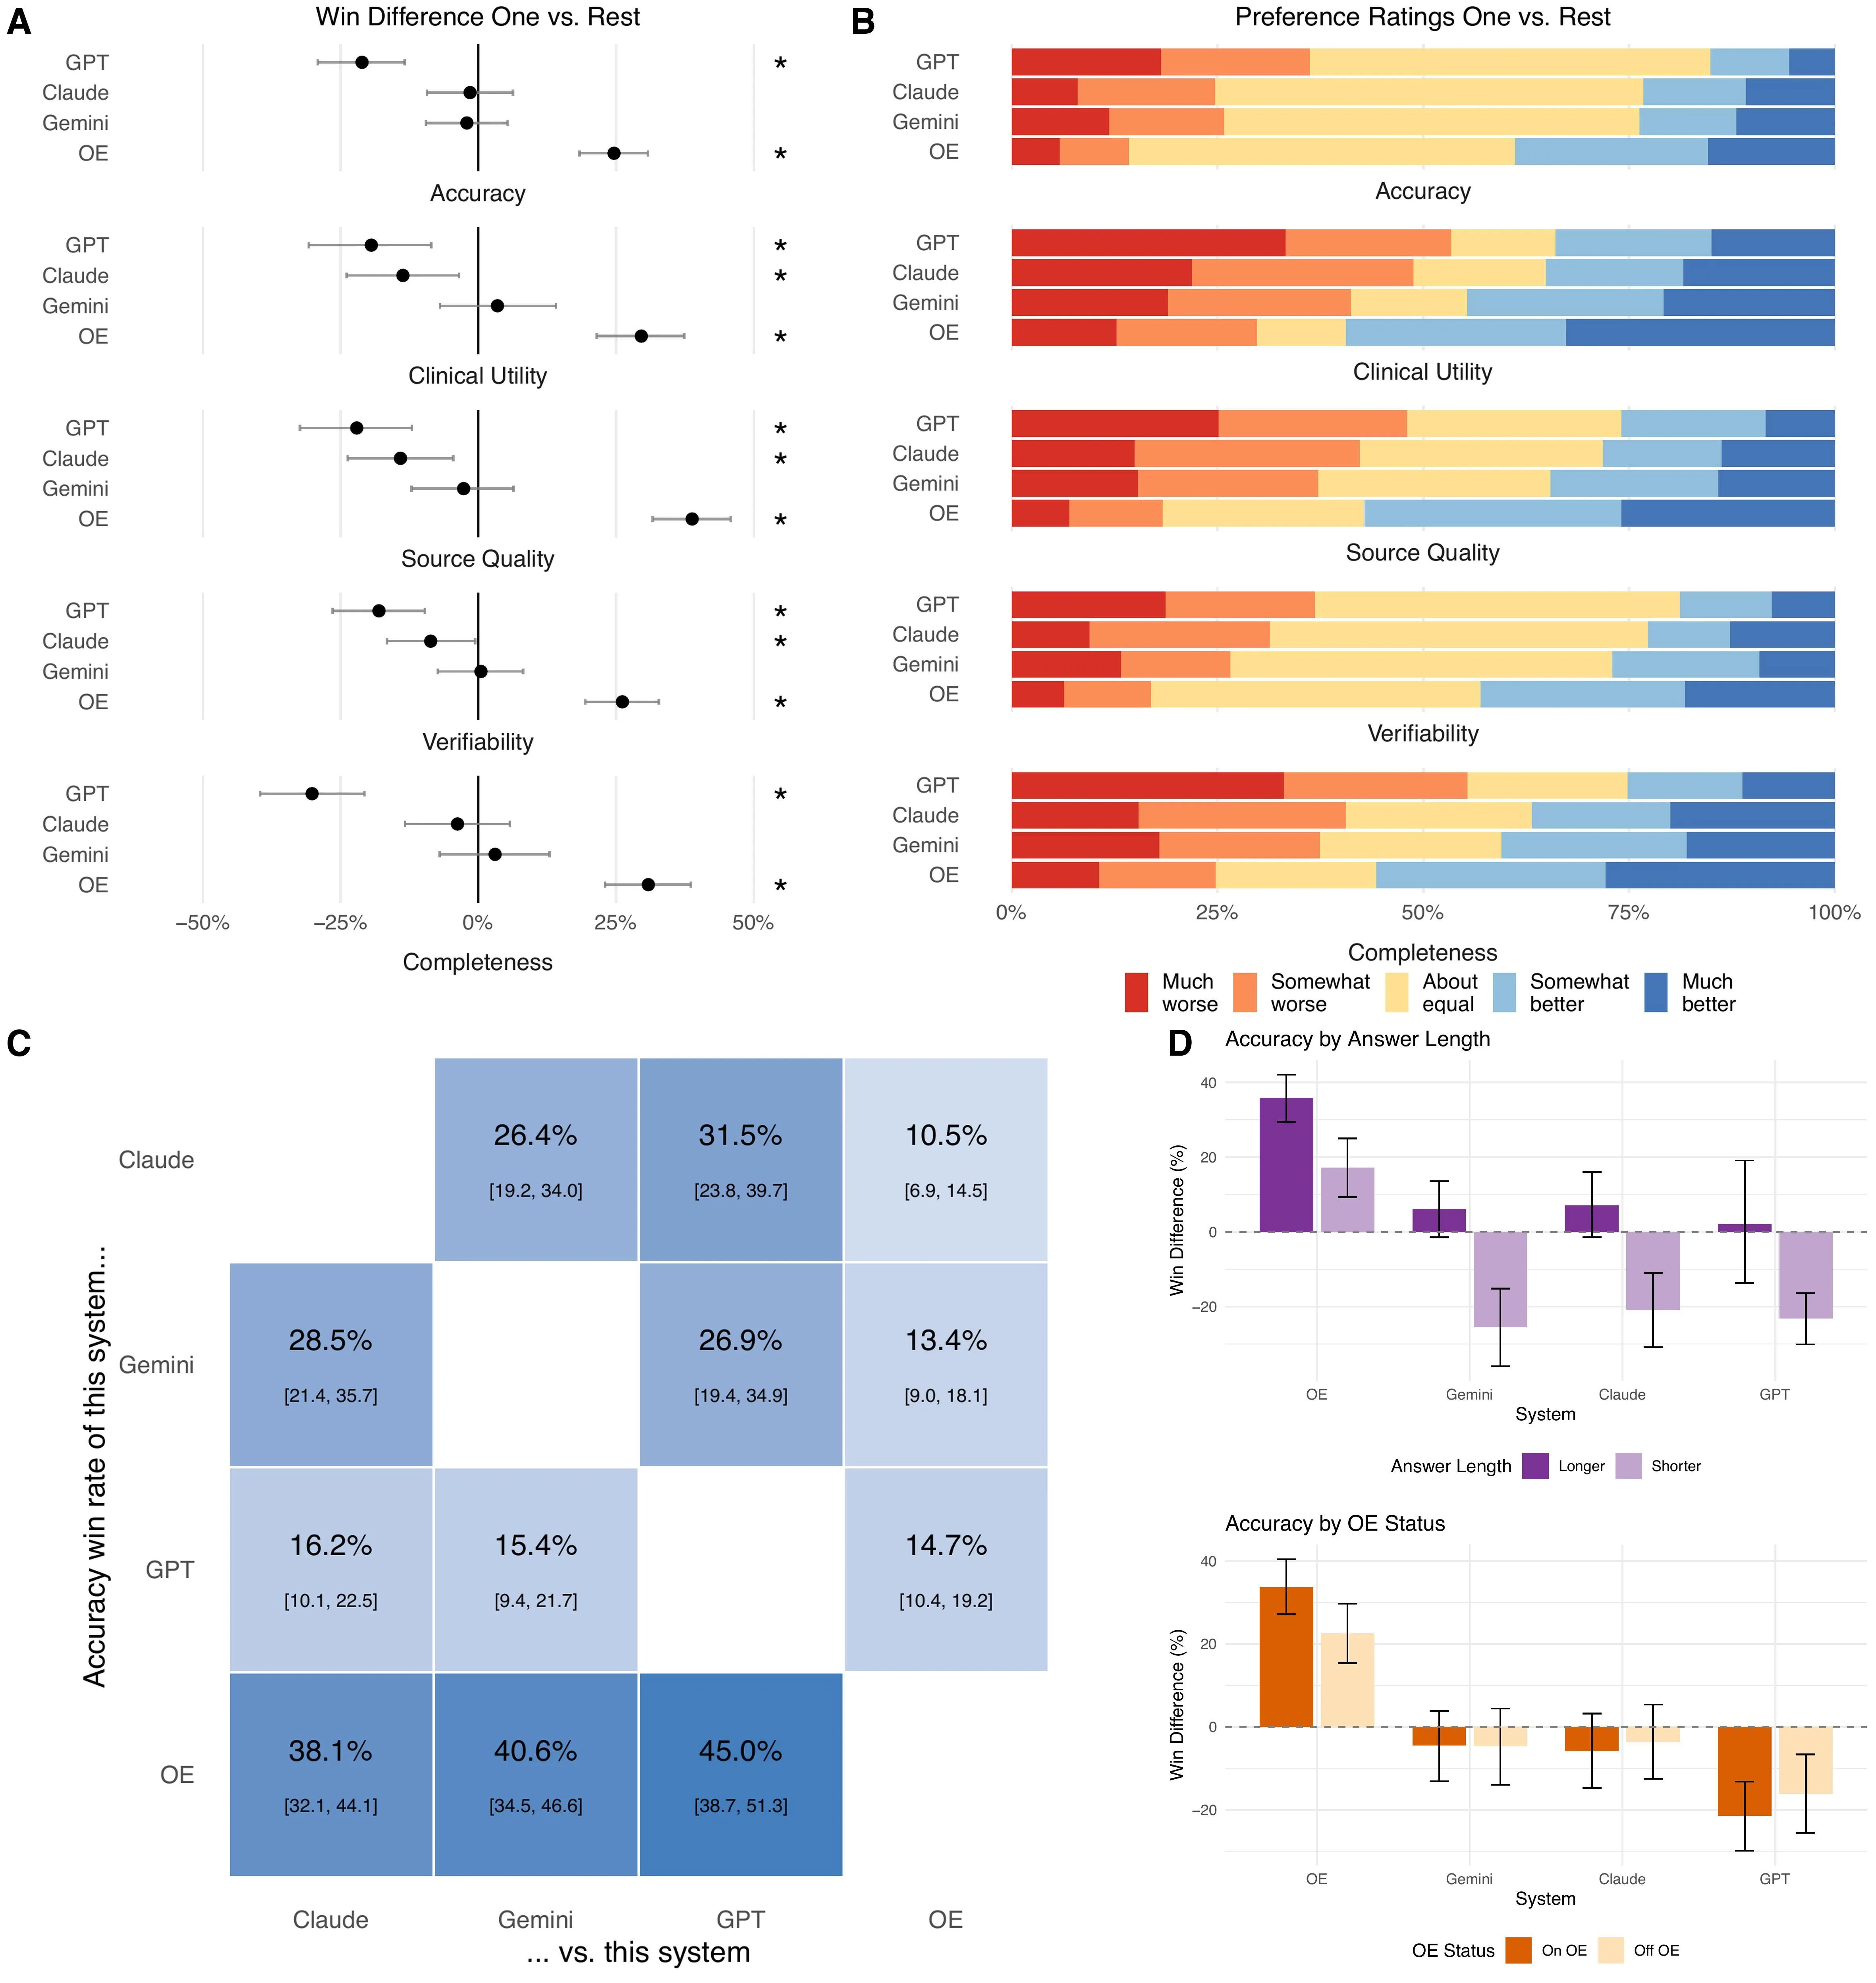
Они собрали 620 настоящих вопросов от докторов из 30 специальностей — от кардиологии до онкологии. Эти вопросы задавали платформе OpenEvidence. Затем 149 практикующих врачей из 36 штатов сравнили ответы трёх флагманских общих моделей (Claude Opus 4.8, Gemini 3.1 Pro, GPT-5.5) и специализированного медицинского инструмента (OE). Каждый судья был из той же специальности, что и задавший вопрос врач.
Оценивали по пяти осям: точность, клиническая польза, качество источников, проверяемость и полнота. Специализированный инструмент победил по всем пунктам. Разница между победами и поражениями составила от 25 до 39 процентных пунктов — с огромной статистической значимостью (p<0.001). Результат не зависел от того, показывали ли цитаты, какова была длина ответа и пользовался ли судья этим инструментом раньше.
Выводов два. Первый: тестировать медицинский ИИ нужно на реальных вопросах и с участием врачей той же специальности — иначе картина будет неполной. Второй: преимущество специализированного инструмента не значит, что общие модели бесполезны. Оно показывает, что целенаправленная инженерная настройка даёт ощутимый выигрыш для пользователя. Как хорошо настроенный стетоскоп слышит то, что упускает универсальный микрофон.
Разница в победах доходила до 39 процентных пунктов — это как если бы одна команда выигрывала 7 матчей из 10, а вторая только 3.