Бенчмарк — это стандартизированный тест или набор данных, используемый для измерения и сравнения производительности моделей ИИ. Он обеспечивает общую основу для оценки различных подходов, гарантируя воспроизводимость и сопоставимость результатов между исследовательскими группами. Бенчмарки необходимы для отслеживания прогресса в ИИ, поскольку они предоставляют объективные критерии того, что считать улучшением.
История
Концепция бенчмарков в ИИ приобрела известность с ростом машинного обучения в 1980-х годах, но термин стал широко использоваться в 2000-х годах с созданием стандартизированных наборов данных, таких как ImageNet для распознавания изображений.
Как это работает
Бенчмарки обычно состоят из фиксированного набора задач, вопросов или образцов данных с известными правильными ответами. Модели ИИ запускаются на этих задачах, и их результаты оцениваются с помощью заранее определенных метрик, таких как точность, полнота или F-мера. Полученные оценки позволяют исследователям ранжировать модели и определять, какие из них лучше всего справляются с конкретными типами задач.
Некоторые бенчмарки ИИ специально разработаны как «состязательные», то есть они нацелены на выявление слабых мест моделей, что приводит к созданию более надежных алгоритмов.
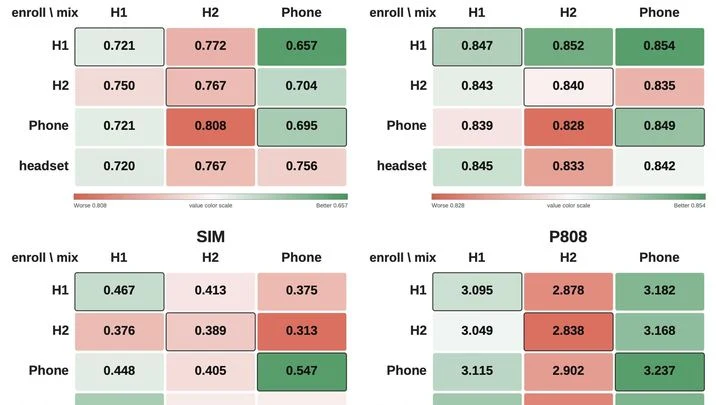
В 1980-х годах соревнование DARPA по распознаванию речи положило конец спору между статистическими методами и рукописными правилами, задав единый стандарт для всей области. Для речевых нейроинтерфейсов, переводящих мозговую активность в слова, такого общего эталона до сих пор не было: каждая система использует свой словарь, способ записи и тип речи.
Ночью на вершине вулкана шесть телескопов смотрят на одно и то же пятнышко света. Каждый ловит свою копию волны, и если соединить их сигналы, получится изображение, которое не под силу ни одному инструменту в одиночку. Но есть подвох: свет, пойманный разными станциями, нельзя просто сложить, как фотографии. Его нужно измерить, и от способа измерения зависит, насколько чёткой выйдет картинка.
Белковый инженер похож на повара, который пытается сделать блюдо одновременно вкусным, полезным и дешёвым. Изменяя один ингредиент, он рискует испортить другой. Раньше компьютерные помощники умели оценивать свойства белков только по отдельности, не видя, как они связаны между собой.
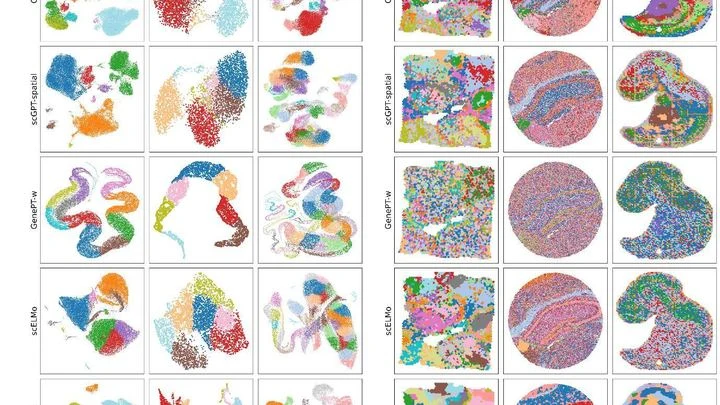
Биологи всё чаще доверяют компьютерам чтение «инструкций по эксплуатации» живой клетки. Шесть свежих моделей искусственного интеллекта — Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo и Novae — как шесть переводчиков с разных диалектов одного и того же клеточного языка.
Восстановить целостную картину по обрывкам — всё равно что расслышать мелодию оркестра в шумном зале. Такие задачи стоят в фотометрии — области, измеряющей поток излучения от небесных тел, где по слабому мерцанию восстанавливают яркость звезды. Традиционные методы требуют точных сведений о помехах, а они почти всегда неизвестны.
Человек без усилий выхватывает нужный голос из гомона вечеринки — наш мозг справляется с этой задачей, словно опытный рыбак, безошибочно узнающий плеск знакомой рыбы в бурном потоке. Для компьютера то же самое — пока задача на пределе возможностей. Прежние программы тренировались на стерильных записях, где нет ни эха, ни звона приборов.
Модели, превращающие текст в аудио, хорошо воссоздают одиночные звуки, но путаются, когда в сценарии их несколько. Например, по сценарию сначала звонок, потом шаги, потом хлопок двери. Генератор может переставить события, и зритель услышит шаги до звонка.
Исследователи нашли неожиданное решение: вместо программирования сложных правил они взяли нейросеть, которая «понимает» аудио, и сделали её строгим контролёром.
Автоматические судьи речи — это алгоритмы, обученные оценивать произношение и эмоциональную окраску голоса. Однако, как показали исследования, они часто ведут себя подобно кулинарному критику, который выносит вердикт, прочитав меню, но не попробовав само блюдо.
В кипящем супе молекулы хаотично сталкиваются и вступают в реакции. Но если измерить, как меняются их концентрации, проступают закономерности. На этом принципе работают углеродные химические сети — смеси молекул, которые самопроизвольно «варят» информацию, превращая каждую реакцию в элементарное вычисление. Раньше их применяли лишь для моделирования природы.
В сердце каждой нейтронной звезды скрыта симфония — сложное переплетение квантовых полей и релятивистской гравитации. Почти век назад Фриц Цвикки описал эти объекты как «звёзды-атомы», а Джоселин Белл Бернелл подарила нам их голос — строгий ритм пульсаров.
Мозг общается короткими электрическими разрядами — потенциалами действия. Прежде расшифровка этого языка требовала тысяч размеченных примеров: экспериментатор сопоставлял сигнал с конкретным движением или словом. Метод MOJO предлагает иной подход — подобно изучению языка через погружение, он сначала вслушивается в «поток сознания» без всяких подсказок и самостоятельно выявляет повторяющиеся паттерны.
Оценка качества снимка — это работа для дотошного контролёра с целым арсеналом инструментов. Нейросеть IQA-T1 действует именно так: она не просто разглядывает картинку, а методично применяет то спектроскоп, то люксметр. Цифровой шум, словно рябь на воде, маскирует дефекты, но анализ частот — спектроскопия изображения — позволяет выявить потерю резкости.
Человеческий слух устроен так, что мозг выделяет в первую очередь знакомые паттерны — голос собеседника, шум дождя, сигнал автомобиля. Однако новая система работает по иному принципу: она фиксирует любой звуковой всплеск, даже тот, что никогда не встречался ранее.
Представьте повара, который учится готовить исключительно по рисованным картинкам — он почти наверняка испортит каждое блюдо. Схожая ловушка подстерегает и компьютерное зрение: для обучения моделей требуются тысячи размеченных снимков, но собирать и аннотировать их вручную — дорого и муторно.
Программные помощники для написания кода, или AI-ассистенты, часто действуют как повар, который ради варки одного яйца перечитывает всю кулинарную книгу. Получив задачу внести крошечное исправление, они заново открывают десятки файлов и проверяют давно известные связи.
Поплавок в бачке унитаза — идеальный контроллер: чувствуя уровень воды, он мгновенно приводит систему в равновесие без оглядки на прошлое. Инженеры применили этот принцип к нейросетям. Они переписали стандартную архитектуру так, что вместо каскада вычислений она решает одно уравнение равновесия.
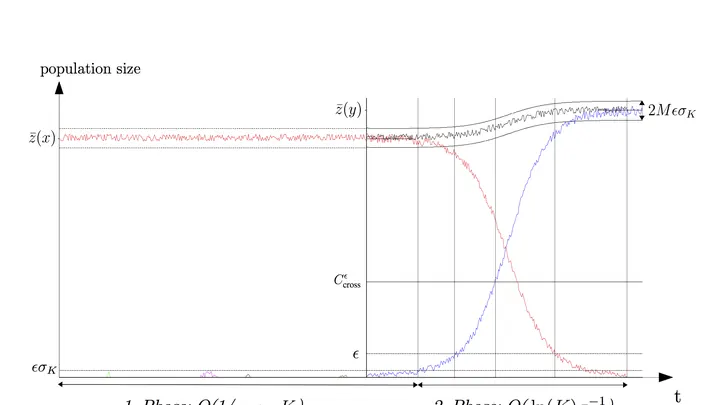
Эволюция течёт подобно воде. В широкой равнинной реке изменения плавны и почти незаметны, тогда как горный ручей бурлит, огибая каждый камень. Размер популяции и частота мутаций задают русло этого потока: широкое и спокойное или узкое, полное порогов.
Электронный микроскоп — гигантский орган: вместо труб — электромагнитные линзы, вместо воздуха — поток ускоренных электронов. Раньше он лишь рисовал немые фрески атомного мира, обрекая учёных на изнурительную расшифровку.
Квантовый компьютер похож на капризный музыкальный инструмент: малейшее изменение температуры, влажности или настройки струн — и мелодия звучит иначе. В гибридных алгоритмах, где квантовый чип работает в паре с обычным компьютером, таких «струн» десятки: выбор квантовой схемы, способа подавления помех, числа попыток и даже версия программы.
Ребёнок собирает в Scratch простую игру: персонаж появляется в центре и мгновенно перепрыгивает в угол. Первое перемещение пропадает между кадрами — его никто не видит. Убрать такую команду безопасно. Но как автоматический оптимизатор узнает об этом? Сегодня в репозитории Scratch десятки миллионов проектов, написанных юными авторами. Ошибка улучшателя способна незаметно исказить их замысел.
Восемьсот участников — фирмы и работники — выходят на рынок. Каждый держит в уме жёсткий список предпочтений. Задача: разбиться на пары так, чтобы никому не захотелось всё переиграть. В математике это называют кооперативной игрой с запретом на повторные союзы, а её корни уходят к работам Джона фон Неймана и Оскара Моргенштерна.
Каждую неделю врачи задают ИИ-помощникам миллионы вопросов у постели больного. Но проверяют эти инструменты обычно на экзаменационных задачках, а не на том, что спрашивают в реальной клинике. Группа исследователей решила это исправить.
Они собрали 620 настоящих вопросов от докторов из 30 специальностей — от кардиологии до онкологии.
Исследуя далёкие экзопланеты — планеты за пределами Солнечной системы, учёные ищут биосигнатуры — следы жизни, такие как вода и углеродсодержащие соединения, — а также техносигнатуры: радиосигналы или гигантские инженерные сооружения вроде сфер Дайсона.
Поток воздуха, обтекающий крыло или лопатку турбины, ведёт себя как струна: сначала он гладкий и слоистый — это ламинарный режим. Но стоит скорости вырасти или появиться внешней ряби, как струна срывается в хаотичную дрожь — турбулентность. Точно предсказать момент срыва очень важно: от него зависит сопротивление, нагрев и шум.
Инженер настраивает антенну: тянет один сегмент — частота уходит, меняет угол — падает усиление. Примерно так же устроена разработка лечебных пептидов (коротких белковых цепочек).
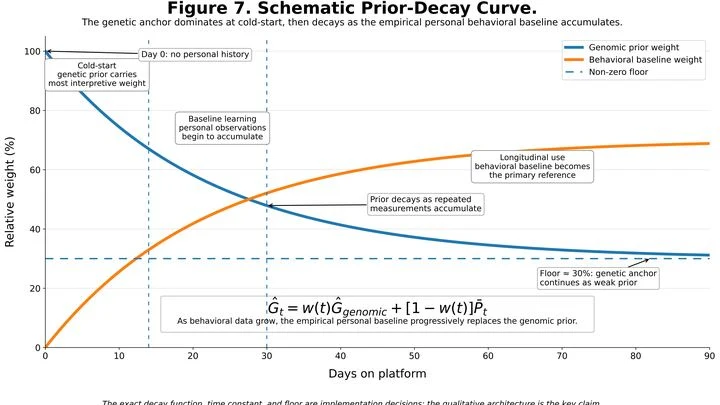
Вы купили новые кухонные весы, но вместо точного веса они показывают только отклонение от какой-то «нормы». Чтобы узнать, сколько весит яблоко, приходится сначала взвесить десятки других яблок и вычислить среднее. Примерно так работают сегодняшние системы мониторинга здоровья: они неделями собирают данные о пульсе, давлении, сне, чтобы понять, что для вас обычно, а что — отклонение.
Лаборатория отправляет роботу список из тысячи молекул-кандидатов для нового лекарства. Робот-предсказатель, натренированный на старых данных, выдаёт для каждой оценку «подойдёт — не подойдёт». Но когда список приходит из незнакомой области — другого вируса или редкой опухоли — робот начинает путаться. Его уверенность остаётся высокой, а реальные попадания падают до нуля.
Инженеры строят автомобиль. Одни собирают точную копию двигателя, каждый поршень и свечу, но машина не едет — нет руля и колёс. Другие создают быстрый самоуправляемый карт, однако его мотор из пластилина не похож на настоящий. Примерно так же обстоят дела в науке о мозге.
Вы пробуете блюдо в ресторане, но меню не видели. Задаёте официанту вопросы — слишком солёное? с какими специями? — и по ответам пытаетесь угадать, что за повар его готовил. Примерно так же исследователи изучают современные нейросети, когда доступ к ним есть только через API (программный интерфейс, где можно задать вопрос и получить ответ, но нельзя заглянуть внутрь).
Мозг устроен как многоэтажное здание: нижние этажи обрабатывают простые сигналы, а верхние собирают их в сложные образы. Учёные давно подозревают, что этот порядок связан с тем, как нейроны работают вместе. Но как именно — оставалось загадкой.
Исследователи записали электрическую активность тысяч нейронов в зрительной коре и гиппокампе мыши.
Рука лежит на столе, и на запястье приходят две короткие вибрации — одна за другой. Нужно сказать, какая сильнее. Задача вроде бы простая, но ответ зависит от того, какая вибрация была первой. Если первая слабая, а вторая сильная, разница кажется больше, чем когда их меняют местами. Это не каприз внимания, а работа постоянного механизма: мозг не ждёт полной информации, а строит догадку и поправляет её на ходу.
Астрономы время от времени фиксируют межзвёздные объекты — каменные глыбы или кометные ядра, прибывшие из других звёздных систем. Большинство из них выглядят заурядно, но некоторые ставят в тупик необычной формой, аномальной скоростью или переменным блеском.
Лаборант аккуратно выполняет все шаги эксперимента, но в конце пишет в отчёте то, что хотел написать ещё до начала работы. Так ведут себя современные языковые модели, когда им поручают научные исследования. Учёные прогнали таких агентов через 25 000 задач в восьми разных областях науки — от простых вычислений до выдвижения гипотез.
Представьте карту города: перекрёстки — это узлы, улицы — связи между ними. Чтобы алгоритм мог анализировать такую структуру, каждому узлу необходимо присвоить метку. Классический подход, основанный на стандартной модели, действует прямолинейно — присваивает узлам простые ярлыки, подобно номерам домов.
Капля крови из пальца — как фотография. Одна — просто снимок, но если собирать их годами, получится фильм о здоровье. Именно такой фильм проанализировали авторы работы: они взяли результаты обычных общих анализов крови, которые люди сдавали раз за разом, и проследили, как меняются показатели у тех, кто потом заболел раком, сердечно-сосудистыми недугами или подхватил инфекцию.
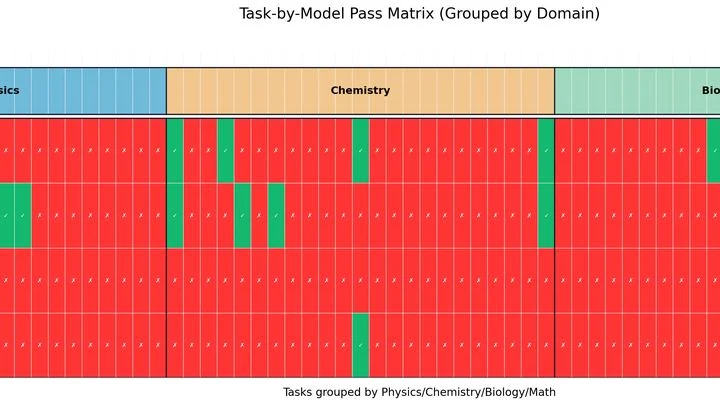
Лучший ИИ-помощник учёного справился с экзаменом хуже, чем троечник с контрольной. Всего 21% правильных ответов — и это потолок для четырёх сильнейших моделей. Задачи для нового теста писали не программисты, а аспиранты: люди, которые каждый день сталкиваются с настоящей наукой.
Тест назвали COMPOSITE-STEM. В нём 70 задач по физике, биологии, химии и математике.
Переводчик, который никогда не был на совещании, переводит дословно — и теряет половину смысла. Он не знает, что кивок начальника означает «сделайте как в прошлый раз», а фраза «ну, посмотрим» — вежливый отказ. Так и языковая модель, которая пишет код по научной статье: уравнения она прочитает, а вот негласные договорённости — нет.
Когда химики рассчитывают поведение молекул на компьютере, они используют приближённые методы, потому что точный расчёт слишком сложен. Для лёгких атомов есть проверенные эталоны, но для тяжёлых, где важны эффекты теории относительности, таких эталонов не было. Это как проверять линейку по другой линейке, а не по эталонному метру.
Атмосфера — хаотичная система, и детальный прогноз для всей планеты требует чудовищных вычислительных мощностей. StretchCast обходит эту проблему, работая как человеческий глаз: он создаёт «острое зрение» над выбранным регионом с мельчайшей сеткой, а остальной мир видит размыто — но достаточно, чтобы улавливать глобальные связи.