Часовая симуляция наводнений по всей Америке: за пределами традиционных и нейросетевых моделей ✛
Контекст
Наводнения, которые убивают и разрушают, часто развиваются за считанные часы после ливня, причём в местах без гидропостов. Прогноз, полезный для предупреждений, должен быть точным на пиках, надёжным для редких событий и покрывать всю речную сеть, а не только точки наблюдений. Рядом с этой работой в архиве лежат исследования о нейросетях, которые слышат «шёпот океана» за месяцы до шторма, о цифровом шлифовщике двойных гравитационных линз и о переводчике, выучившем язык океана, но все они решают задачи в других средах. В гидрологии соседние работы идут в русле распределённых моделей с обучением параметров: LSTM-RAPID, DROP, LSTM-TRoute, RiverMamba и серия δHBV. Однако все они либо работают на суточном шаге, либо не имеют явной маршрутизации, либо не включают инфильтрационный избыток, критичный для быстрых пиков.
Методы
Модель δHBV2.0MTS-MC — это дифференцируемая распределённая система генерации стока и маршрутизации. Она использует многомасштабную структуру: сначала суточная модель HBV прогоняется 351 день для инициализации состояний снега, влажности почвы и подземных резервуаров, затем эти состояния передаются почасовой модели HBV, которая считает сток для каждого из 800 000 элементарных бассейнов. Добавлены быстрый насыщенный сток и модуль инфильтрационного избытка (когда дождь интенсивнее, чем почва может впитать). Маршрутизация выполняется явным методом Мuskingum-Cunge по речной сети Hydrofabric с медианной площадью элемента 7.2 км². Все параметры генерируются нейросетями, которые принимают статические атрибуты бассейнов и участков рек; обучение сквозное, градиенты текут от ошибки на гидропостах через маршрутизацию и генерацию стока к параметрам. Обучение на одном GPU A100 заняло около пяти дней, а 10-летняя симуляция всей сети — около четырёх часов.
Результаты
На 2831 гидропосте континентальной части США медианная почасовая эффективность Нэша–Сатклиффа (NSE) составила 0.683 против 0.461 у операционной Национальной водной модели NWM3.0 и 0.359 у чисто нейросетевой LSTM-TRoute. Медианная эффективность Клинга–Гупты (KGE) выросла до 0.719, а абсолютное смещение снизилось до 10.24%. Для пиков с периодом повторяемости от 100 лет модель снижает ошибку величины пика на 34% по сравнению с MTS-LSTM. Модель улавливает на 33% больше наводнений с периодом повторяемости от 50 лет, чем NWM3.0, и на 159% больше, чем LSTM-TRoute, при жёстких критериях: ошибка величины не более 20% и ошибка времени не более 3 часов. Медианная ошибка времени пика сократилась с 7–8 часов у NWM3.0 до 4.5–6 часов. На малых бассейнах CAMELS модель достигает медианного NSE около 0.710, превосходя NWM3.0 (0.545) и сравнима с чисто нейросетевыми MTS-LSTM и MF-LSTM, но с заметно меньшими ошибками высоких расходов. Абляционные тесты показали, что многомасштабная инициализация поднимает NSE с 0.643 до 0.710 и снижает ошибку низких расходов с 69.27% до 51.37%; модуль инфильтрационного избытка почти не меняет агрегированные метрики, но снижает ошибки пиков во всех классах повторяемости; динамическая маршрутизация Muskingum-Cunge на больших бассейнах (площадью более 10 000 км²) уменьшает медианную ошибку величины пика с 40% до 32.5% по сравнению с фиксированным единичным гидрографом.
Значение
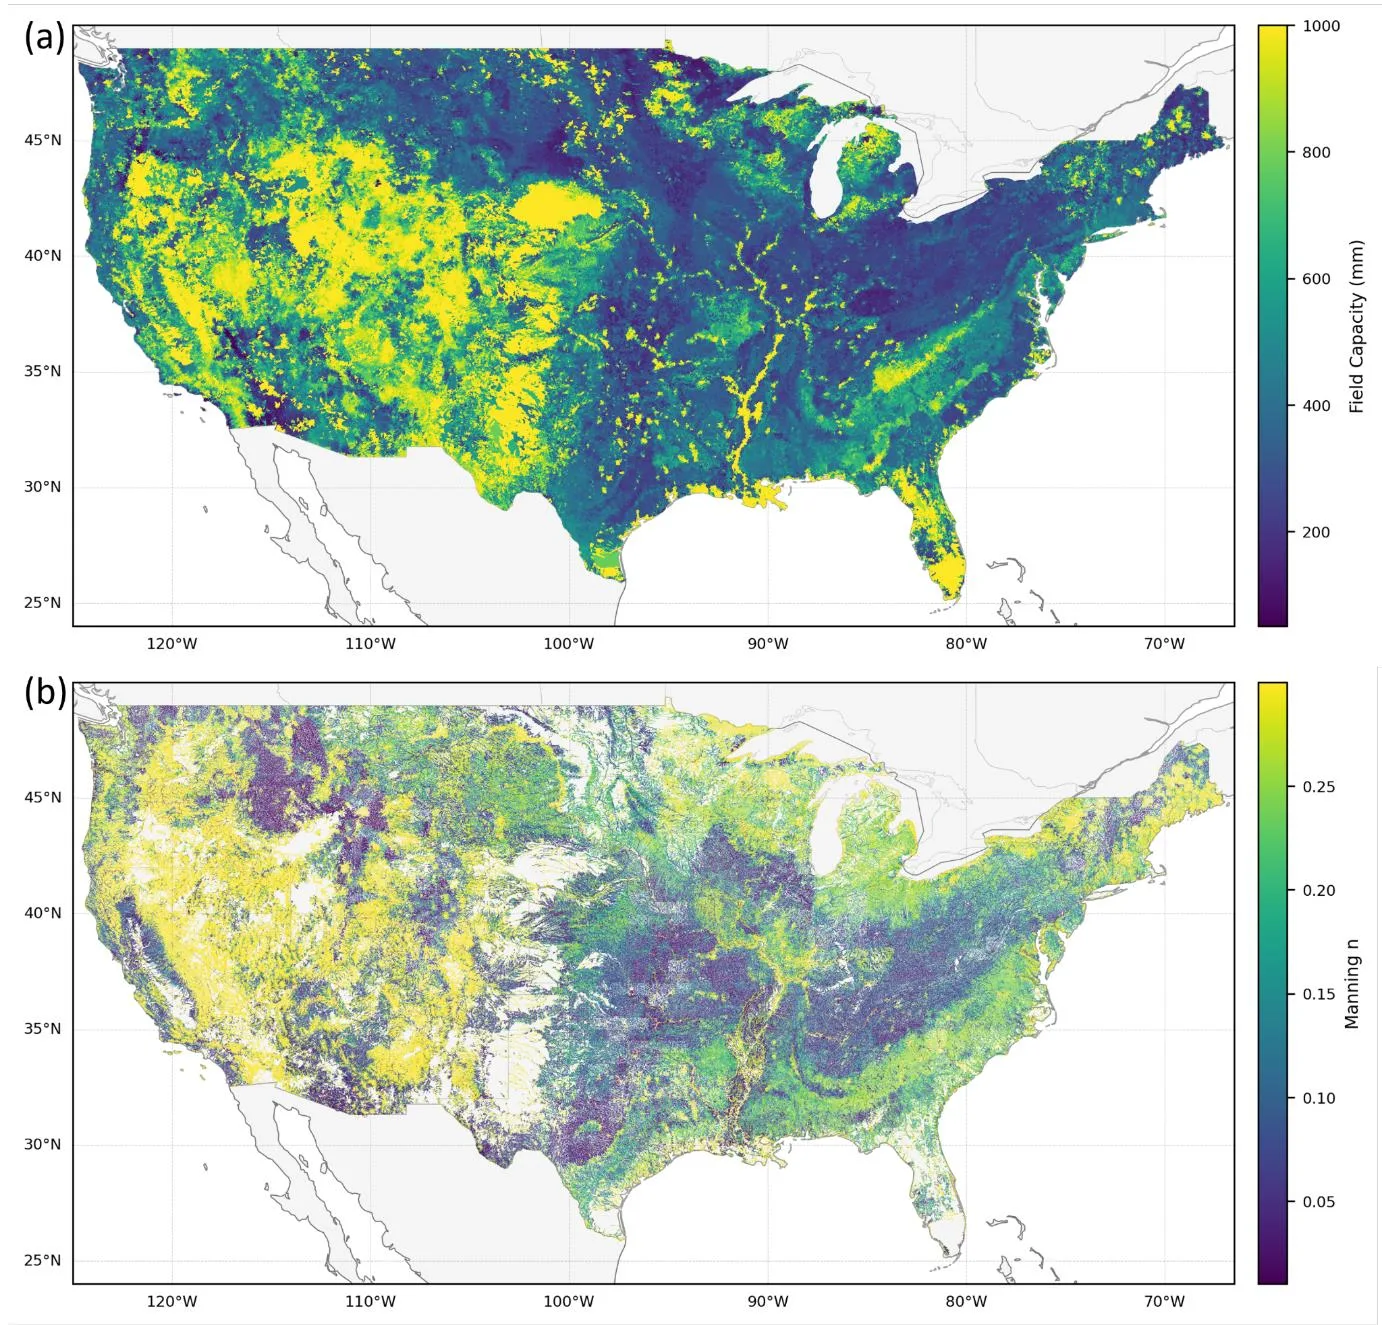
Работа стоит на отшибе среди соседей: ближайшие исследования в архиве касаются нейросетей для океана, гравитационных линз и погоды, но не почасовых наводнений на континентальном масштабе. Внутри гидрологии она отличается от предыдущих распределённых моделей тем, что впервые объединяет многомасштабную инициализацию, быстрый инфильтрационный избыток и явную маршрутизацию в одной дифференцируемой системе, обученной на больших данных. Это не просто улучшение метрик, а смена возможностей: модель выдаёт физически интерпретируемые параметры (например, полевую влагоёмкость и шероховатость Маннинга) для каждого из 800 000 участков рек, чего не могут дать чисто нейросетевые аналоги. Такие поля параметров раньше требовали лет ручной калибровки, а теперь генерируются за минуты.
Развитие
Тема может развиваться в сторону включения операций водохранилищ, водозаборов и пойменного хранения, что критично для самых крупных речных систем. Другое направление — улучшение качества метеорологических данных, особенно в засушливых и заснеженных бассейнах, где модель пока слабее. Вероятно появление умных ансамблей и вероятностного прогнозирования на основе обученных параметров, а также ассимиляции данных в реальном времени.
Влияние
Модель может напрямую заменить или дополнить Национальную водную модель США в операционных системах предупреждения о наводнениях. Её способность выдавать почасовой расход для каждого участка реки полезна для управления водохранилищами, оценки рисков и реагирования на внезапные паводки в ненаблюдаемых районах.
Следующие шаги
Ближайшие шаги включают проверку модели на бассейнах крупнее 50 000 км², где сейчас обучение не проводилось. Также необходимо провести эксперименты с исключением гидропостов из обучения, чтобы оценить точность в действительно ненаблюдаемых створах.
Ключевые проблемы
В гидрологии остаётся открытым вопрос надёжного прогноза редких наводнений в условиях меняющегося климата, когда исторические данные не отражают будущие экстремумы. Данная работа показывает, что гибридные модели с физическими ограничениями устойчивее чисто нейросетевых при экстраполяции на невиданные пики, но проблема точности в аридных и снеговых бассейнах остаётся нерешённой.
Взгляд машины знаний
Этот раздел адресован автору работы и его коллегам. Соседние работы нашёл смысловой поиск по нашему архиву — не по совпадению слов, а по смыслу. Мы не рецензируем: мы показываем поле вокруг.
Что сделано в работе
Работа представляет распределённую модель δHBV2.0MTS-MC для почасового прогноза наводнений по всей континентальной части США. Модель объединяет многомасштабную генерацию стока (суточная инициализация и почасовой расчёт) с явной маршрутизацией по речной сети, обучается сквозным образом на данных 2831 гидропоста и достигает медианного NSE 0.683, превосходя операционную NWM3.0 и нейросетевой базовый вариант, особенно для редких экстремальных наводнений.
В чём сила
Сильная сторона — дифференцируемая распределённая архитектура с явной маршрутизацией и модулем инфильтрационного избытка, что позволяет точнее воспроизводить быстрые пики и редкие наводнения, сохраняя физическую интерпретируемость.
Куда можно двигаться
- Может быть интересно посмотреть, как методы из работы о совместном моделировании воды и электричества в городе могут помочь связать речной сток с другими компонентами городской инфраструктуры, расширив модель на антропогенные воздействия.опора: Город как единый организм: вода и электричество дышат в такт arXiv:1902.10697
- Рядом лежит работа о нейросети, уловившей связь океана и речного стока; возможно, использование крупномасштабных климатических предикторов в качестве дополнительных входных данных улучшит прогнозы в долгосрочных горизонтах.опора: Океан дирижирует реками: как нейросеть услышала весь оркестр, а не только первую скрипку arXiv:2201.02596
- Идеи из работы по прогнозу погоды на месяц могут подсказать способы учёта неопределённости и ансамблевого подхода для вероятностных прогнозов наводнений.опора: Погода на месяц вперёд: что умеет машинное обучение arXiv:2006.07972
Что можно попробовать
- Апробировать добавление в модель городских водных потоков и водозаборов, используя подходы из 1902.10697.
- Проверить, улучшит ли включение индексов океанической изменчивости (например, из 2201.02596) точность прогнозов на сезонном масштабе.
- Построить ансамблевую версию модели с оценкой неопределённости, вдохновляясь методами из 2006.07972.
Почему это может быть важно
Улучшение почасовых прогнозов наводнений на континентальном масштабе с явной маршрутизацией и физически обоснованными компонентами может повысить точность предупреждений и снизить ущерб от внезапных наводнений, особенно в малоизученных районах.
Работы рядом в нашем архиве
- Как предсказать Эль-Ниньо за полгодаблизость 0.55
- Океан как пациент: нейросеть ставит диагноз на два года вперёдблизость 0.54
- Эль-Ниньо можно предсказать за полтора годаблизость 0.53
- Город как единый организм: вода и электричество дышат в тактблизость 0.53
- Переводчик, который выучил язык океанаблизость 0.52
- Учимся на множестве мозговблизость 0.52
- Океан дирижирует реками: как нейросеть услышала весь оркестр, а не только первую скрипкублизость 0.52
- Погода на месяц вперёд: что умеет машинное обучениеблизость 0.51
Вокруг этой работы в архиве пусто: ближайший разбор всего на 0.55, при обычных 0.64. Похоже, рядом почти не бурили.
Обучение всей модели для континентальной части США заняло около пяти дней на одном графическом процессоре A100, а симуляция 10 лет почасового стока для более чем 800 000 участков рек — всего около четырёх часов на том же GPU. Это на порядки быстрее, чем традиционная калибровка распределённых моделей, которая могла занимать годы.
В романе Кима Стэнли Робинсона «Министерство будущего» описана глобальная система прогнозирования климатических катастроф, которая предупреждает о наводнениях за часы до удара. Модель δHBV2.0MTS-MC — шаг к такой системе: она покрывает всю речную сеть страны и выдаёт прогноз каждый час, что позволяет предупреждать о внезапных паводках в ненаблюдаемых местах.
Ключевые числа
- медианная почасовая NSE: 0.683
- медианная почасовая NSE у NWM3.0: 0.461
- количество участков рек: 800 000+
- медианная площадь элементарного бассейна: 7.2 км²
- сокращение ошибки времени пика: с 7–8 часов до 4.5–6 часов