Quién trata mejor: ¿IA general o especialista de nicho? exprés
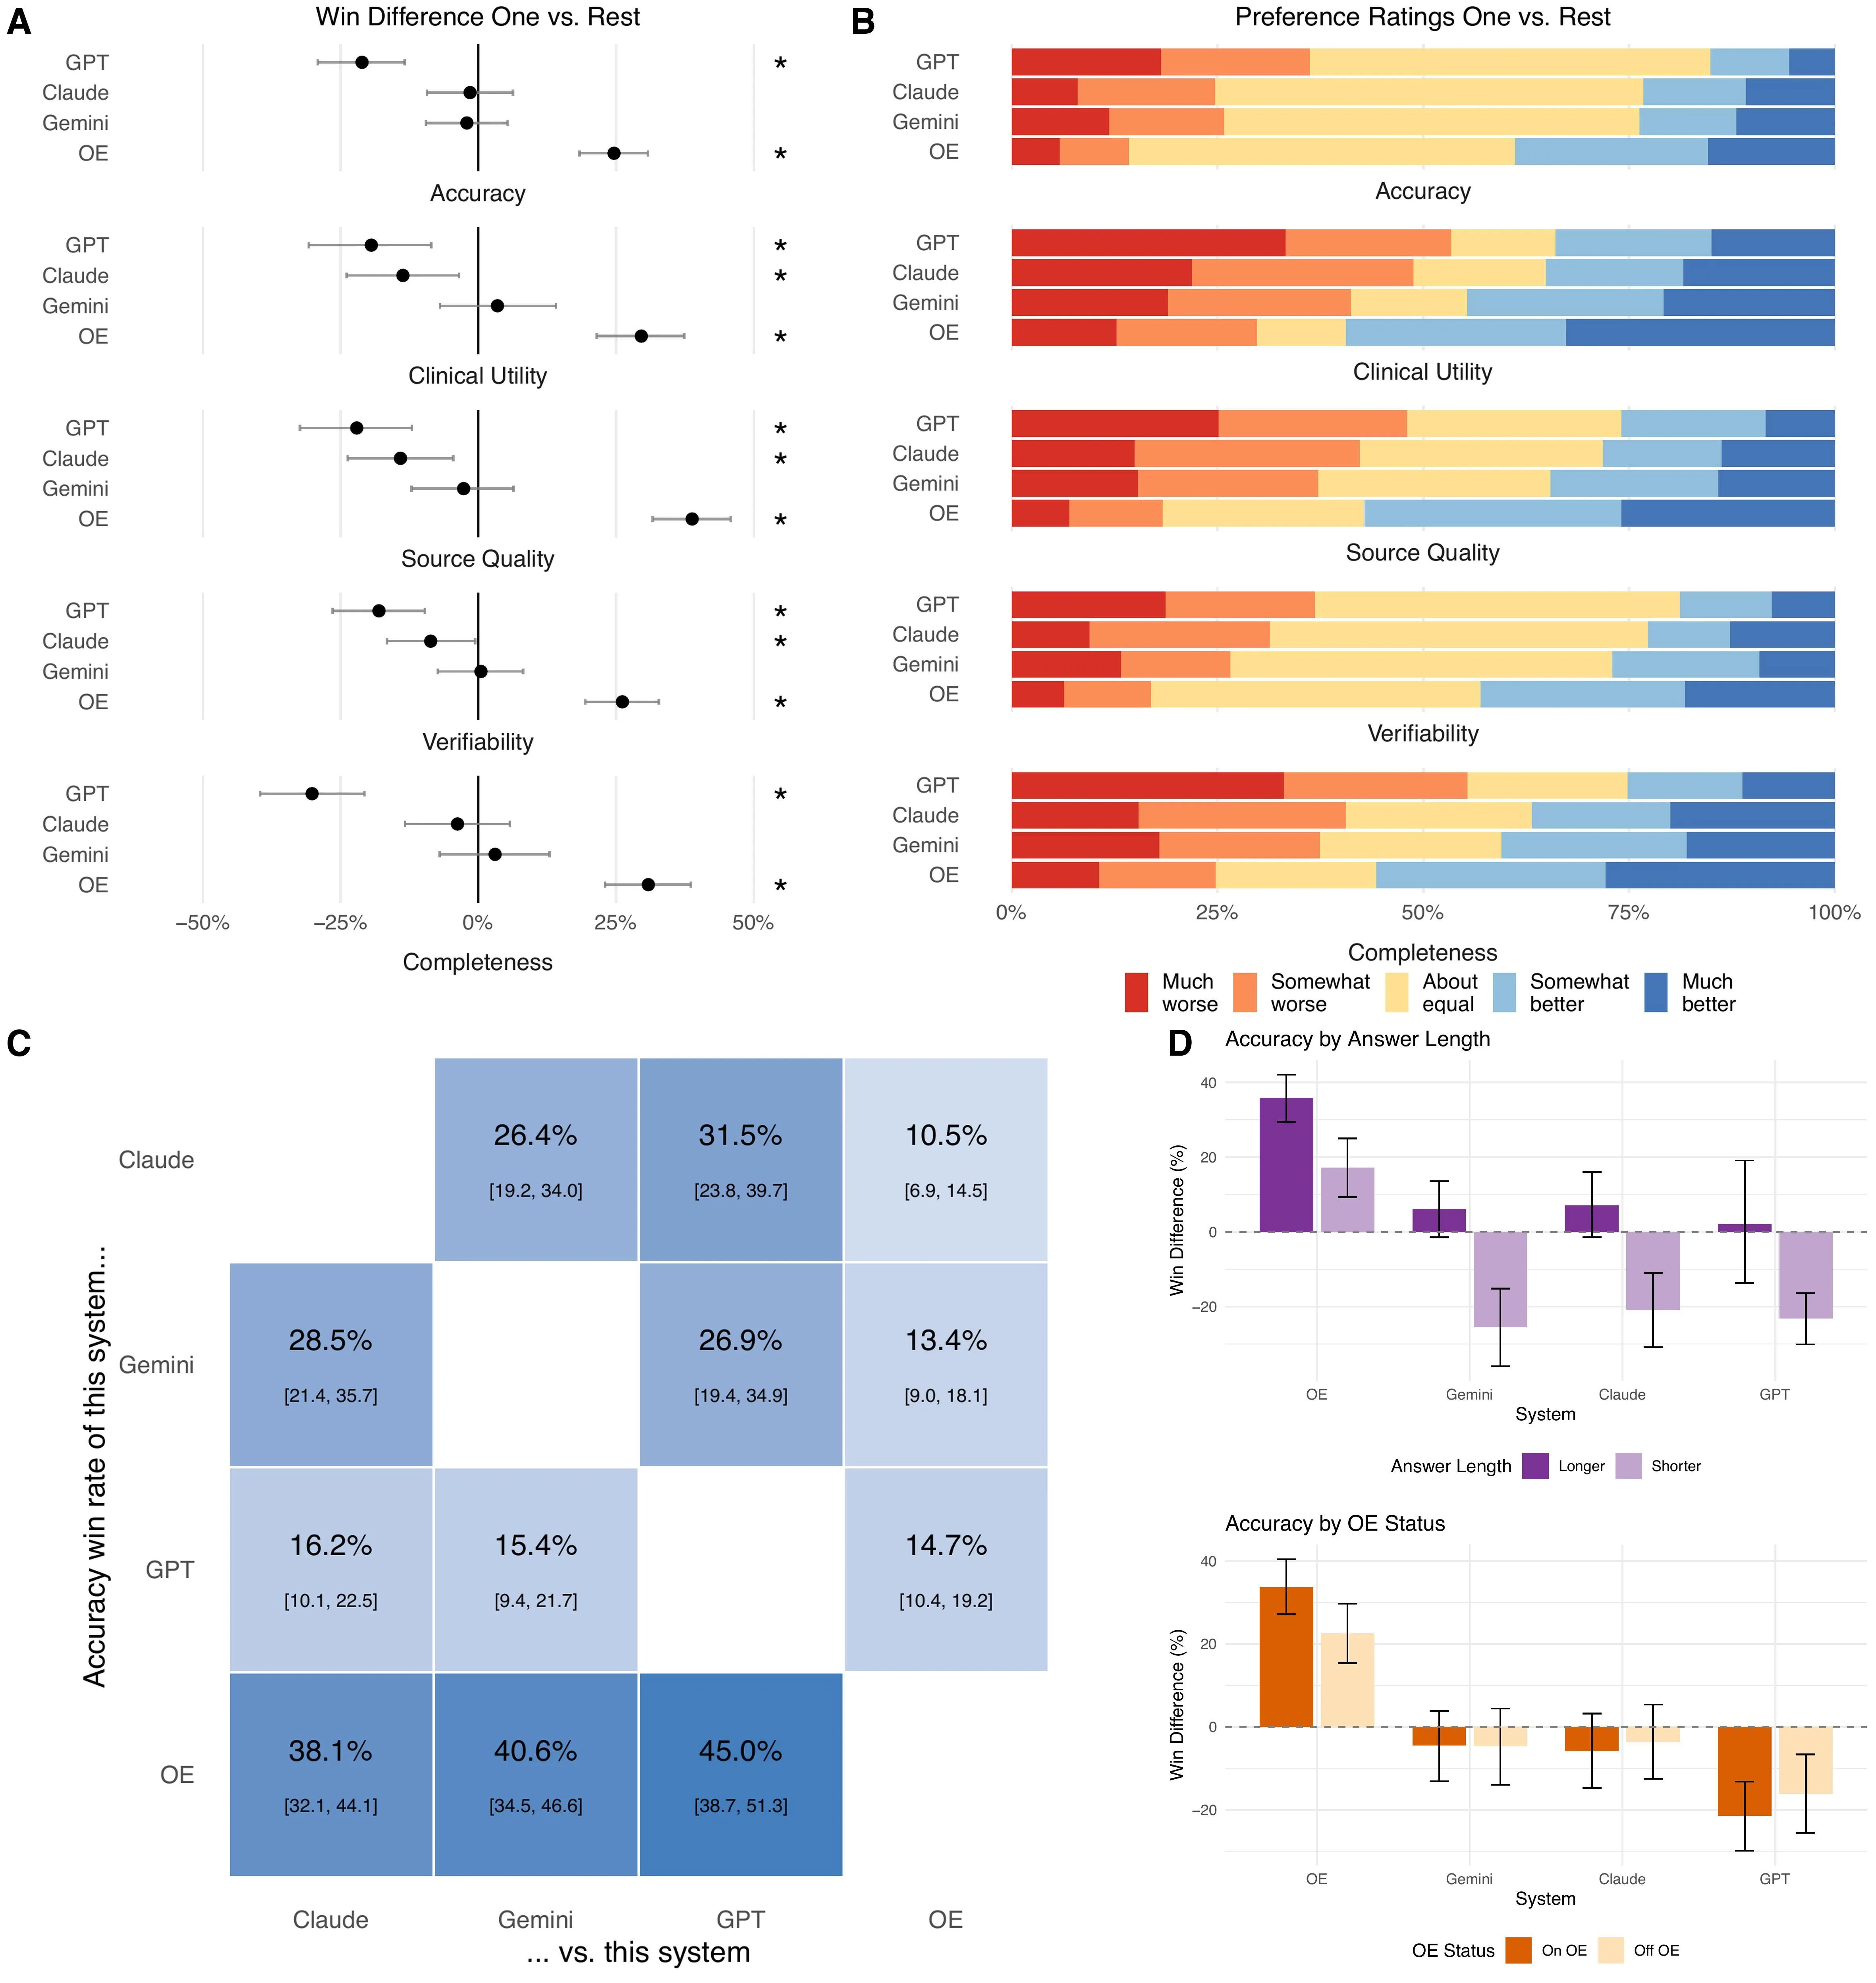
Cada semana, los médicos hacen millones de preguntas a los asistentes de IA junto a la cama del paciente. Pero estas herramientas suelen evaluarse con ejercicios de examen, no con lo que se pregunta en una clínica real. Un grupo de investigadores decidió cambiar eso.
Reunieron 620 preguntas reales de doctores de 30 especialidades, desde cardiología hasta oncología. Estas preguntas se plantearon a la plataforma OpenEvidence. Luego, 149 médicos en ejercicio de 36 estados compararon las respuestas de tres modelos generales insignia (Claude Opus 4.8, Gemini 3.1 Pro, GPT-5.5) y una herramienta médica especializada (OE). Cada juez pertenecía a la misma especialidad que el médico que había formulado la pregunta.
Se evaluaron cinco ejes: precisión, utilidad clínica, calidad de fuentes, verificabilidad y exhaustividad. La herramienta especializada ganó en todos. La diferencia entre victorias y derrotas fue de 25 a 39 puntos porcentuales, con una significación estadística enorme (p<0.001). El resultado no dependía de si se mostraban citas, de la longitud de la respuesta ni de si el juez había usado antes esa herramienta.
Las conclusiones son dos. Primera: la IA médica debe probarse con preguntas reales y con médicos de la misma especialidad; de lo contrario, el panorama queda incompleto. Segunda: la ventaja de la herramienta especializada no significa que los modelos generales sean inútiles. Muestra que un ajuste de ingeniería dirigido aporta un beneficio tangible para el usuario. Como un estetoscopio bien calibrado que oye lo que un micrófono universal pasa por alto.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2606.28960
Physicians now pose millions of clinical questions to AI tools each week, yet these tools are evaluated largely on hypothetical or exam-style questions, not those actually asked in practice. We report a blinded evaluation built on 620 Real-world Point-Of-Care Queries (Real-POCQi) submitted to the OpenEvidence (OE) platform by physicians spanning 30 specialties, as well as 187 questions from HealthBench. 149 practicing physicians across 36 states made head-to-head comparisons between answers from three frontier general-purpose models (Claude Opus 4.8, Gemini 3.1 Pro, and GPT-5.5) and a specialized clinical tool (OE), with graders matched to each question's specialty. When comparing answers along five dimensions relevant to clinical decision support -- accuracy, clinical utility, source quality, verifiability, & completeness -- physicians scored the specialized tool highest on all axes; in the primary analysis on Real-POCQi, win differences (margins between win and loss rates) ranged from 25 to 39 percentage points (p<0.001). Results remained consistent in sensitivity analyses stratifying by citation display, answer length, OE-user status, and Real-POCQi versus HealthBench. In parallel, LLM judges were found to systematically differ from expert judges, though both generally agreed on the best model. These findings underscore two conclusions: (i) AI tool evaluations should reflect real-world query distributions and use expert judges that mirror the specialization defining modern medicine and (ii) the consistent advantage of the specialized tool over general-purpose models does not necessarily mean that the latter cannot serve similar purposes, but that targeted engineering and customization can yield meaningful gains in performance for its users. We release Real-POCQi as a public benchmark, as well as the prespecified statistical analysis for reproducing results of this study.
La diferencia en victorias llegó a 39 puntos porcentuales: es como si un equipo ganara 7 de cada 10 partidos y el otro solo 3.