Quién trata mejor: ¿IA general o especialista de nicho? exprés
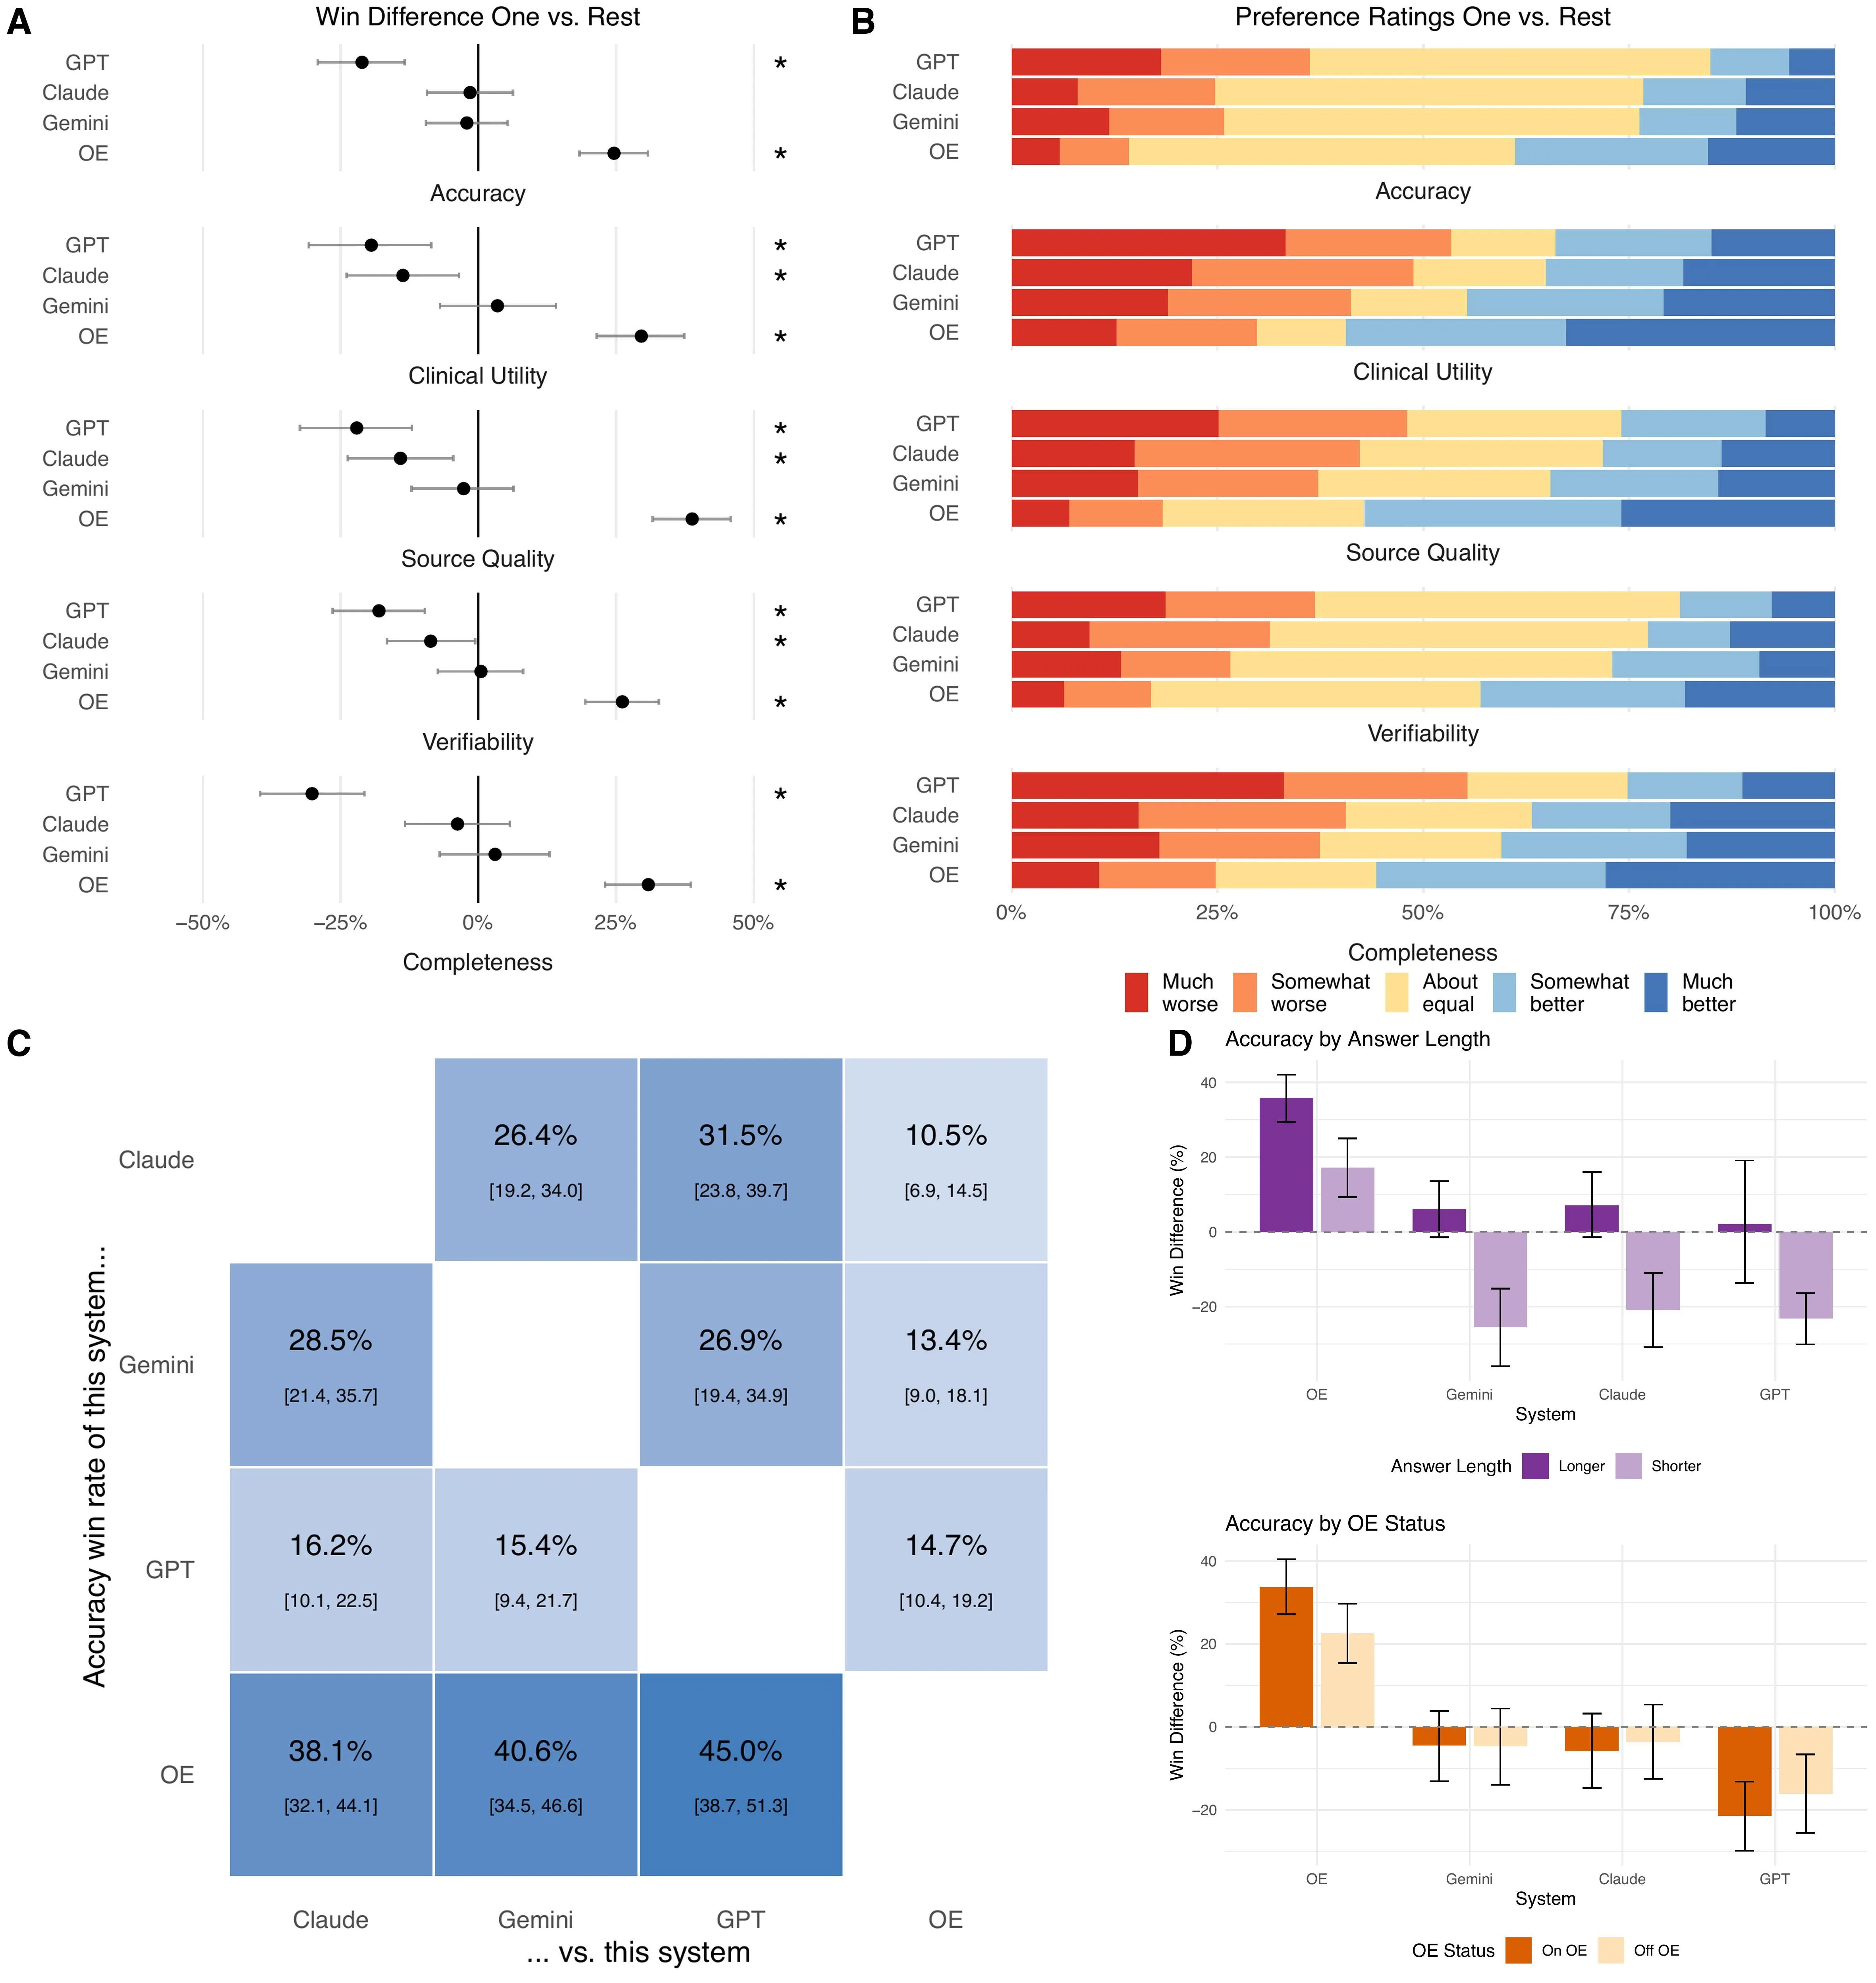
Cada semana, los médicos hacen millones de preguntas a los asistentes de IA junto a la cama del paciente. Pero estas herramientas suelen evaluarse con ejercicios de examen, no con lo que se pregunta en una clínica real. Un grupo de investigadores decidió cambiar eso.
Reunieron 620 preguntas reales de doctores de 30 especialidades, desde cardiología hasta oncología. Estas preguntas se plantearon a la plataforma OpenEvidence. Luego, 149 médicos en ejercicio de 36 estados compararon las respuestas de tres modelos generales insignia (Claude Opus 4.8, Gemini 3.1 Pro, GPT-5.5) y una herramienta médica especializada (OE). Cada juez pertenecía a la misma especialidad que el médico que había formulado la pregunta.
Se evaluaron cinco ejes: precisión, utilidad clínica, calidad de fuentes, verificabilidad y exhaustividad. La herramienta especializada ganó en todos. La diferencia entre victorias y derrotas fue de 25 a 39 puntos porcentuales, con una significación estadística enorme (p<0.001). El resultado no dependía de si se mostraban citas, de la longitud de la respuesta ni de si el juez había usado antes esa herramienta.
Las conclusiones son dos. Primera: la IA médica debe probarse con preguntas reales y con médicos de la misma especialidad; de lo contrario, el panorama queda incompleto. Segunda: la ventaja de la herramienta especializada no significa que los modelos generales sean inútiles. Muestra que un ajuste de ingeniería dirigido aporta un beneficio tangible para el usuario. Como un estetoscopio bien calibrado que oye lo que un micrófono universal pasa por alto.
La diferencia en victorias llegó a 39 puntos porcentuales: es como si un equipo ganara 7 de cada 10 partidos y el otro solo 3.