L'examen pour un scientifique IA express
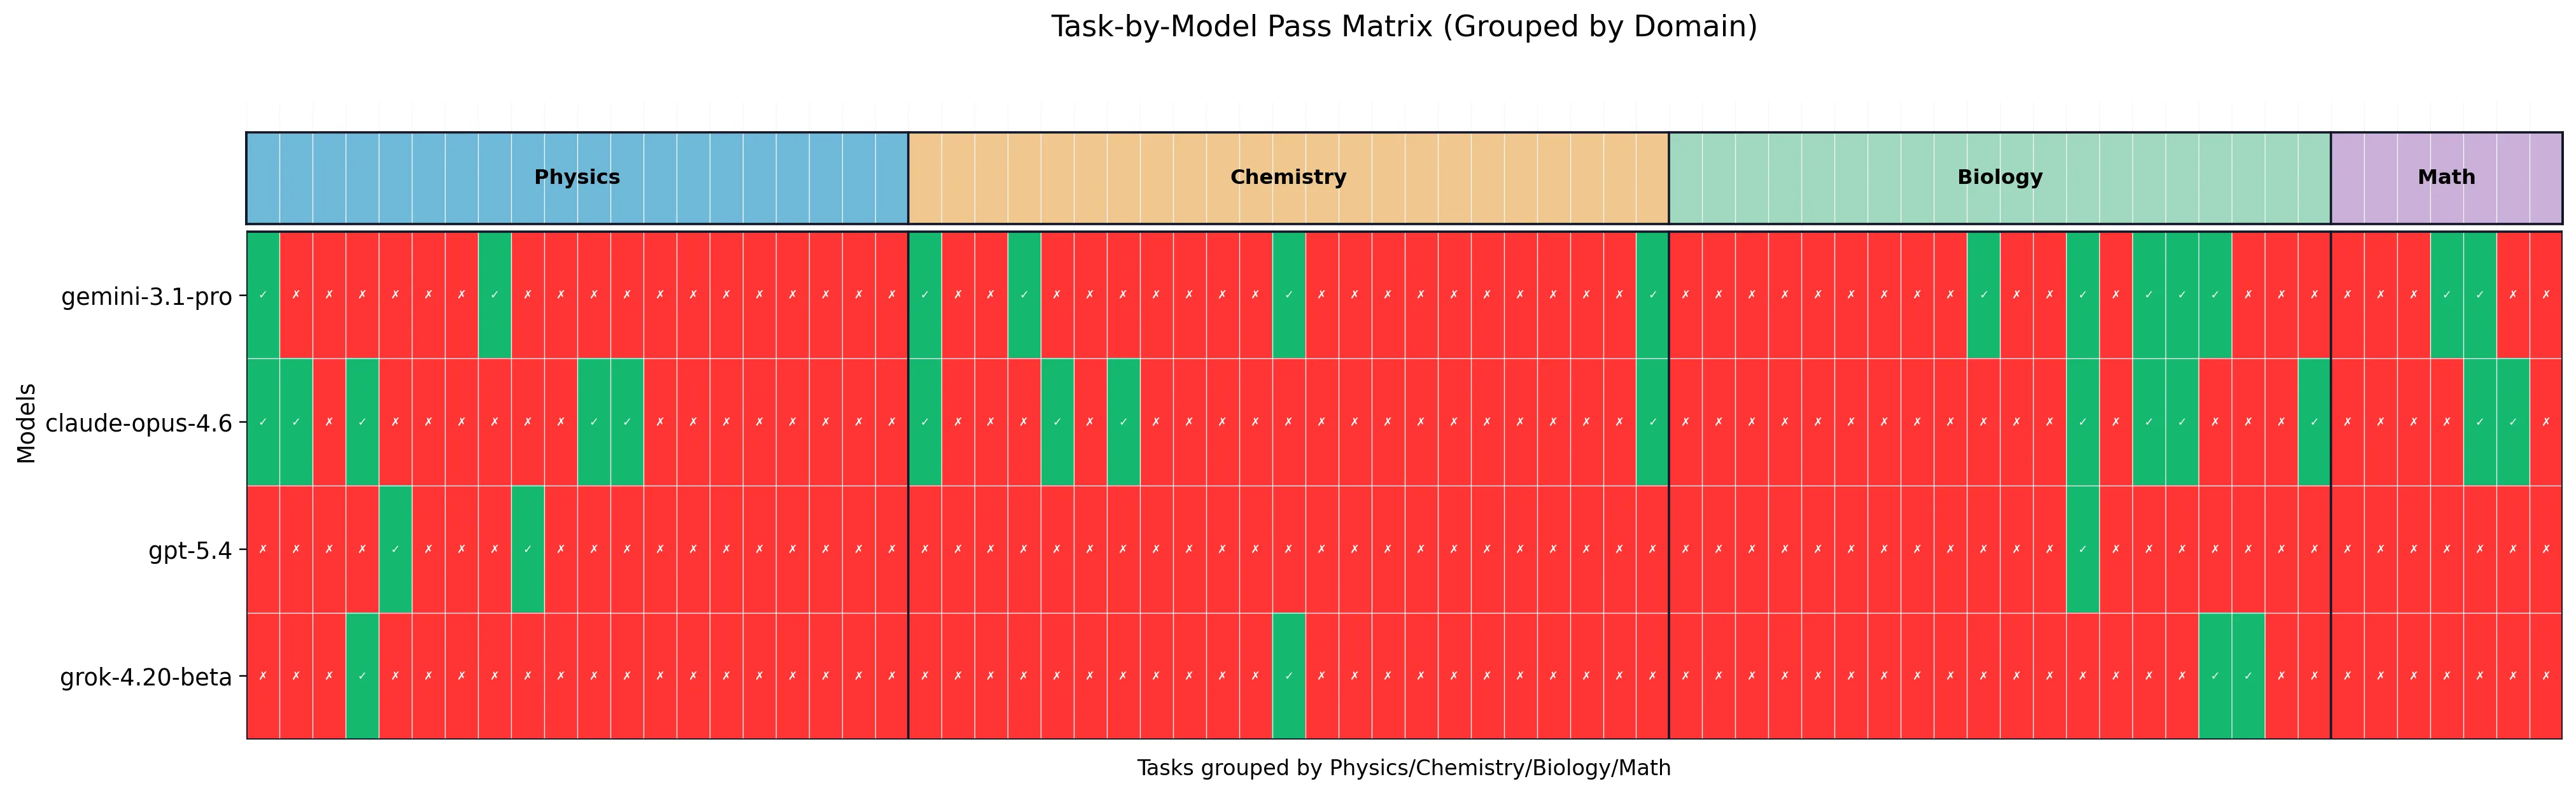
Le meilleur assistant IA pour scientifiques a réussi l'examen moins bien qu'un cancre à un contrôle. Seulement 21% de bonnes réponses – et c'est le plafond pour les quatre modèles les plus puissants. Les problèmes du nouveau test n'ont pas été écrits par des programmeurs, mais par des doctorants : des gens qui côtoient la vraie science au quotidien.
Le test s'appelle COMPOSITE-STEM. Il comprend 70 problèmes de physique, biologie, chimie et mathématiques. Contrairement aux exercices scolaires, il n'y a pas de réponse unique correcte – c'est le raisonnement qui est évalué. Par exemple, il ne s'agit pas seulement de calculer un nombre, mais d'expliquer pourquoi on a choisi telle méthode. La vérification se fait de deux manières : par comparaison précise des réponses et par le jugement d'un autre modèle de langage.
Le résultat est un électrochoc : même le meilleur modèle ne résout qu'un problème sur cinq. Cela signifie que l'IA est encore loin d'être un véritable assistant pour les scientifiques. Mais le test est ouvert à tous – tout développeur peut vérifier son modèle et tenter d'améliorer le score.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2604.09836
AI agents hold growing promise for accelerating scientific discovery; yet, a lack of frontier evaluations hinders adoption into real workflows. Expert-written benchmarks have proven effective at measuring AI reasoning, but most at this stage have become saturated and only measure performance on constrained outputs. To help address this gap, we introduce COMPOSITE-STEM, a benchmark of 70 expert-written tasks in physics, biology, chemistry, and mathematics, curated by doctoral-level researchers. Our benchmark combines exact-match grading and criterion-based rubrics with an LLM-as-a-jury grading protocol, allowing more flexible assessment of scientifically meaningful outputs. Using an adapted multimodal Terminus-2 agent harness within the Harbor agentic evaluation framework, we evaluate four frontier models. The top-performing model achieves 21%, demonstrating that COMPOSITE-STEM captures capabilities beyond current agent reach. All tasks are open-sourced with contributor permission to support reproducibility and to promote additional research towards AI's acceleration of scientific progress in these domains.
Les problèmes du test ont été collectés auprès de doctorants – ceux qui se souviennent encore de ce que c'est : rester penché sur une équation jusqu'au bout de la nuit et douter de chaque étape.