La reconnaissance vocale est la technologie qui permet aux machines de convertir la parole en texte ou en commandes. Elle consiste à analyser les signaux audio, à extraire des caractéristiques acoustiques et à les associer à des unités linguistiques telles que les phonèmes et les mots. Les systèmes modernes utilisent des réseaux de neurones profonds entraînés sur d'immenses quantités de données vocales pour atteindre une précision quasi humaine, même dans des environnements bruyants ou avec des accents variés.
Histoire
Les premières tentatives dans les années 1950 utilisaient une simple reconnaissance de formes pour les chiffres. Le domaine a progressé avec les modèles de Markov cachés dans les années 1980, mais la percée est survenue dans les années 2010 lorsque l'apprentissage profond a remplacé les modèles acoustiques traditionnels, améliorant considérablement la précision.
Comment ça marche
Le processus commence par la numérisation de la forme d'onde audio et sa division en trames courtes (par exemple, 25 ms). Pour chaque trame, des caractéristiques telles que les coefficients cepstraux en fréquences de Mel (MFCC) sont extraites, capturant la forme spectrale du son. Ces vecteurs de caractéristiques sont introduits dans un réseau de neurones — souvent une architecture récurrente ou à transformeurs — qui produit des probabilités sur les phonèmes ou caractères possibles. Un modèle de langage combine ensuite ces probabilités avec des contraintes linguistiques pour produire la séquence de texte la plus probable. Les modèles de bout en bout récents (par exemple, Whisper, DeepSpeech) apprennent directement la correspondance complète entre l'audio et le texte, contournant l'alignement explicite des phonèmes.
En pratique
La reconnaissance vocale alimente les assistants virtuels (Siri, Alexa), les services de transcription automatisée, les appareils commandés par la voix et le sous-titrage en temps réel pour les malentendants.
Anecdote
Les systèmes modernes de reconnaissance vocale sont si sensibles qu'ils peuvent être trompés par des commandes ultrasonores inaudibles cachées dans des enregistrements audio, une vulnérabilité de sécurité découverte en 2017.
Dans les années 1980, le concours DARPA de reconnaissance vocale a mis fin au débat entre les méthodes statistiques et les règles écrites à la main, établissant une norme unique pour tout le domaine.
Le cerveau ressemble à un orchestre dont le chef est le cortex et le premier violon, le thalamus. Le thalamus transmet les signaux des yeux vers le cortex visuel. Mais le cortex peut aussi renvoyer des commandes en retour, ajustant le thalamus à la tâche en cours. Cela n'était auparavant qu'une hypothèse, désormais testée sur des humains.
La recherche d'un nouveau matériau ressemble à la cuisine sans recette : on essaie, on essaie, et souvent on jette. Avant, les scientifiques feuilletaient les articles à la main et testaient les compositions une par une. Maintenant, un « robot-cuisinier » est apparu, qui lit lui-même la littérature, mélange les composants et regarde ce que ça donne.
Le magnétoencéphalographe, un appareil qui ressemble à un casque muni de centaines de capteurs, capte les faibles champs magnétiques produits par les neurones en activité. Lorsqu'une personne écoute de la parole, ces signaux renferment des empreintes des mots entendus.
Chaque matin, des dizaines de télescopes se braquent sur le Soleil. Leurs caméras capturent une fine bande de lumière rouge : la raie Hα, découverte par Johann Jakob Balmer. Sur les images, des filaments sombres et capricieusement incurvés apparaissent.
L'esprit humain ressemble à un jeu de construction qui s'auto-construit. Les nouvelles idées ne meurent pas avec leur créateur : elles se transmettent, se mélangent et sont sélectionnées. Ce processus est appelé évolution culturelle : les inventions utiles se consolident, les inutiles tombent dans l'oubli. C'est le principe du cliquet, ce mécanisme qui ne tourne que dans un sens.
Un artiste fait un croquis rapide au fusain – et le visage sur le portrait est déjà reconnaissable. Les astrophysiciens résolvent un problème similaire : le spectre d'une étoile est son portrait individuel, révélant température, composition, gravité.
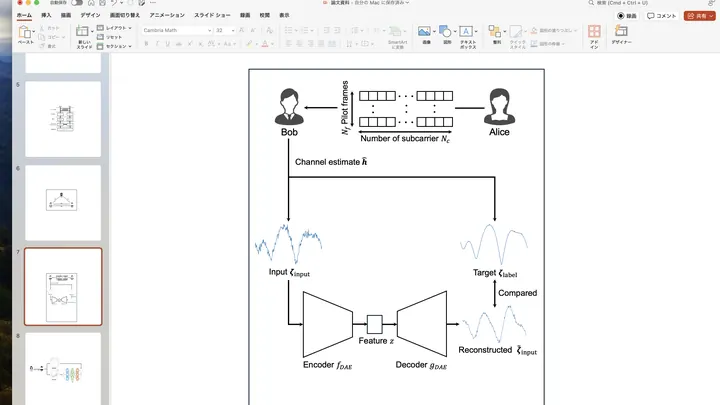
Lorsque deux téléphones tentent de créer une clé secrète commune à partir des propriétés aléatoires des ondes radio, les interférences rendent leurs mesures imprécises. C'est comme deux personnes qui regardent un reflet dans une vitre embuée : chacun voit une silhouette floue, et il est impossible de discerner une image claire.
En plein combat, un pilote doit comprendre instantanément ce qu'est un objet et quelles sont ses intentions. Les systèmes conventionnels attendent des données radar complètes – c'est comme un gardien qui ne réagit qu'après le tir. Le nouvel algorithme, lui, agit comme un gardien chevronné : dès les premiers mouvements de l'attaquant, il anticipe la manœuvre de la cible.
Les signaux radio dans une pièce se comportent comme le son dans une salle de concert : en se réfléchissant sur les murs et les objets, ils créent une empreinte unique — la mélodie silencieuse de chaque lieu. Le téléphone, telle une oreille attentive, capte cette mélodie dans le bruit et les distorsions. Il mémorise quel accord correspond au coin du canapé, et lequel à l'embrasure de la porte.
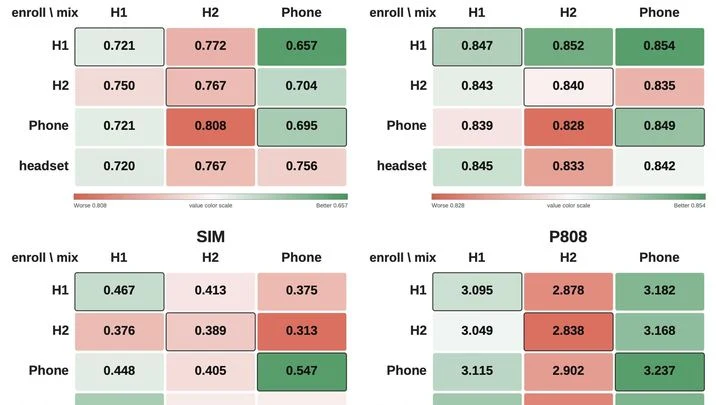
Un humain extrait sans effort la voix qu'il cherche du brouhaha d'une fête. Pour un ordinateur, c'est encore une tâche à la limite du possible. Les programmes précédents étaient entraînés sur des enregistrements stériles, sans écho ni tintement de couverts.
L'intelligence artificielle qui prédit l'acoustique d'une salle fait penser à un étudiant qui triche à l'examen avec une antisèche. Si les points de validation sont les mêmes que ceux de l'entraînement, le modèle se contente de mémoriser l'« empreinte » sonore de chaque position, comme un étudiant qui reconnaît un sujet grâce à un coin de page plié.
Les modèles qui transforment le texte en audio reproduisent bien les sons isolés, mais se mélangent les pinceaux quand le scénario en comporte plusieurs. Par exemple, selon le scénario, on a d'abord une sonnerie, puis des pas, puis un claquement de porte. Le générateur peut intervertir les événements, et le spectateur entendra les pas avant la sonnerie.
Un signal radio à modulation en couches évoque les strates d'une cité antique : chaque niveau porte sa propre information, mais avec le temps, ils s'emmêlent à cause des interférences. Les algorithmes classiques se perdent dans ce fouillis. La nouvelle méthode TSDN agit comme un réseau de neurones archéologue.
Les juges automatiques de la parole sont des algorithmes qui évaluent la prononciation et les émotions. Cependant, ils fonctionnent souvent comme un critique culinaire qui rend son verdict après avoir lu le menu, sans avoir goûté le plat.
Apprendre une langue étrangère, c'est comme accorder un instrument de musique. La nouvelle technologie agit comme un accordeur intelligent : elle prend votre enregistrement et la parole de référence d'un natif, les étire ou les compresse dans le temps (comme on tend une corde) pour les aligner précisément, puis évalue trois paramètres clés : la pureté des sons, la…
Le cerveau communique par de brefs clics électriques. Autrefois, pour apprendre cette langue, il fallait des milliers d'exemples traduits par l'expérimentateur. La méthode MOJO suit une autre voie : comme dans l'apprentissage par immersion, elle écoute d'abord le « flux de conscience » sans aucune indication et repère elle-même les motifs récurrents.
Les assistants vocaux font souvent penser à un cuisinier qui lit une recette sur un bout de papier sans la moindre once d'appétit. La nouvelle archive de dialogues russes « Dialogues » change la donne : trois comédiens en studio, tels des chefs, ont mixé 20 heures de conversations vivantes avec douze « épices » émotionnelles.
Le son se décrit naturellement par un nombre complexe, où le volume représente la force de l'onde et la phase sa position dans le temps. Les réseaux de neurones classiques séparent ces deux aspects en coordonnées indépendantes, un peu comme si l'on donnait une adresse par quartiers : « deux à l'est, un au nord ».
Les aides auditives traditionnelles ressemblent à un cuisinier qui prépare une recette à l'aveugle. Elles analysent le désordre sonore entropique capté par le microphone et, sur cette base, amplifient la parole. Dans un café bruyant, cette approche se trompe souvent.
Dans une pièce bruyante, l'humain distingue la voix recherchée grâce à ses deux oreilles, qui perçoivent une différence dans l'arrivée du son. Un ordinateur équipé de plusieurs microphones agit de la même manière : il reçoit des indices spatiaux — d'où vient chaque voix.
L'oreille humaine se concentre sur ce qui lui est familier, mais ce nouveau système fonctionne autrement : il capte tout pic sonore, même celui qui n'a jamais été entendu auparavant. C'est la diarisation audio — pas simplement la recherche de bruits précis, mais le découpage de tout l'enregistrement en segments où l'on note le début et la fin de chaque événement.
Un réseau neuronal qui génère des sons à partir de texte, c'est un peu comme une cuisine où chaque « plat » est préparé par des dizaines de cuisiniers. Beaucoup ne font que gêner : ils envoient des signaux erronés et gaspillent des ressources.
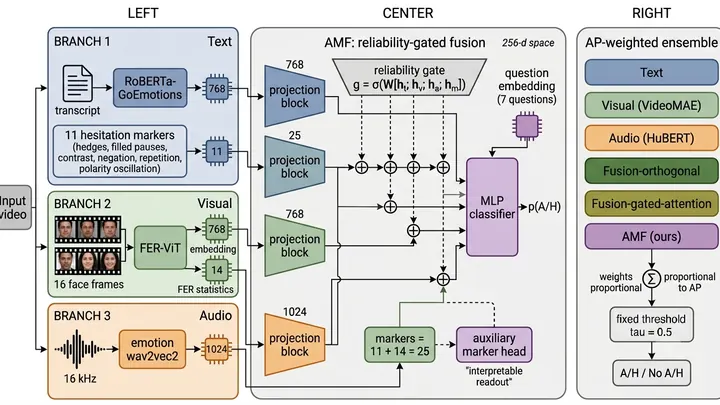
Un nouveau système analyse un court entretien pour reconnaître les doutes d'une personne, en combinant texte, voix et expressions faciales. Mais la clé principale de l'incertitude s'est révélée être la matière noire de la parole : les pauses et les mots de remplissage que les systèmes vocaux standard effacent comme un trou noir.
Le flotteur dans la chasse d'eau est un contrôleur idéal : en sentant le niveau de l'eau, il ramène instantanément le système à l'équilibre sans se soucier du passé. Des ingénieurs ont appliqué ce principe aux réseaux de neurones.
Un grand réseau de neurones, comme Whisper, maîtrise des centaines de langues et ressemble au modèle standard de l'univers : tout est équilibré. Mais l'apprentissage d'une langue rare rompt cet équilibre — elle se transforme en trou noir qui attire toutes les ressources d'apprentissage.
La méthode standard de numérisation de la parole : on mesure le volume des milliers de fois par seconde. C'est comme goûter un bouillon avec une cuillère à café — chaque gorgée est aqueuse, et il n'y a presque pas de détails. Le flux de données enfle, alors que le sens se compte sur les doigts.
Les chercheurs ont proposé de « réduire » d'abord le signal sonore.
Dans la salle d'audience, une chaîne de caractères est présentée en entrée. Douze jurés (les chemins de calcul) l'examinent symbole par symbole. Chacun peut déclarer « coupable » (accepter) ou « non coupable ». Pour un automate non déterministe ordinaire (NFA), un seul vote « pour » suffit.
Les cent vingt habitants de Montelago ne sont pas des personnes, mais des personnages numériques. Chacun, en plus de son nom et de sa biographie, possède trois coordonnées cachées : la confiance envers les autorités municipales, l'évaluation de la fiabilité de la source, la pertinence perçue de l'information.
Les modèles statistiques sont une tentative de tendre une toile mathématique idéale sur le paysage accidenté des données. Lorsque le modèle résiste, il émet une tension, mais nous avons pris l'habitude de l'ignorer. Les chercheurs passent des heures à scruter les graphiques de résidus, essayant de deviner où le modèle « craque ». Squealer traduit cette résistance en son.
La caméra d'un smartphone filme tout, tandis que l'œil saisit immédiatement l'essentiel. La rétine ne se contente pas de transmettre l'image au cerveau : sur place, elle accentue les contours, atténue le bruit superflu et s'ajuste à la luminosité.
Dans une éprouvette, des molécules flottent. Leur quantité — disons, la concentration d'une certaine protéine — devient le signal d'entrée. Et à la sortie, on ne veut pas juste une solution trouble, mais une réponse claire du genre « oui » ou « non ».
Les auteurs de l'étude construisent une chaîne chimique qui fait exactement cela.
Le satellite MethaneSAT traque les fuites de méthane — un gaz invisible mais qui réchauffe fortement la planète. Son « nez » est un spectromètre, un instrument qui détecte le plus infime changement de couleur de la lumière traversant l'atmosphère. C'est la trace que laisse le méthane.
La main trace dans l'air le mot « maman » — des arcs et des bâtons familiers. Le cerveau, lui, ne fait pas défiler la photo de chaque lettre. Il déclenche une chaîne de mouvements simples. Des neuro-ingénieurs ont testé cette idée : l'écriture mentale n'est pas une galerie d'images toutes faites, mais un jeu de construction à partir des mêmes « briques » motrices.
Un spectre, c'est un peu comme une photographie de la structure interne d'une substance, prise avec de la lumière. Lorsque le faisceau traverse l'échantillon ou s'y réfléchit, les molécules laissent sur ce cliché des bandes sombres caractéristiques : les pics. Mais si la photo est surexposée ou voilée de gris, distinguer les détails devient presque impossible.
Un peintre compose son tableau en observant le spectateur dans la salle. Si le spectateur sourit, le peintre ajoute plus de rouge et de courbes ; s'il fronce les sourcils, il retire le bleu et casse les angles.
Une mélodie joue — et le cerveau ne se contente pas d'écouter note après note. Il agit comme un chef d'orchestre qui connaît déjà la partition : chaque note suivante est attendue, car les précédentes résonnent encore en mémoire. Mais comment les neurones retiennent-ils cet écho ?
Chaque fois que vous hésitez devant un pas risqué — investir dans des actions ou attendre — un dialogue interne se déroule dans votre tête. Habituellement, les scientifiques tentent de reconstituer le fil de ce dialogue à partir du seul choix final, comme si un détective reconstituait une conversation entre deux personnes en regardant une photo du lieu de rencontre.