Qui soigne le mieux : l'IA généraliste ou le spécialiste ? express
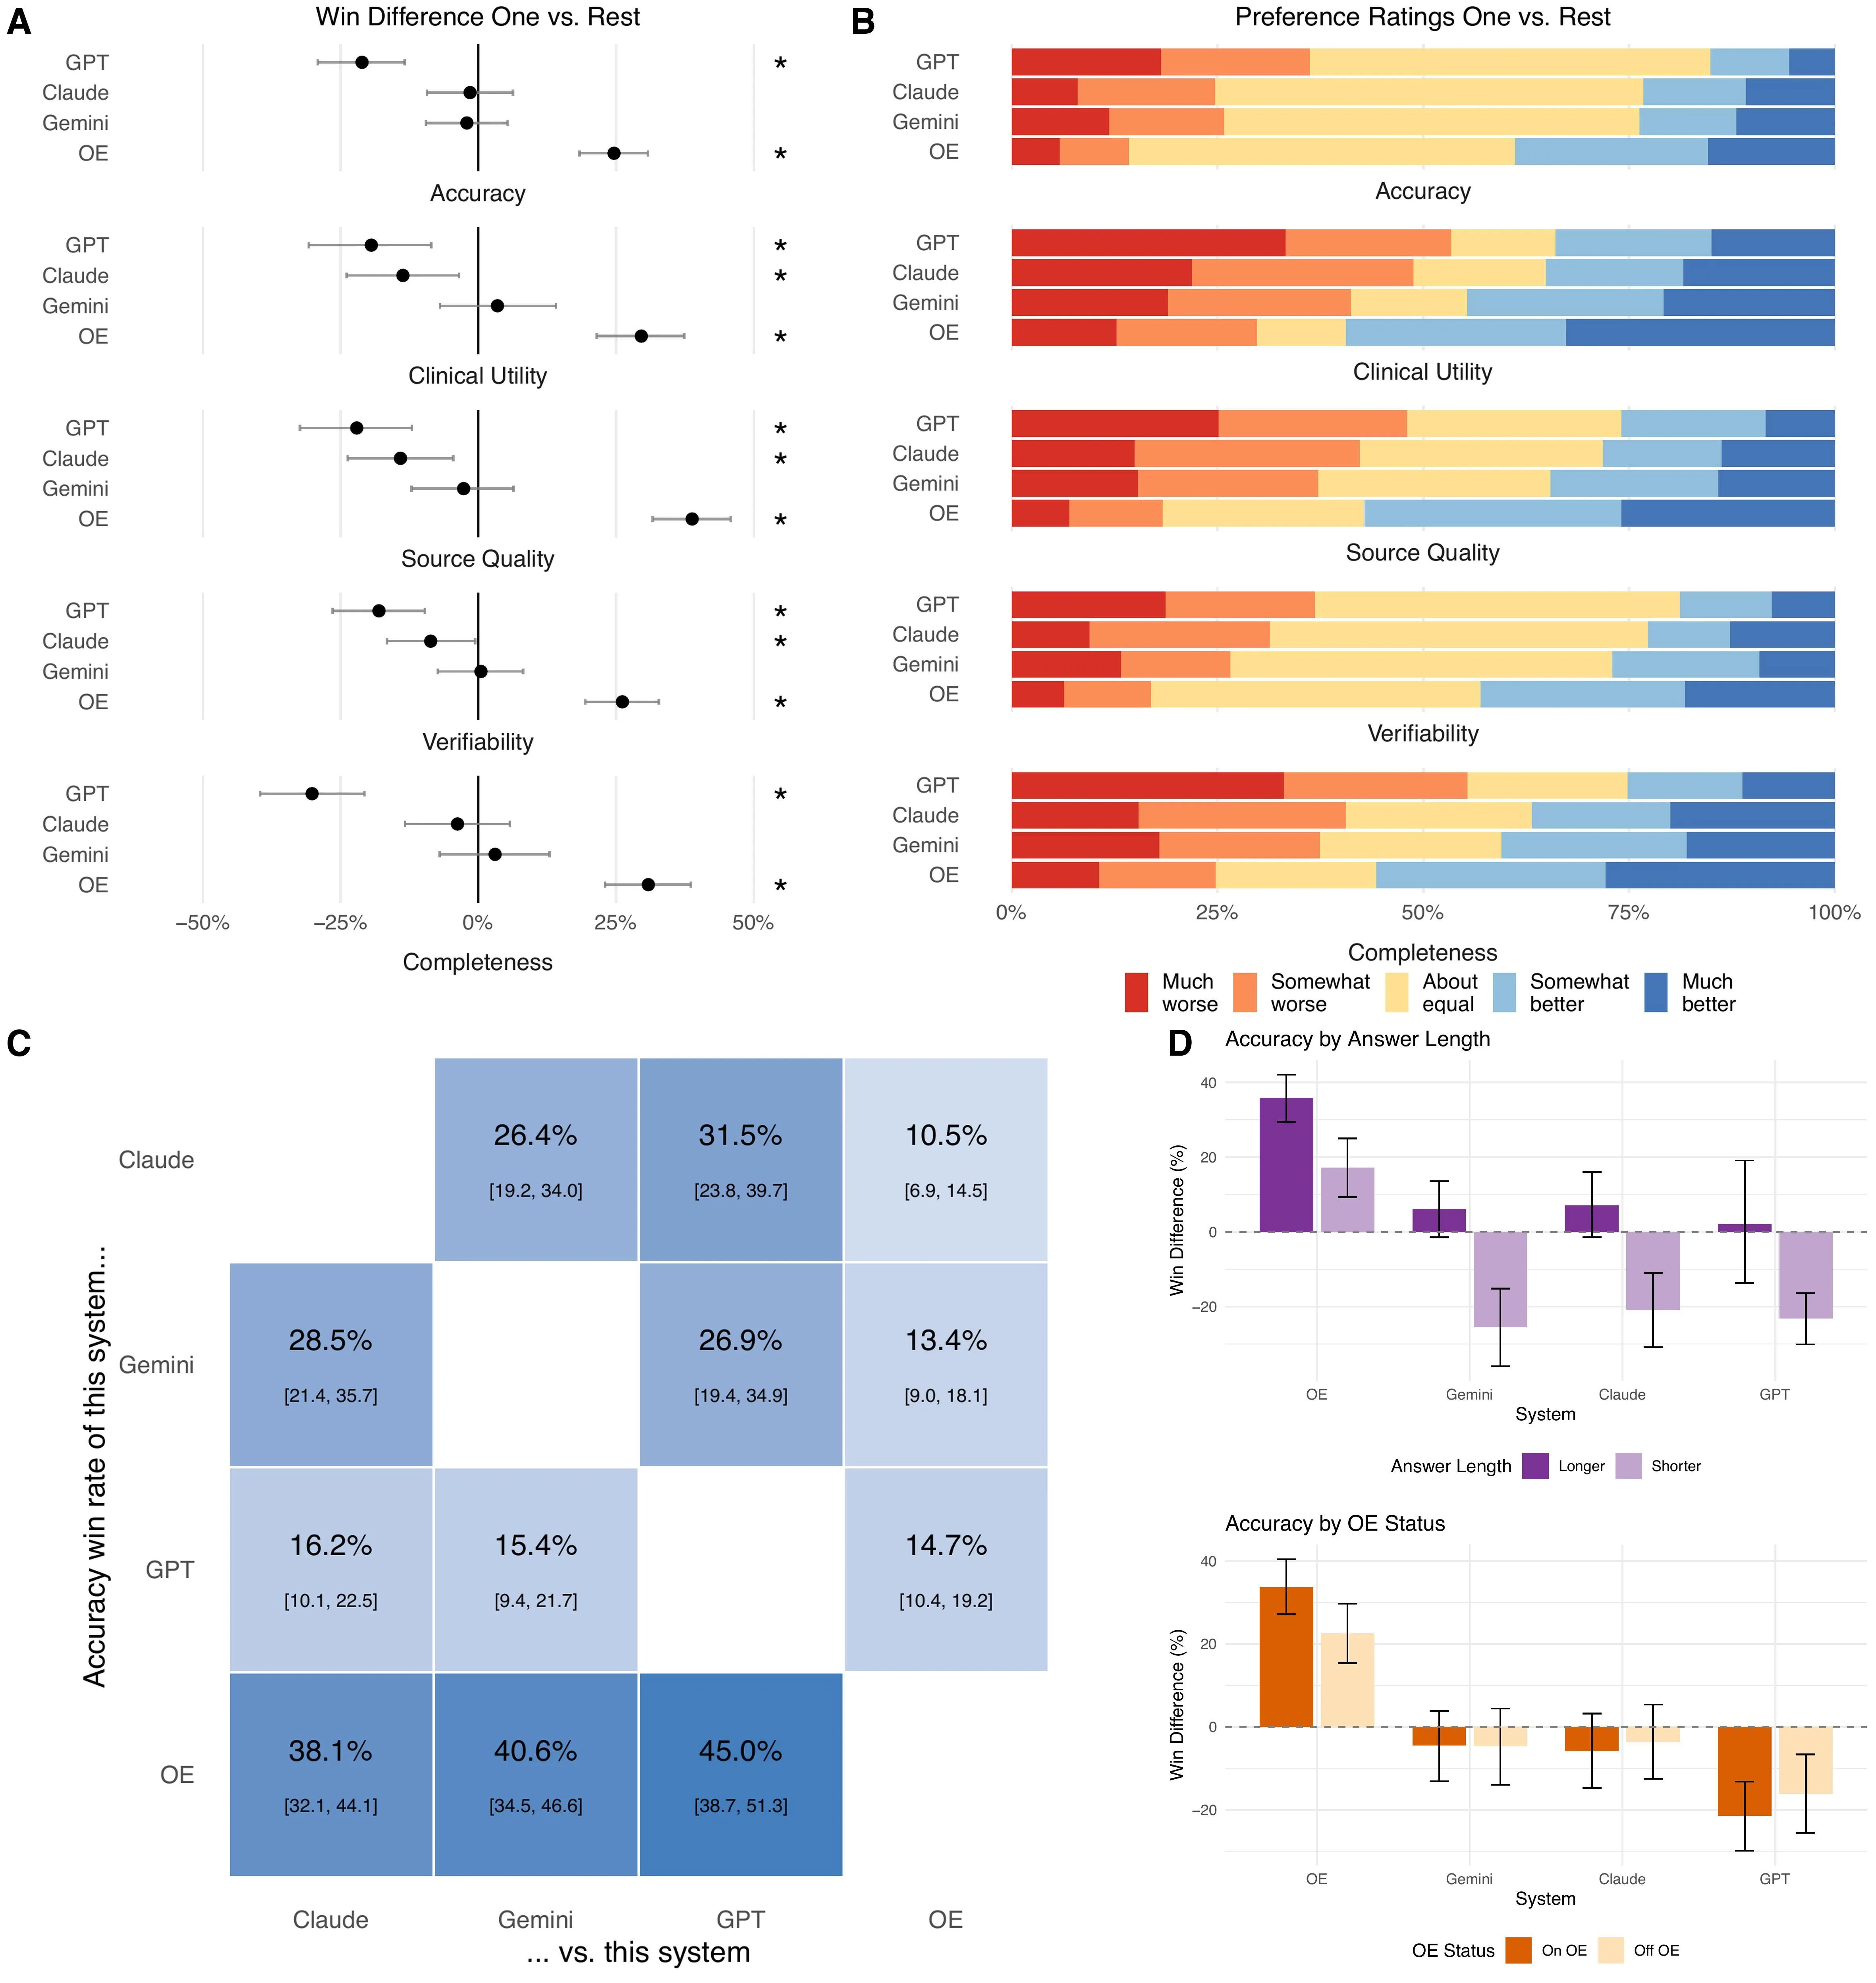
Chaque semaine, les médecins posent des millions de questions aux assistants IA au chevet des patients. Mais ces outils sont généralement testés sur des exercices d'examen, pas sur ce qui est demandé dans une vraie clinique. Un groupe de chercheurs a décidé d'y remédier.
Ils ont rassemblé 620 vraies questions posées par des médecins de 30 spécialités — de la cardiologie à l'oncologie. Ces questions ont été posées sur la plateforme OpenEvidence. Ensuite, 149 médecins en exercice, répartis dans 36 États, ont comparé les réponses de trois modèles généralistes phares (Claude Opus 4.8, Gemini 3.1 Pro, GPT-5.5) et d'un outil médical spécialisé (OE). Chaque juge appartenait à la même spécialité que le médecin qui avait posé la question.
L'évaluation portait sur cinq axes : précision, utilité clinique, qualité des sources, vérifiabilité et exhaustivité. L'outil spécialisé a gagné sur tous les points. L'écart entre victoires et défaites variait de 25 à 39 points de pourcentage — avec une significativité statistique énorme (p<0.001). Le résultat ne dépendait pas du fait que les citations soient affichées, de la longueur de la réponse, ni du fait que le juge ait déjà utilisé cet outil auparavant.
Il y a deux conclusions. Premièrement, il faut tester l'IA médicale sur de vraies questions et avec des médecins de la même spécialité — sinon le tableau est incomplet. Deuxièmement, l'avantage de l'outil spécialisé ne signifie pas que les modèles généralistes sont inutiles. Cela montre qu'un réglage d'ingénierie ciblé apporte un gain tangible pour l'utilisateur. Comme un stéthoscope bien réglé entend ce qu'un microphone universel manque.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2606.28960
Physicians now pose millions of clinical questions to AI tools each week, yet these tools are evaluated largely on hypothetical or exam-style questions, not those actually asked in practice. We report a blinded evaluation built on 620 Real-world Point-Of-Care Queries (Real-POCQi) submitted to the OpenEvidence (OE) platform by physicians spanning 30 specialties, as well as 187 questions from HealthBench. 149 practicing physicians across 36 states made head-to-head comparisons between answers from three frontier general-purpose models (Claude Opus 4.8, Gemini 3.1 Pro, and GPT-5.5) and a specialized clinical tool (OE), with graders matched to each question's specialty. When comparing answers along five dimensions relevant to clinical decision support -- accuracy, clinical utility, source quality, verifiability, & completeness -- physicians scored the specialized tool highest on all axes; in the primary analysis on Real-POCQi, win differences (margins between win and loss rates) ranged from 25 to 39 percentage points (p<0.001). Results remained consistent in sensitivity analyses stratifying by citation display, answer length, OE-user status, and Real-POCQi versus HealthBench. In parallel, LLM judges were found to systematically differ from expert judges, though both generally agreed on the best model. These findings underscore two conclusions: (i) AI tool evaluations should reflect real-world query distributions and use expert judges that mirror the specialization defining modern medicine and (ii) the consistent advantage of the specialized tool over general-purpose models does not necessarily mean that the latter cannot serve similar purposes, but that targeted engineering and customization can yield meaningful gains in performance for its users. We release Real-POCQi as a public benchmark, as well as the prespecified statistical analysis for reproducing results of this study.
L'écart de victoires atteignait 39 points de pourcentage — c'est comme si une équipe gagnait 7 matchs sur 10, et l'autre seulement 3.