Qui soigne le mieux : l'IA généraliste ou le spécialiste ? express
Chaque semaine, les médecins posent des millions de questions aux assistants IA au chevet des patients. Mais ces outils sont généralement testés sur des exercices d'examen, pas sur ce qui est demandé dans une vraie clinique. Un groupe de chercheurs a décidé d'y remédier.
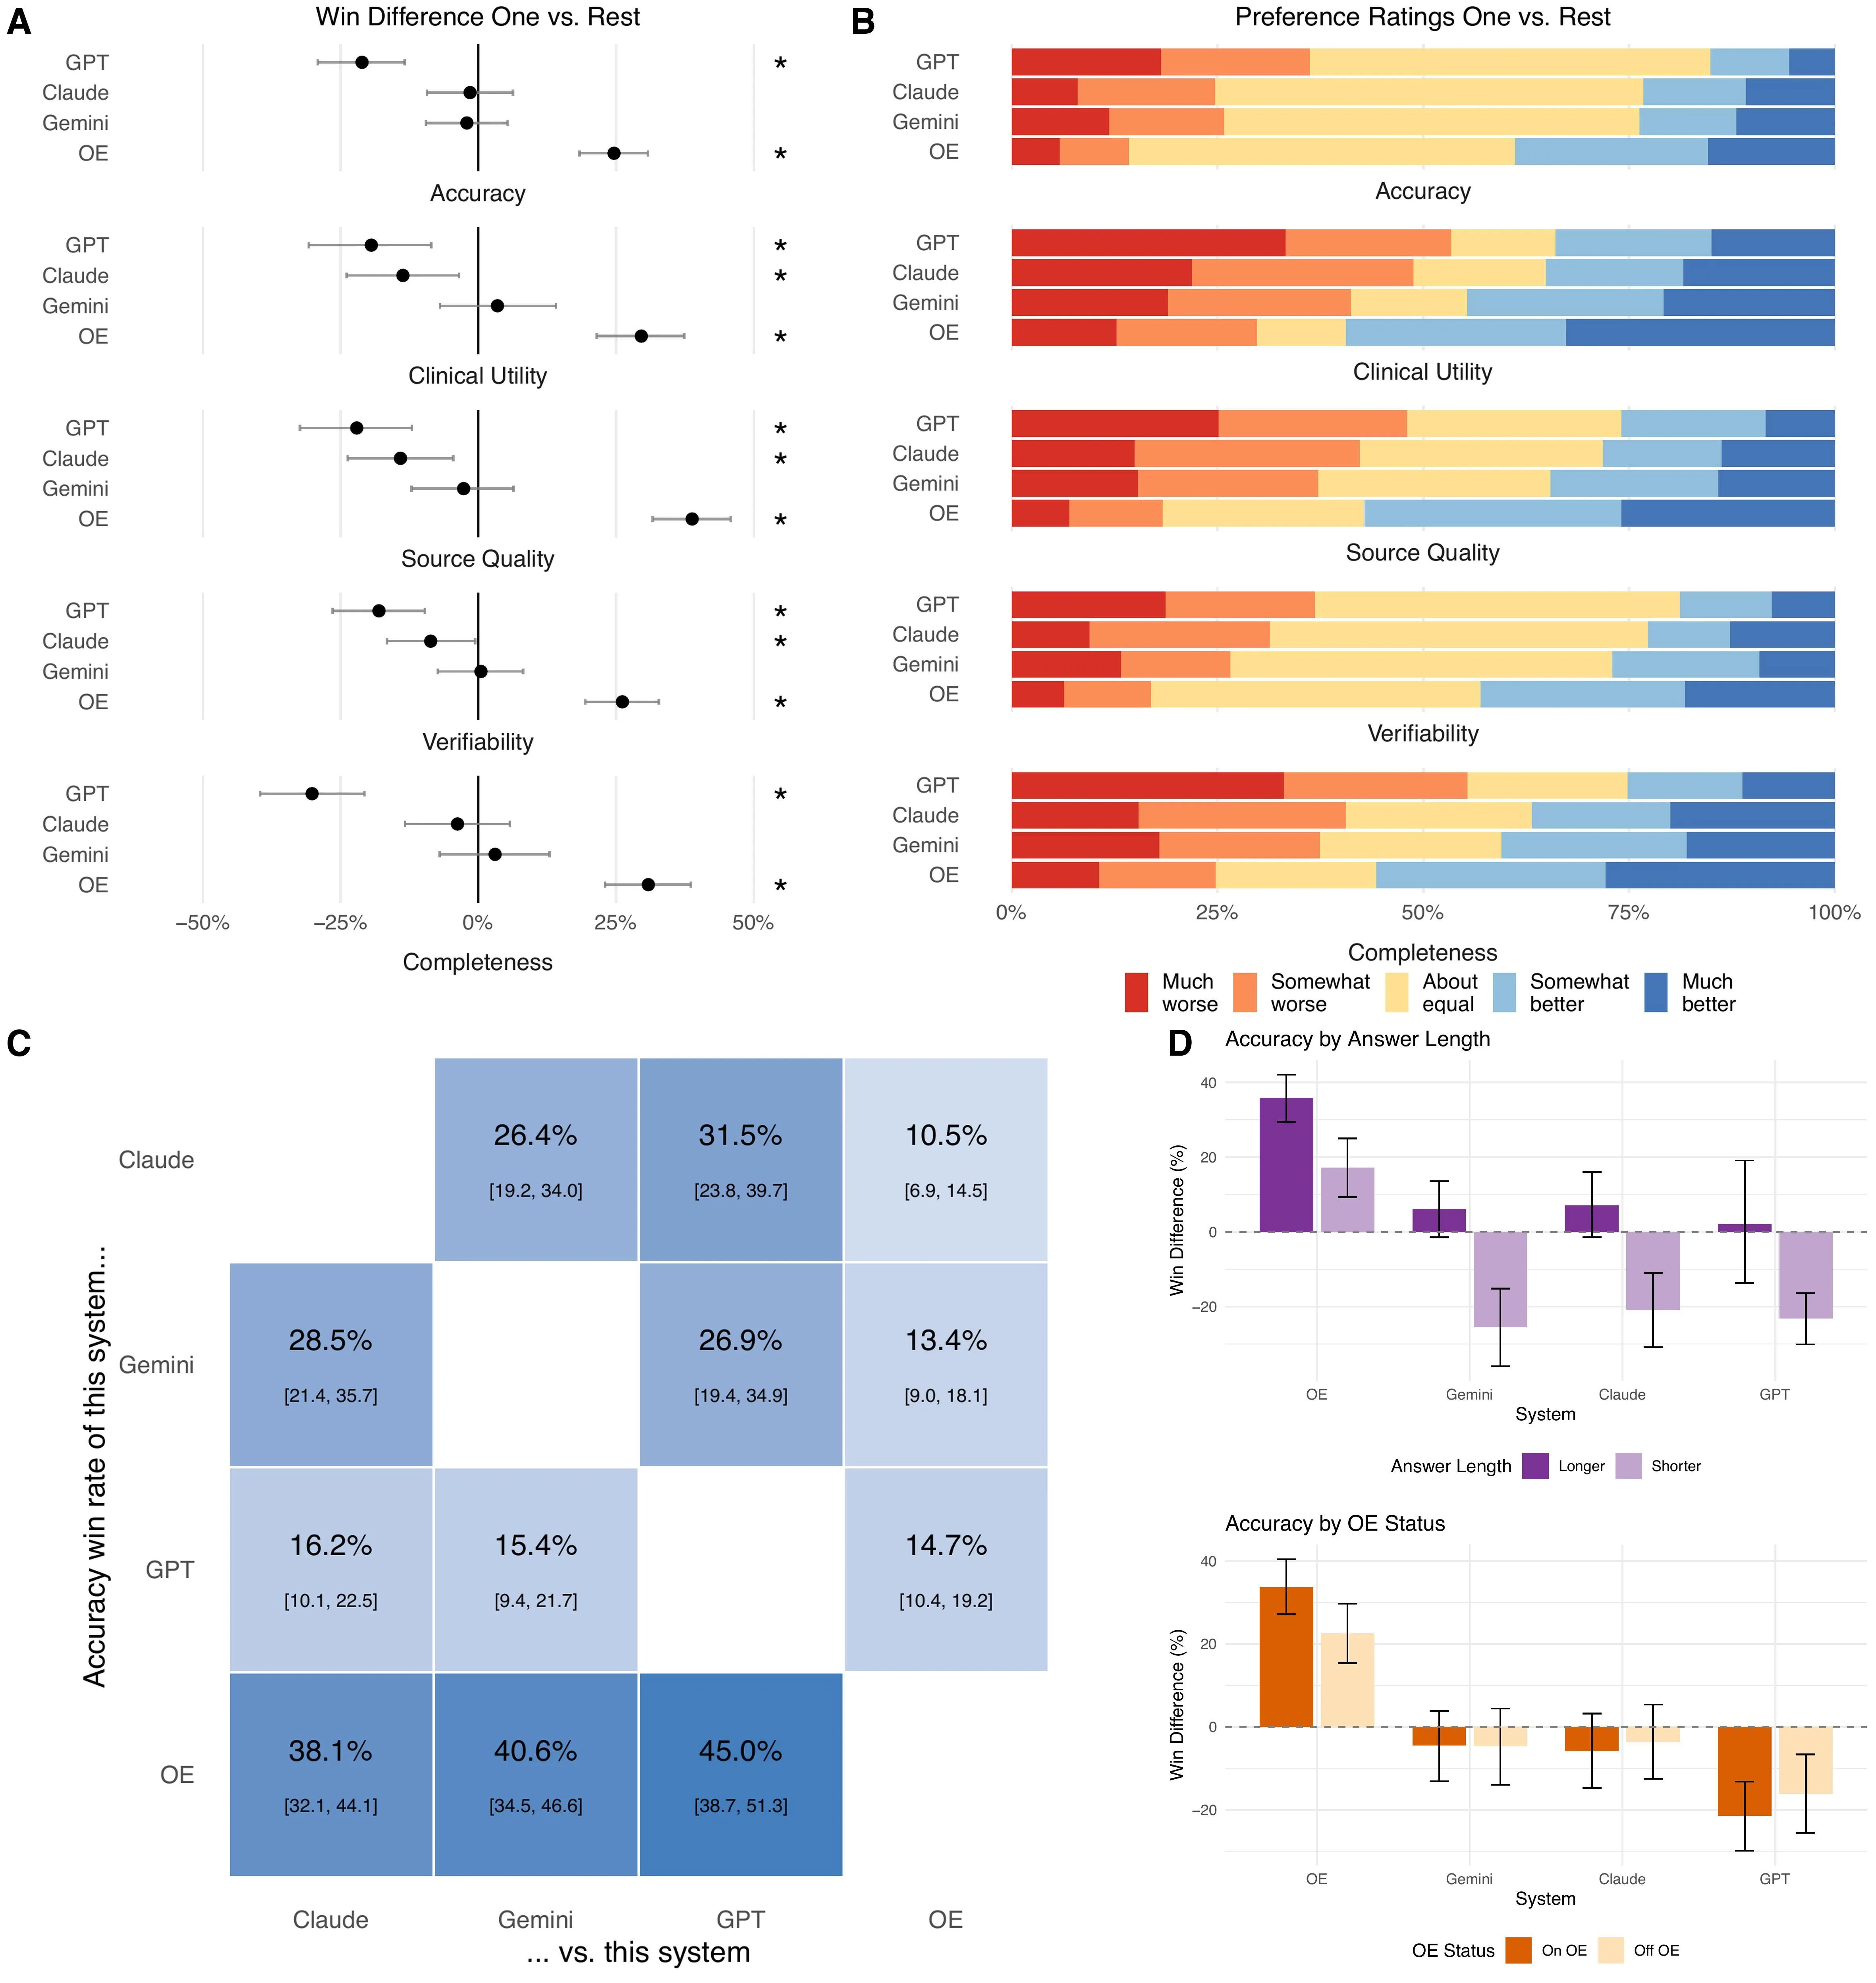
Ils ont rassemblé 620 vraies questions posées par des médecins de 30 spécialités — de la cardiologie à l'oncologie. Ces questions ont été posées sur la plateforme OpenEvidence. Ensuite, 149 médecins en exercice, répartis dans 36 États, ont comparé les réponses de trois modèles généralistes phares (Claude Opus 4.8, Gemini 3.1 Pro, GPT-5.5) et d'un outil médical spécialisé (OE). Chaque juge appartenait à la même spécialité que le médecin qui avait posé la question.
L'évaluation portait sur cinq axes : précision, utilité clinique, qualité des sources, vérifiabilité et exhaustivité. L'outil spécialisé a gagné sur tous les points. L'écart entre victoires et défaites variait de 25 à 39 points de pourcentage — avec une significativité statistique énorme (p<0.001). Le résultat ne dépendait pas du fait que les citations soient affichées, de la longueur de la réponse, ni du fait que le juge ait déjà utilisé cet outil auparavant.
Il y a deux conclusions. Premièrement, il faut tester l'IA médicale sur de vraies questions et avec des médecins de la même spécialité — sinon le tableau est incomplet. Deuxièmement, l'avantage de l'outil spécialisé ne signifie pas que les modèles généralistes sont inutiles. Cela montre qu'un réglage d'ingénierie ciblé apporte un gain tangible pour l'utilisateur. Comme un stéthoscope bien réglé entend ce qu'un microphone universel manque.
L'écart de victoires atteignait 39 points de pourcentage — c'est comme si une équipe gagnait 7 matchs sur 10, et l'autre seulement 3.