Клеточные атласы: кто лучше читает язык ткани экспресс
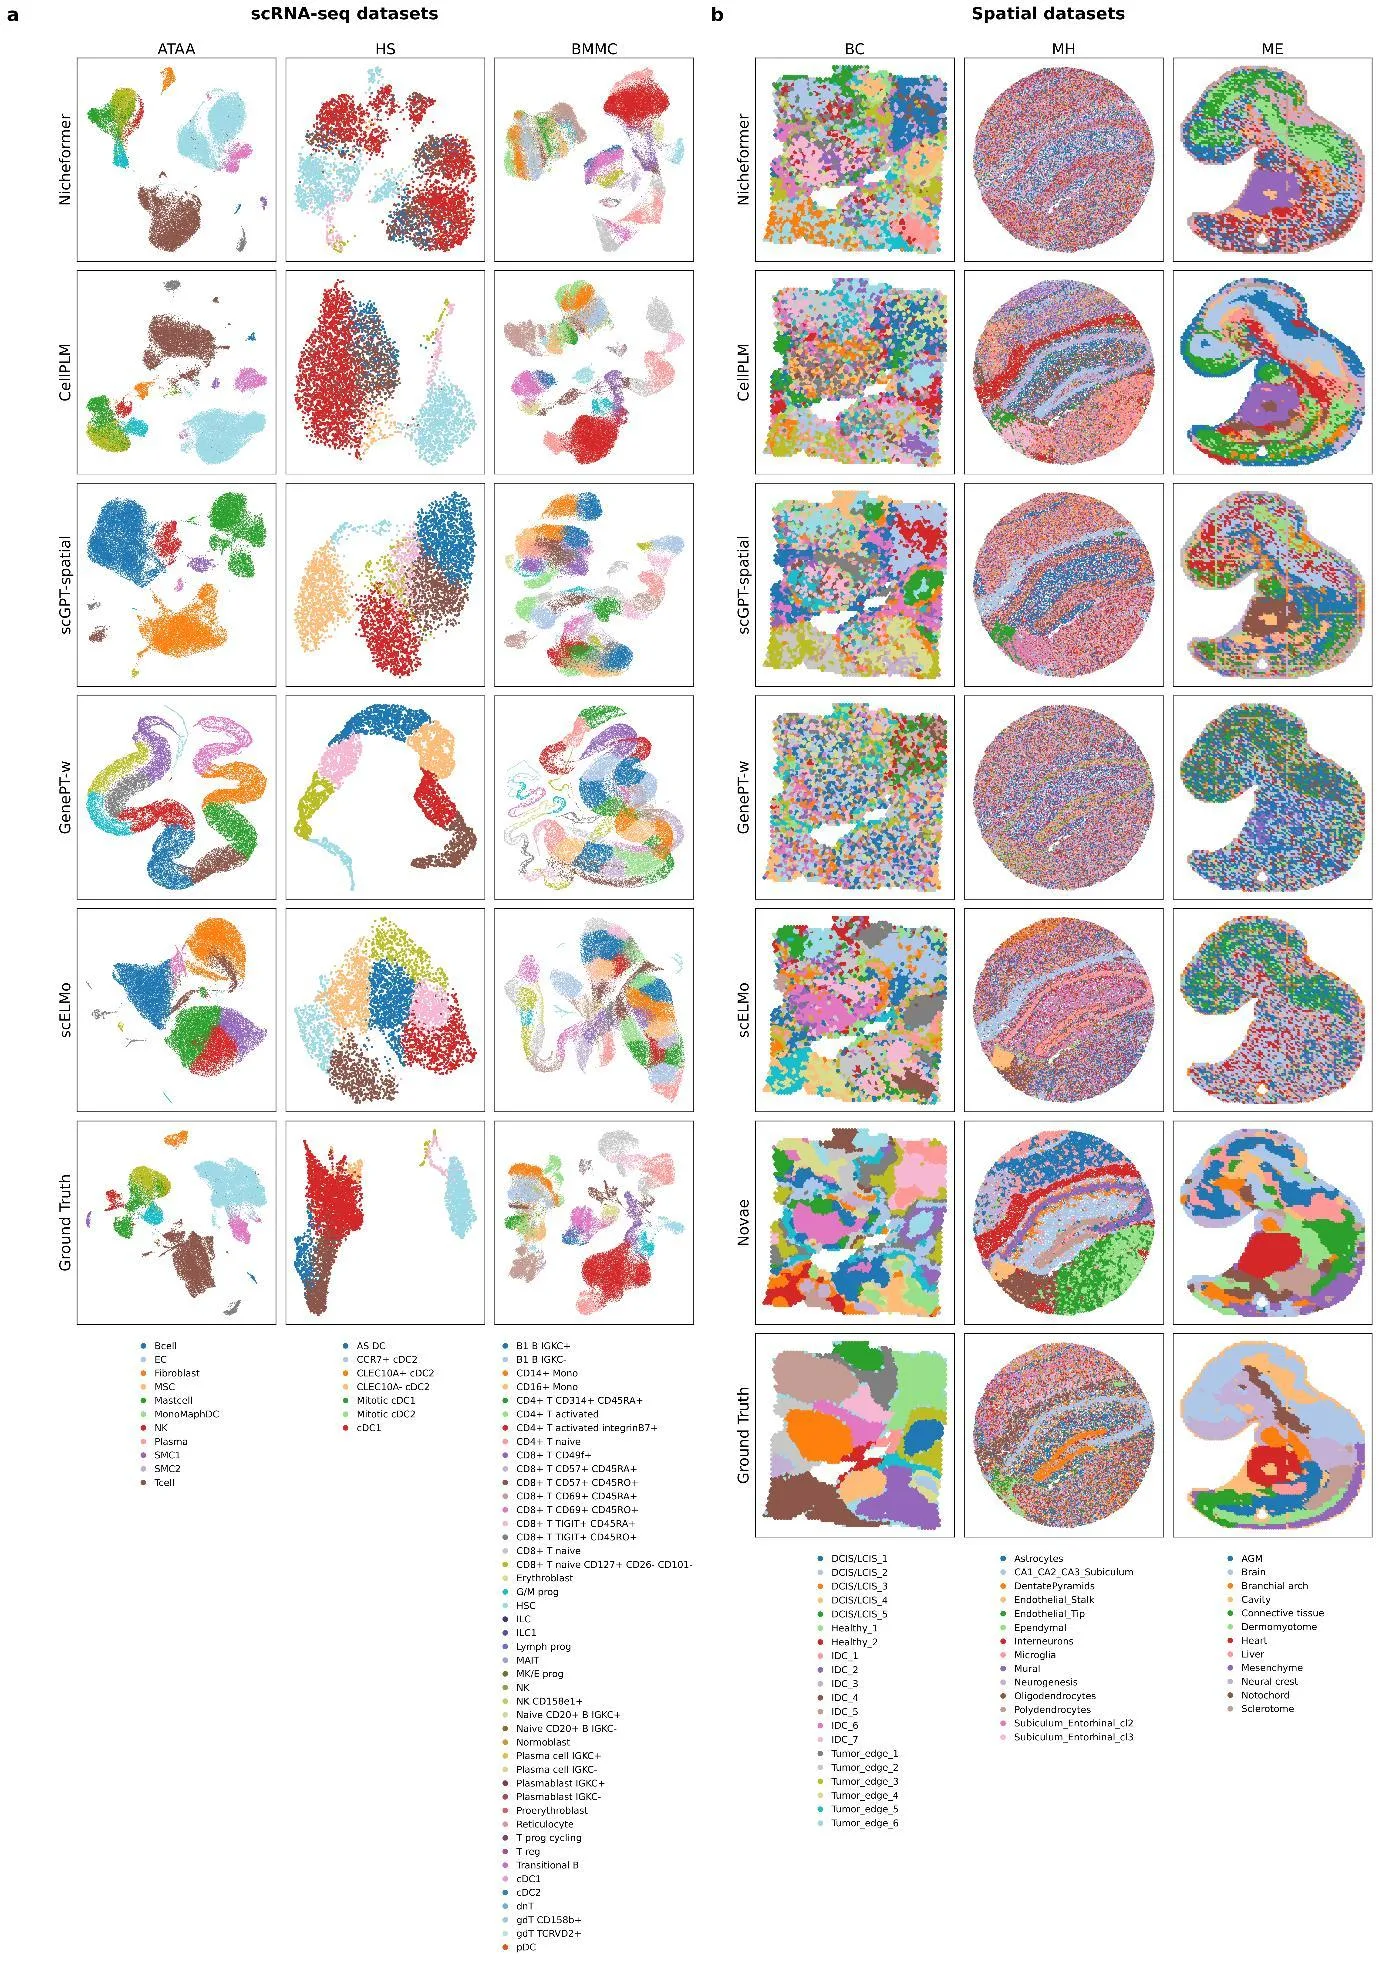
Биологи всё чаще доверяют компьютерам чтение «инструкций по эксплуатации» живой клетки. Шесть свежих моделей искусственного интеллекта — Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo и Novae — как шесть переводчиков с разных диалектов одного и того же клеточного языка. Каждый учился на своих текстах: одни зубрили последовательности активных генов, другие — пространственные карты тканей, третьи вообще начинали с обычного человеческого языка.
Авторы работы устроили им честный экзамен. Моделям давали одни и те же задачи: сгруппировать клетки по типу, найти гены-маркеры (молекулярные «паспорта» клеток) или предсказать, как клетка отреагирует на лекарство. Исходные данные тоже были разными — от обычного перечня работающих генов до снимков, где видно положение каждой клетки в ткани.
Результат оказался отрезвляющим. Модели, обученные на «плоских» списках генов, лучше всего определяли клеточные типы. Пространственные модели, которые видят карту ткани, точнее сохраняли архитектуру органа. А языковые модели, для которых ген — это просто слово в предложении, неожиданно неплохо предсказывали эффект лекарств. Ни одна модель не выиграла во всех номинациях, и расстановка сил менялась от малейших нюансов — способа предобработки данных, выбора метрики или даже того, как именно гены были «нарезаны» на кусочки для анализа.
Это не гонка за абсолютным чемпионом. Скорее, появление целого набора инструментов, где каждый хорош для своего дела. Будущее за теми моделями, которые смогут не просто набирать очки в тестах, а объяснить биологу, почему клетка пошла именно по этому пути развития.
Некоторые модели учились понимать гены, просто «читая» научные статьи. Для них ген — это как слово, а клетка — как абзац.