Трансформеры — это нейросетевые модели, использующие механизмы самовнимания для таких задач, как картирование мозга, языковой перевод и связывание контекста в ИИ-агентах.
Трансформер — архитектура нейросетей, где вся последовательность обрабатывается параллельно. Слово «банк» (в смысле финансового учреждения или скамейки) уточняет значение через связи с другими словами в предложении, используя механизм внимания (динамический вес важности). Это позволило преодолеть ограничения старых моделей, которые путались в длинных фразах. Так оперативный штаб распределяет задачи: каждый агент видит общую картину и выделяет приоритетные цели.
История
Предложена в статье «Attention is All You Need» (2017) Васивани и коллег из Google. Основная идея механизма внимания восходит к работам 1990-х годов, но именно трансформер утвердил его как самодостаточный строительный блок. Сначала завоевал машинный перевод, а затем — генеративные модели (GPT, BERT), компьютерное зрение и даже предсказание структуры белков.
Как это работает
Ключевой элемент — самовнимание: для входной последовательности вычисляются матрицы запросов (Q), ключей (K) и значений (V). Веса внимания получаются как масштабированное скалярное произведение запросов и ключей, после softmax. Формула: Attention(Q,K,V) = softmax(QK^T/√d_k)V, где d_k — размерность ключей. Энкодер применяет многоголовое внимание: несколько параллельных голов проецируют вход в разные подпространства, затем результаты объединяются. Позиционное кодирование добавляет информацию о порядке слов, так как модель не имеет встроенного представления последовательности.
Где применяется
Машинный перевод, голосовые помощники и системы, понимающие длинные тексты, — от чат-ботов до автоматических отчётов.
Любопытный факт
Современные трансформеры (вроде GPT) могут содержать сотни миллиардов настраиваемых параметров — примерно как число звёзд в небольшой галактике.
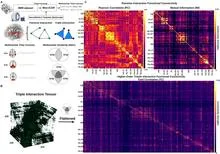
Джазовое трио играет в полумраке клуба. Пианист ведёт мелодию, контрабасист держит ритм, барабанщик рассыпает дробь. Если слушать только пары музыкантов, можно уловить, как пианист подстраивается под бас или бас под барабаны. Но главное рождается, когда все трое импровизируют одновременно: одна фраза пианиста меняет игру барабанщика, а та, в свою очередь, подталкивает контрабасиста к новому ходу.
Штурман с бумажной картой прокладывает маршрут до выхода в море. Если океан изменится — течение сдвинется, ветер усилится, — карта останется прежней. Судно пойдёт по устаревшему пути, и экипажу придётся вручную корректировать курс.
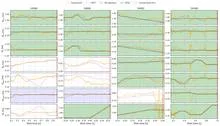
В антарктическом льду частица-призрак оставляет после себя лишь слабую вспышку синего света. Детектор IceCube ловит эти вспышки, и по ним нужно понять, откуда прилетела частица. Модель PolarBERT научилась это делать, но что именно она видит внутри — оставалось загадкой.
Удержать в голове точное положение ручки, пока её медленно двигают, — для мозга рядовая задача. Для искусственных нейросетей она почти невыполнима. Обычные рекуррентные сети, такие как GRU (Gated Recurrent Unit) и LSTM (Long Short-Term Memory), склонны разбивать непрерывное движение на жёсткие ступеньки: ручка не ползёт плавно, а перескакивает из точки в точку.
Человеческий разум похож на конструктор, который сам себя достраивает. Новые идеи не умирают вместе с человеком — они передаются, смешиваются и отбираются. Этот процесс называют культурной эволюцией: полезные изобретения закрепляются, а бесполезные забываются. Так работает храповик — механизм, который крутится только вперёд.
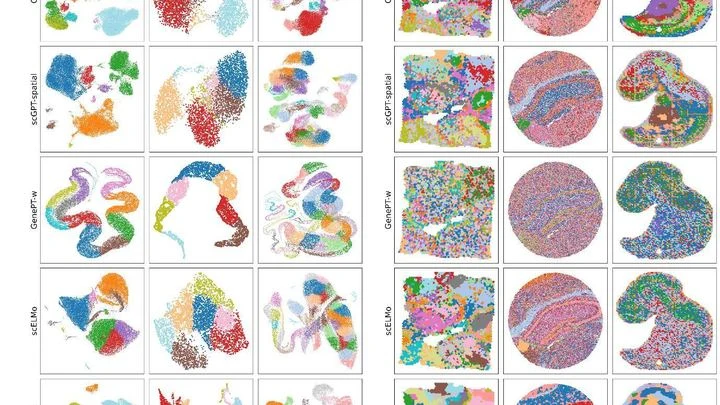
Биологи всё чаще доверяют компьютерам чтение «инструкций по эксплуатации» живой клетки. Шесть свежих моделей искусственного интеллекта — Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo и Novae — как шесть переводчиков с разных диалектов одного и того же клеточного языка.
Камеры беспилотного автомобиля улавливают свет, словно телескопы, направленные на далёкую галактику. Каждый кадр — отрывочное наблюдение; вместе они должны сложиться в карту пути.
Компьютер, подобно астроному, не склеивает снимки, а генерирует несколько возможных видов сверху и сравнивает их с реальными данными.
Мозг в медитации можно представить как оркестр, где внимание — дирижёр. Когда вы сосредоточены на дыхании, все «инструменты» играют слаженно. Но вот мысль-виолончель берёт фальшивую ноту — это естественное блуждание ума. Опытный дирижёр не паникует: он мгновенно улавливает диссонанс и мягко возвращает оркестр к главной мелодии — дыханию.
Учёные построили компьютерную модель этого процесса.
Связь со спутником напоминает попытку расслышать шёпот в бурю: полезный сигнал тонет в хаосе помех. Инженеры разработали алгоритм на основе искусственного интеллекта, который функционирует непосредственно на борту спутника и при минимальном энергопотреблении распознаёт искажения точнее традиционных методов.
Классическая система слежения напоминает штурмана, прокладывающего курс по звёздам. Но стоит облакам закрыть небо — координаты начинают дрейфовать, а в данных нарастает энтропия — мера неопределённости. Новый алгоритм получает «второго пилота» — модуль, который непрерывно оценивает, насколько уверен основной навигатор в своих расчётах.
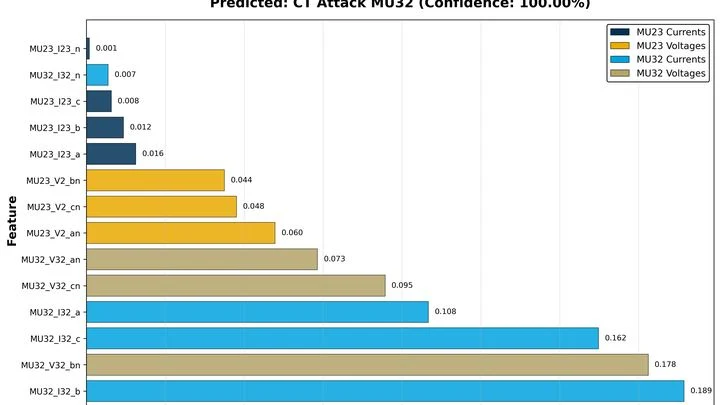
Солнечные панели и ветрогенераторы, в отличие от классических турбин, подключаются через инверторы — устройства, преобразующие постоянный ток в переменный. Это открывает новые векторы для кибератак: злоумышленники могут незаметно искажать показания датчиков или подделывать GPS-метки синхронизации. Для противодействия инженеры объединили два подхода — сверхбыстрого сторожа и вдумчивого детектива.
В спокойной воде маршрут ясен: достаточно держать курс на цель. Но в бурных, хаотичных потоках, где направление и сила течения постоянно меняются, роботу нужна принципиально иная стратегия. Обычные инженерные подходы предполагают построение точной карты течений, однако в реальности получить такую карту практически невозможно — турбулентная среда слишком сложна и изменчива.
Современный стандартный подход к обучению искусственного интеллекта можно сравнить с ребёнком, запертым в библиотеке: он запоминает миллионы книг, но не знает, что огонь обжигает, а падение приносит боль.
В сердце каждой нейтронной звезды скрыта симфония — сложное переплетение квантовых полей и релятивистской гравитации. Почти век назад Фриц Цвикки описал эти объекты как «звёзды-атомы», а Джоселин Белл Бернелл подарила нам их голос — строгий ритм пульсаров.
После брошенного камня круги на воде исчезают, но жидкость хранит микроскопические колебания. Малейший порыв — и рябь возникает снова. Сети нейронов ведут себя похоже. Когда электрические сигналы затихают, память о них остаётся в точках контакта — синапсах, где передача импульсов меняет силу связей. Как вода после шторма, эти следы таят скрытую энергию.
В кастрюле с супом достаточно двух термометров, чтобы понять температуру везде — если знать, что тепло идёт кругами от дна. Так и в науке: по редким замерам нужно восстановить полную картину теплового поля.
Модели, превращающие текст в аудио, хорошо воссоздают одиночные звуки, но путаются, когда в сценарии их несколько. Например, по сценарию сначала звонок, потом шаги, потом хлопок двери. Генератор может переставить события, и зритель услышит шаги до звонка.
Исследователи нашли неожиданное решение: вместо программирования сложных правил они взяли нейросеть, которая «понимает» аудио, и сделали её строгим контролёром.
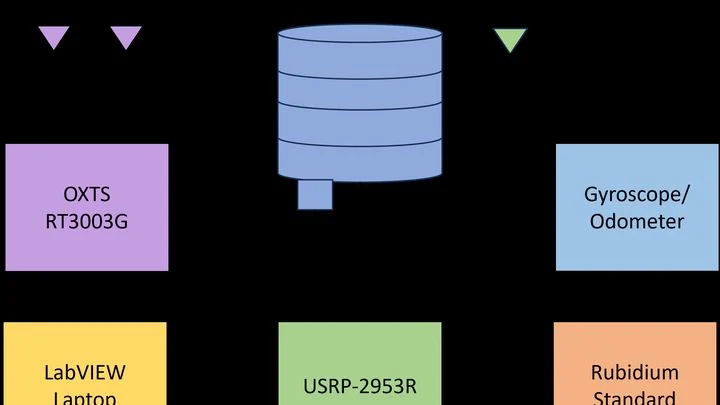
В городской среде радиосигнал от базовой станции распространяется не по прямой, а многократно отражается от зданий — словно мячик, скачущий между стенами. Телефон принимает не один сигнал, а десятки его «отражений», каждое из которых приходит с небольшой задержкой.
Представьте кухню с газовыми конфорками: каждая греет по-своему, и если повар переставит кастрюли, еда может подгореть. Так и в беспроводной сети: антенны-конфорки и пользователи-кастрюли требуют точной расстановки. Обычные нейросети не различают позиции, считая все конфорки одинаковыми, поэтому им трудно оценить качество связи или настроить передачу.
Поплавок в бачке унитаза — идеальный контроллер: чувствуя уровень воды, он мгновенно приводит систему в равновесие без оглядки на прошлое. Инженеры применили этот принцип к нейросетям. Они переписали стандартную архитектуру так, что вместо каскада вычислений она решает одно уравнение равновесия.
Семейное древо превращается в клубок, если учесть приёмных детей и повторные браки. Эволюция часто похожа на такой клубок: хотя стандартная модель — традиционное представление о дивергентной эволюции, где виды ветвятся подобно дереву — рисует аккуратное древо видов, на деле гены кочуют не только по наследству, но и напрямую между неродственными организмами — этот…
Электронный микроскоп — гигантский орган: вместо труб — электромагнитные линзы, вместо воздуха — поток ускоренных электронов. Раньше он лишь рисовал немые фрески атомного мира, обрекая учёных на изнурительную расшифровку.
Квантовый мир многих тел — это джазовый ансамбль, где каждый электрон импровизирует, непрерывно прислушиваясь ко всем остальным, и общая волновая функция рождается из этого напряжённого диалога.
Выделить сигнал от одной пары сверхмассивных чёрных дыр — всё равно что расслышать шаги танцора в грохоте урагана. Где-то в космосе эти монстры кружатся в медленном гравитационном танго, искажая само пространство-время. Их гравитационные волны — не резкие всплески, как у LIGO, а глубинное дыхание метрики, растянутое на годы.
Рекомендательные системы, определяющие, какой пост вы увидите следующим, работают на глубоких нейросетях из тысяч операций — сложных графов вычислений (схемах из операций над данными). Эти системы — живые, постоянно эволюционирующие динамические системы: малейшее изменение архитектуры распространяется каскадом по всему графу.
В квантовой физике есть теории, где всё подчиняется чётким пропорциям — как музыкальный ритм, который всегда возвращается к началу такта. Но существуют и «иррациональные» теории, где ритм ломается и предсказать следующий удар почти невозможно. Одна из таких — теория компактифицированного бозона: частица живёт на окружности, и её поведение зависит от радиуса этой окружности.
В зале суда — строка, поданная на вход. Двенадцать присяжных (вычислительных путей) изучают её символ за символом. Каждый может вынести «виновен» (принять) или «невиновен». Для обычного недетерминированного автомата (НКА) достаточно одного голоса «за». Но в суде с симметрической разностью (XNFA) вердикт выносится по нечётности: если число голосов «виновен» нечётно — слово принято.
Крошечная пылинка в перенасыщенном растворе за секунды обрастает гранями крупного кристалла. Соседние частицы остаются невидимками. Похожий процесс недавно обнаружили в сообществах языковых агентов.
Глубины космоса не молчат — они полны зашифрованных посланий. Каждая звезда, каждый квазар посылает свой дрожащий световой код: ритмичный, как морзянка цефеиды, или хаотичный, словно взломанный шифр сверхновой. Астрономы перехватывают эти сигналы миллионами каждую ночь — но как прочесть их без ключа?
В час пик на кухне ресторана шипит масло, стучат ножи, летят заказы. Шеф-повар не может ждать, пока помоют сковороду — у него под рукой всегда есть помощник, который заранее готовит чистую. Так же работают современные LLM-агенты: они управляют кодом, планируют задачи, общаются с пользователем, порождая длинные цепочки сообщений.
Эти цепочки быстро перегружают модель.
Золото не лежит на поверхности — оно спрятано в тоннах пустой породы. Чтобы добыть грамм драгоценного металла, старатели просеивают кубометры грунта. Примерно так же обучаются современные большие языковые модели: тысячи ответов-кандидатов прогоняются через дорогую модель-оценщик (оракул — модель, дающая точные оценки), чтобы выбрать один — лучший.
Мозг не учит каждую задачу с нуля — он переносит опыт с одного дела на другое. Но как узнать, какие задачи действительно родственны? Нейробиологи придумали остроумный ход: дать искусственной сети «подсмотреть» активность мозга во время одной задачи и попробовать предсказать активность во время другой. Если получается хорошо — значит, задачи близки.
Нейрон похож на электрическую цепь с батарейками и переменными резисторами. Роль резисторов играют ионные каналы — белковые поры в мембране, которые открываются и закрываются, пропуская заряженные частицы. От того, как быстро и при каком напряжении срабатывают эти поры, зависит, родится ли нервный импульс.
Инженер настраивает антенну: тянет один сегмент — частота уходит, меняет угол — падает усиление. Примерно так же устроена разработка лечебных пептидов (коротких белковых цепочек).
Нейронная сеть, словно лист бумаги в клетку, получает на вход однородные сигналы — и сама расчерчивает на себе координатную сетку. Сначала связи между входами и клетками сети становятся похожи на пологий холм: в центре отклик сильнее, а к краям затухает. Так рождается устойчивое пятно активности — коллективный узор, который держится сам.
Вы рассказываете другу историю, а его мозг словно настраивается на вашу волну — одни и те же участки активируются в такт вашим словам. Учёные записали такую «нейронную синхронизацию» с помощью магнитоэнцефалографии (прибора, улавливающего магнитные поля мозга) и решили проверить, может ли компьютерная языковая модель повторить этот танец смыслов.
Переводчик сидит в зале совещаний и переводит каждое слово. Но вот он замечает, что его перевод можно улучшить, если он будет учиться на своих ошибках. Он начинает записывать, какие фразы вызвали непонимание, и корректирует их. Через час его перевод становится точнее, а совещание проходит быстрее.
Кассир в супермаркете в час пик не запоминает каждую пробитую покупку — он держит в голове общую сумму и следит за очередью. Примерно так же мозг распределяет свои силы: дорогая и точная кора (то, что отвечает за обдумывание) и более простые, экономные подкорковые ядра (где живут привычки) работают в паре.
Человек смотрит на дверной замок и видит щель для ключа. Он знает, что ключ вставляют и поворачивают. Но если вместо скважины — сенсорная панель, привычная рамка ломается. Человек не просто ошибается: он понимает, что привычный способ не годится, и может сказать: «Здесь нет места для ключа, нужен другой подход».
Такая честная остановка с объяснением — редкость для машин.
Город — это живая система: он потребляет ресурсы, выделяет отходы, а его «кровеносная система» — дорожная сеть — доставляет людей и товары к местам назначения. Но пока инженеры проектируют транспортные артерии как жёсткую геометрию прямых линий, природа миллионы лет оттачивает идеальные распределительные сети.