Электронный поводырь для искусственного зрения экспресс
Глазной протез передаёт в мозг не фотографию, а редкий пунктир из светлых точек — фосфенов. Чтобы разглядеть в этой ряби чашку или ключи, человек вынужден водить головой, как фонариком в темноте, и по крупицам собирать очертания предмета. Это медленный процесс, похожий на сбор пазла, где большинство деталей выброшено.
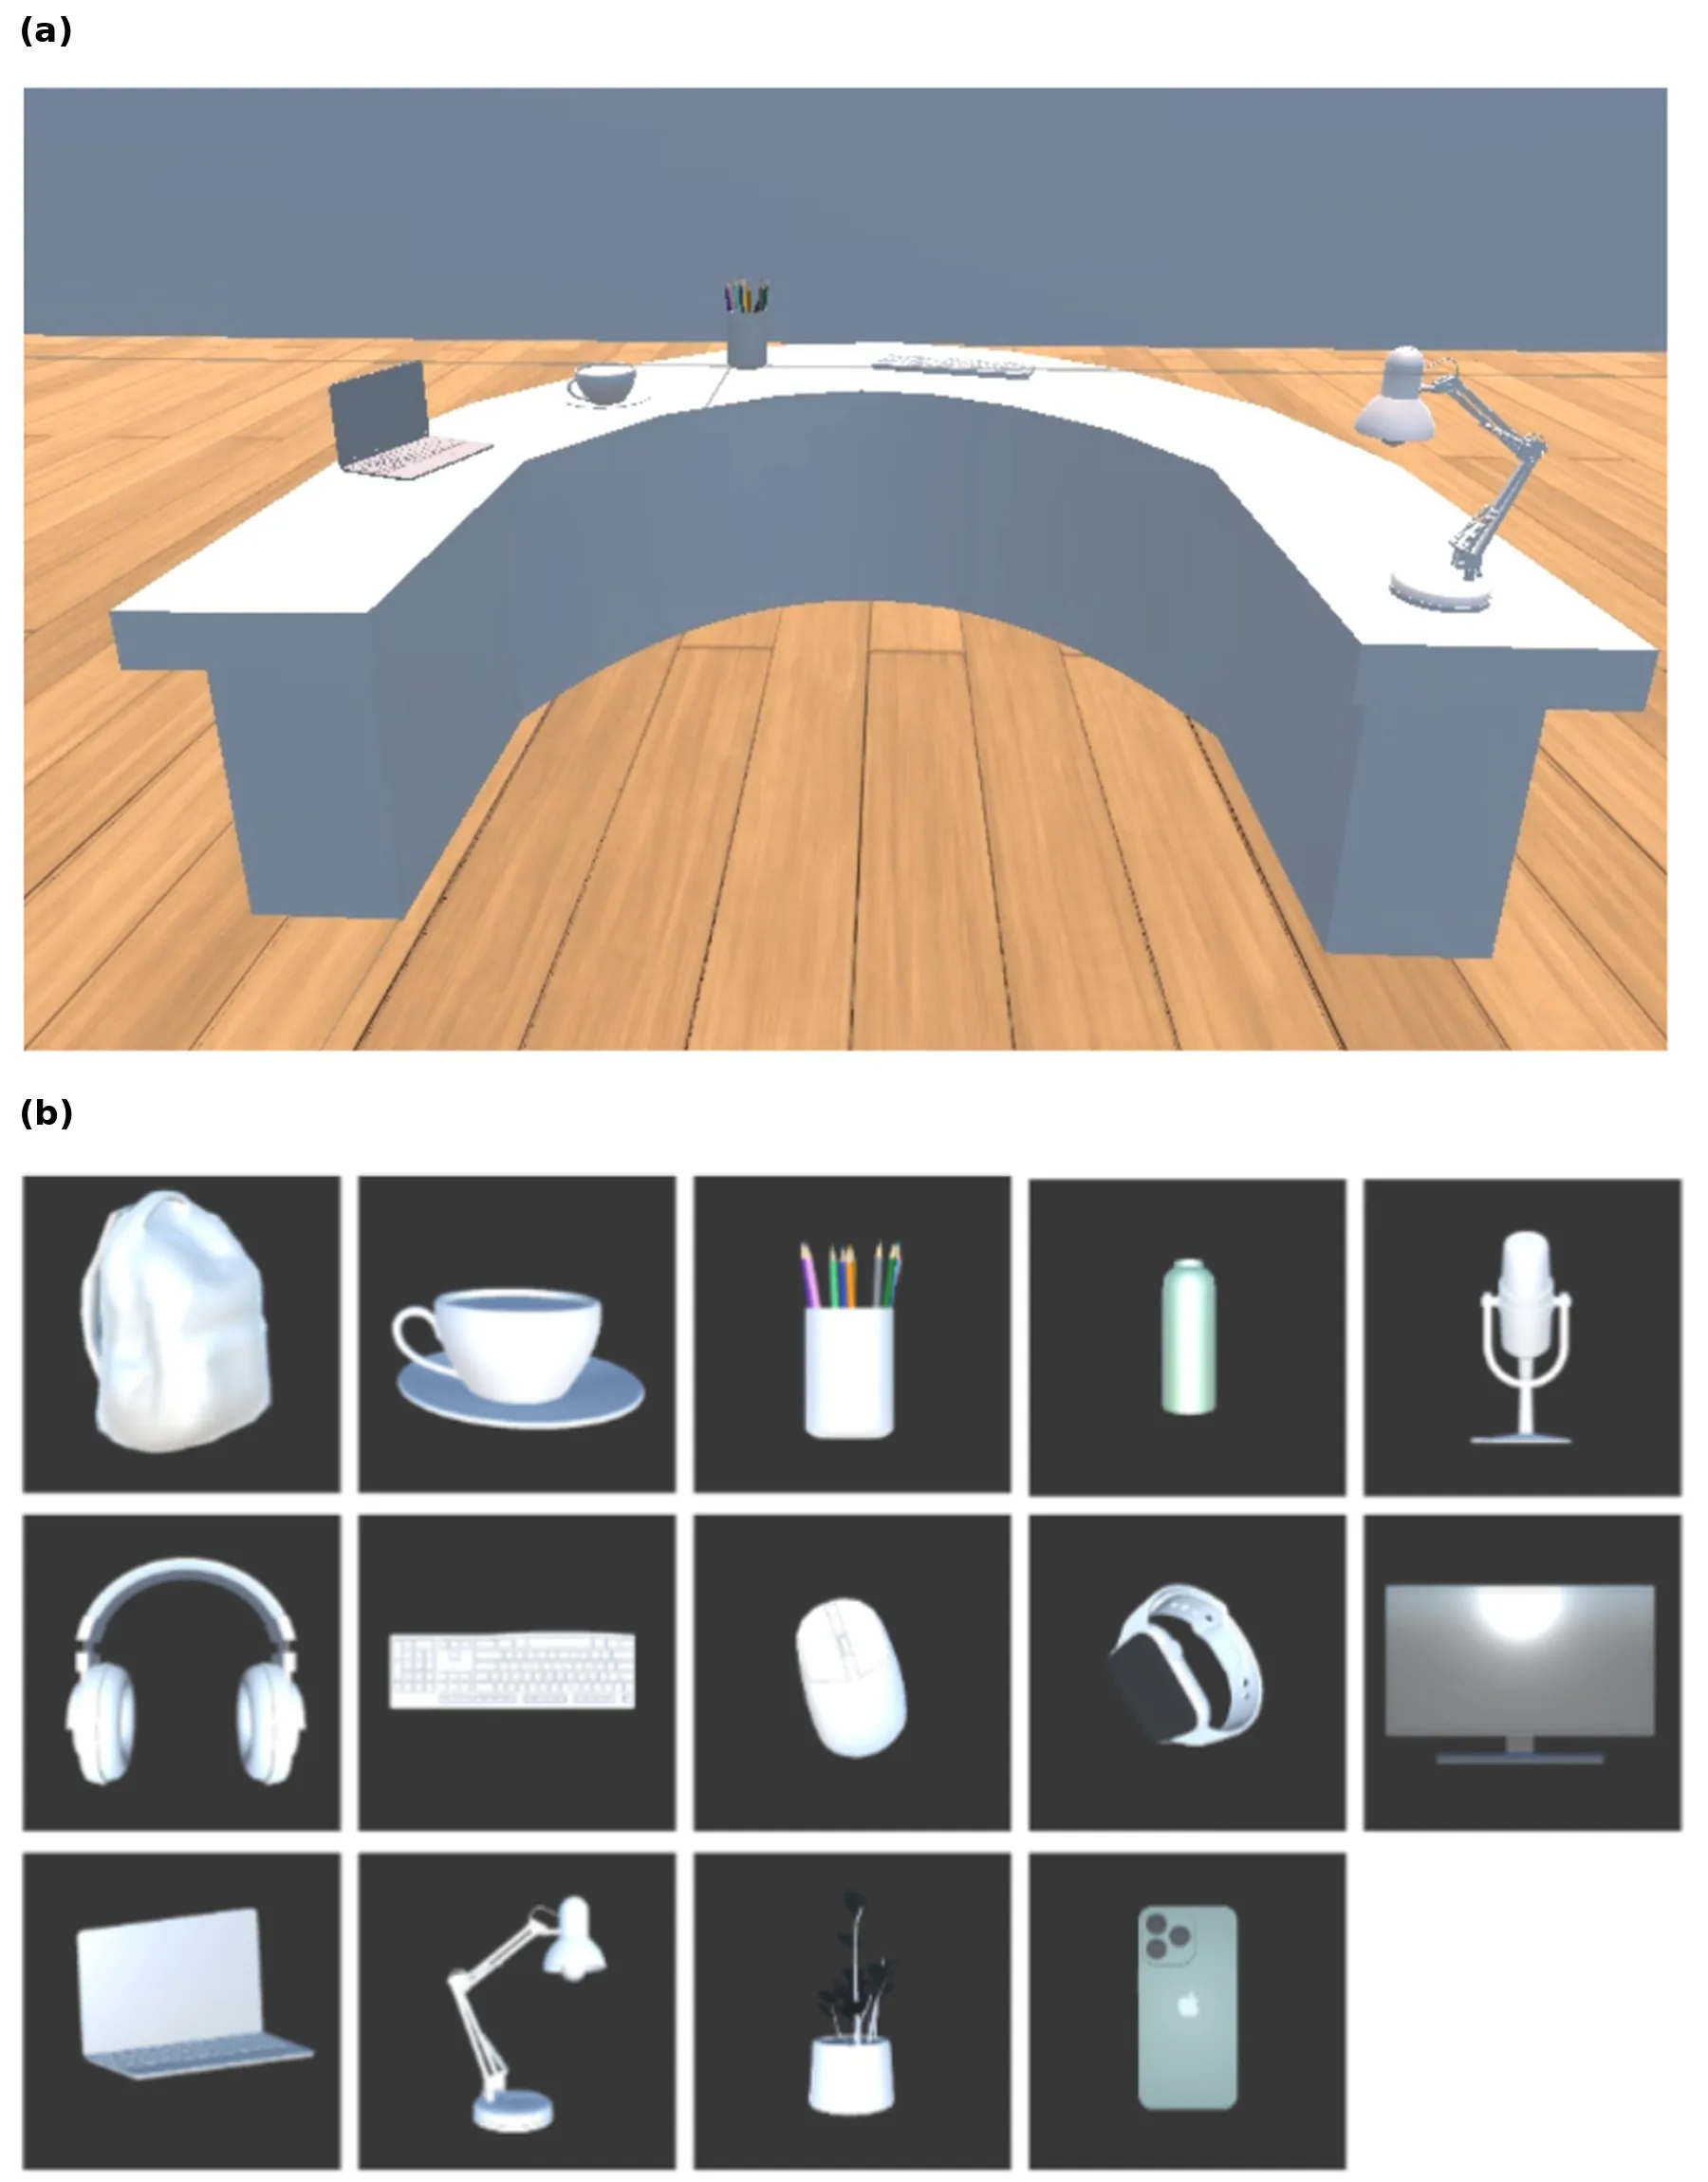
Группа исследователей попробовала подсказывать мозгу, когда он действительно сосредоточен на поиске. Двадцать два участника надели шлем виртуальной реальности с сухими электродами, которые считывали электрическую активность мозга (ЭЭГ). Перед ними возникал виртуальный стол, нарисованный редкой россыпью светящихся точек. Задача — как можно быстрее найти заданный предмет. После каждой попытки на экране появлялась цветная метка: зелёный огонёк, если специальный индекс вовлечённости — отношение быстрых бета-волн к сумме медленных альфа и тета — был высоким, и красный, если низким. Вторая группа видела такие же метки, но случайные, без связи с мозгом.
Улучшение наступило у всех: к концу сессии люди находили предметы быстрее и точнее. Но «умная» подсказка не дала преимущества — ни по скорости, ни по ошибкам, ни по ощущаемой нагрузке. Мозг учился сам, просто привыкая к мозаике фосфенов и вырабатывая собственные стратегии осмотра. Разброс между участниками оказался огромным: у одних вовлечённость росла синхронно с успехом, у других — нет.
Авторы не отказываются от идеи нейроадаптивного помощника. Они показали, что можно объединить ЭЭГ и протезное зрение в одной носимой системе. Но одной тренировки и грубого индекса вовлечённости недостаточно. Возможно, будущему ассистенту придётся подбирать персональный ритм для каждого пользователя — как настройка музыкального инструмента перед концертом.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2607.23889
Visual prostheses require users to interpret sparse and distorted artificial percepts through active visual search. We developed an EEG-guided neuroadaptive training platform for simulated prosthetic vision in immersive virtual reality and evaluated its feasibility in a sham-controlled object-localization task. Twenty-two sighted participants searched a virtual desk scene rendered through a low-resolution phosphene simulation while EEG was recorded using a dry-electrode headset integrated with a head-mounted display. During training, participants received post-trial visual feedback based either on a commonly used EEG engagement index, $$\beta/(\alpha+\theta)$$, or on visually matched non-contingent sham values. Both groups showed comparable within-session improvements in localization performance, consistent with practice, increasing familiarity with the simulated percepts, or refinement of search strategies. EEG-contingent feedback did not produce reliable group-level benefits in localization accuracy, completion time, workload, or modulation of the targeted index. Exploratory analyses showed substantial individual variability, but did not establish a feedback-specific relationship between the engagement index and behavioral performance. These findings demonstrate the feasibility of integrating EEG-contingent feedback with immersive simulated prosthetic vision, while identifying important limitations of the EEG measure, single-session training protocol, and post-trial feedback design.
Фосфены — те самые «звёздочки», которые мы видим, если сильно надавить на закрытые глаза. Именно из таких вспышек и состоит картинка в большинстве современных зрительных протезов.