Компьютерное зрение опирается на свёрточные нейронные сети (Convolutional Neural Networks, CNN). Их архитектура повторяет устройство зрительной коры: простые клетки реагируют на линии под определённым углом, сложные — на их комбинации. Свёрточный слой сканирует изображение маленьким окошком, перемножая его с фильтром и создавая карты признаков. Несколько таких слоёв последовательно собирают всё более абстрактные представления: от краёв и текстур до частей объектов и целых лиц. Современные системы используют также механизм внимания и трансформеры, обрабатывая изображение как последовательность патчей.
История
Отправной точкой считается работа Хьюбела и Визеля (1959) по устройству зрительной коры, вдохновившая иерархические модели. В 1963 Ларри Робертс реализовал программу «Blocks World», интерпретирующую фото кубиков. В 1970-е активно развивались геометрические методы. В 1990-е появились первые эффективные детекторы границ. Свёрточные сети предложил Ян Лекун в 1989, применив к распознаванию цифр. Настоящий переворот произошёл в 2012 году, когда Алекс Крижевский с коллегами выпустил AlexNet, использующую графические процессоры (GPU) — точность на ImageNet подскочила с ~74% до ~84%. В последующие годы архитектуры углублялись: VGG, ResNet (2015), решавший проблему исчезающих градиентов через пропускные соединения. С 2020 Vision Transformers (Dosovitskiy et al.) перенесли механизм самовнимания на изображения, а модели типа DALL·E 2 и Stable Diffusion научились порождать новые изображения по текстовому описанию.
Как это работает
Основной строительный блок — свёртка: ядро размера k×k умножается поэлементно на участок изображения, результат суммируется. Слой пулинга уменьшает разрешение, выделяя главное. Полносвязные слои принимают итоговый вектор признаков и выдают предсказание. Обучение ведётся методом градиентного спуска с обратным распространением ошибки. В современных системах часто предобучают крупную модель на больших датасетах (ImageNet-21k) затем дообучают на целевую задачу (transfer learning). Для порождения изображений применяют автокодировщики (VAE), генеративно-состязательные сети (GAN) и, в последнее время, диффузионные вероятностные модели, постепенно удаляющие шум из начального случайного поля до получения чёткой картинки.
Где применяется
Автомобиль распознаёт дорожные знаки и пешеходов в реальном времени, чтобы вовремя затормозить или предупредить водителя.
Любопытный факт
Система Google Translate может перевести текст на фотографии меню в реальном времени: вы наводите камеру на иностранный текст, а на экране он уже на русском — всё благодаря распознаванию и пониманию изображения.
В 1980-х годах соревнование DARPA по распознаванию речи положило конец спору между статистическими методами и рукописными правилами, задав единый стандарт для всей области. Для речевых нейроинтерфейсов, переводящих мозговую активность в слова, такого общего эталона до сих пор не было: каждая система использует свой словарь, способ записи и тип речи.
Радиолог смотрит на снимок брюшной полости и видит не просто органы, а их взаимное расположение: какая почка больше, где опухоль относительно сосуда. Это похоже на чтение карты, где важно не только знать, где обычно стоит город, но и уметь измерить расстояние между двумя точками на местности.
Заблудиться в зеркальном зале проще простого: каждая стена отражает другую, и кажется, что ты уже был здесь. Примерно так же путается мозг, когда вокруг много похожих мест. Нейроны — клетки, отвечающие за карту пространства, — могут выдать одинаковый сигнал для двух разных углов комнаты.
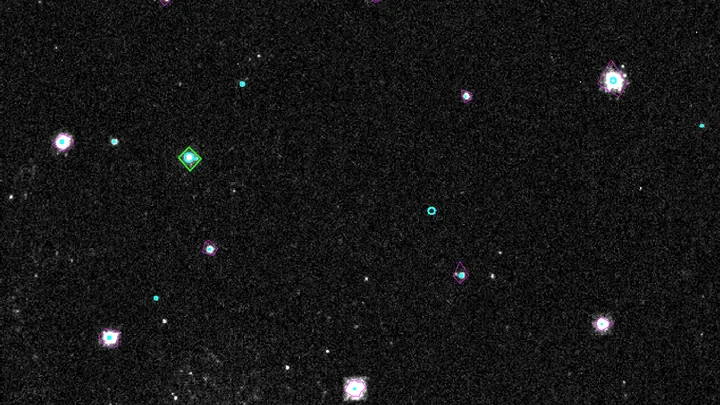
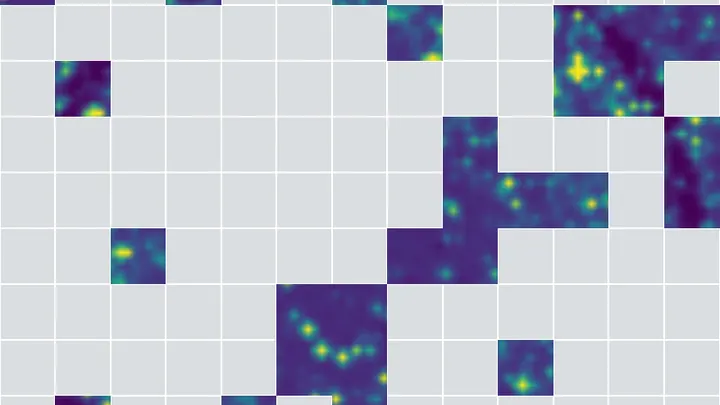
Представьте, что вы ищете светлячков в тёмном лесу. Вместо того чтобы фотографировать весь лес каждую секунду и потом разбирать снимки, вы носите с собой компактное устройство, которое само замечает вспышки и вырезает из кадра лишь небольшой кружок вокруг каждой. Остальное — чернота — не сохраняется. Именно так работает новый датчик для научных камер.
По оптоволокну данные летят со скоростью света, но дорога не идеальна: сигнал мутнеет, как голос в длинном коридоре. Чем выше скорость и дальше расстояние, тем сильнее искажения. Обычно их исправляют электроникой, но она не поспевает за светом.
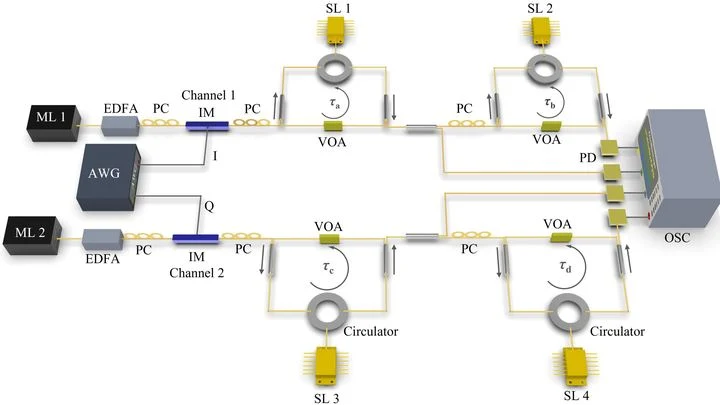
Учёные собрали световой компьютер из нескольких лазеров, связанных в цепочку.
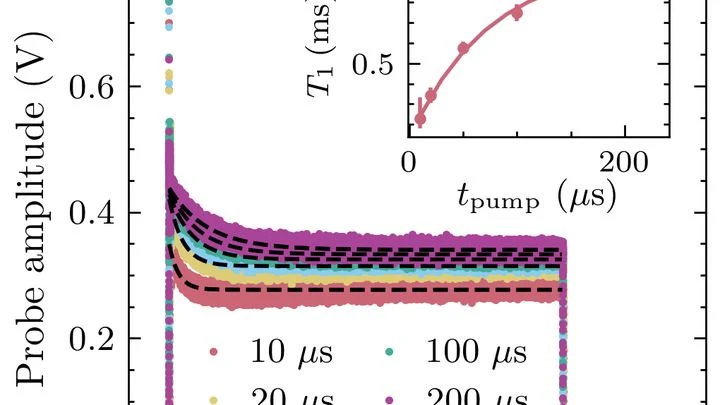
Луч света влетает в стеклянную кювету с парами цезия и меняет внутреннее состояние атомов — так записывается информация. Через мгновение другой луч считывает её по тому, как атомы поглощают свет. Это не жёсткий диск, а скорее блокнот, который сам переворачивает страницы.
Восемь таких «страниц» создаются акустооптическим дефлектором — устройством, которое отклоняет луч звуком.
Камера в смартфоне ловит свет крошечными датчиками, но сами по себе они не различают цвета. Поэтому перед ними ставят цветные фильтры: красный, зелёный, синий — как витражи в окне. Каждый датчик видит только свой цвет, а потом программа собирает из этих кусочков полную картинку.
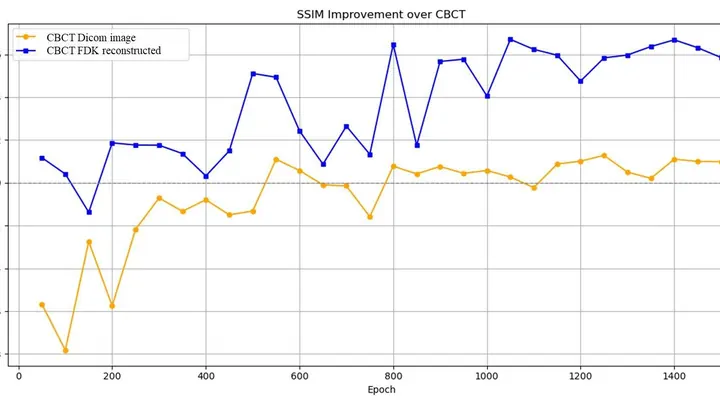
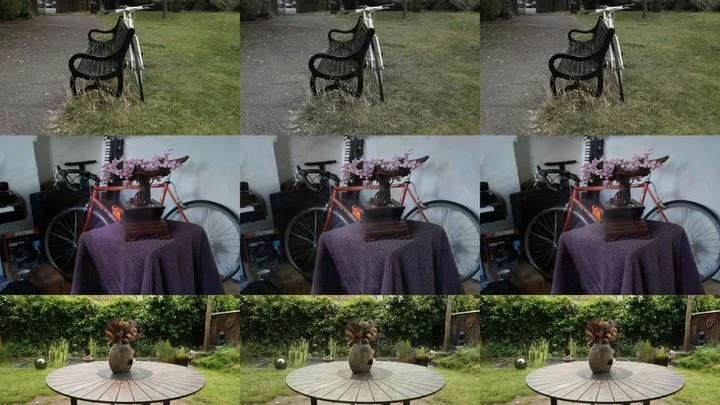
Снимок с низкой дозой рентгеновского излучения напоминает вид через запотевшее стекло: очертания угадываются, но детали тонут в мутной пелене. Врачам такие кадры нужны во время лучевой терапии — чтобы нацелить пучок точно в опухоль и не задеть здоровые ткани. Однако экономия излучения оборачивается шумами, полосами и пятнами, которые мешают разглядеть главное.
Прогноз выхода химической реакции — это попытка предсказать урожай, зная лишь состав почвы. Долгое время химики опирались на длинные колонки чисел, так называемые квантовые дескрипторы, которые описывают энергию электронов, но умалчивают о форме молекулы.
Прогноз выхода химической реакции — это попытка предсказать урожай, зная лишь состав почвы. Долгое время химики опирались на длинные колонки чисел, так называемые квантовые дескрипторы, которые описывают энергию электронов, но умалчивают о форме молекулы.
В спиральной галактике Фейерверк — 6410 звёздных яслей. Именно столько областей, где прямо сейчас рождаются массивные светила, выявил алгоритм на старых ультрафиолетовых снимках Хаббла. Это не просто пятна на картинке — у каждого есть чёткая граница, как у государства на контурной карте.
Каждое утро десятки телескопов наводятся на Солнце. Их камеры ловят узкую полоску красного света — линию Hα, открытую Иоганном Бальмером. На снимках проступают тёмные, прихотливо изогнутые нити. Они похожи на стежки гигантского гобелена, прошивающего раскалённую корону. Это солнечные волокна.
Глазной протез передаёт в мозг не фотографию, а редкий пунктир из светлых точек — фосфенов. Чтобы разглядеть в этой ряби чашку или ключи, человек вынужден водить головой, как фонариком в темноте, и по крупицам собирать очертания предмета. Это медленный процесс, похожий на сбор пазла, где большинство деталей выброшено.
Складывая пазл Вселенной, астрономы привыкли, что каждая новая деталь должна точно ложиться в уже сложенную картину. Но иногда попадаются кусочки, которые словно вырезаны из другой головоломки. Двадцать тысяч активных ядер галактик — и одиннадцать процентов из них нейросеть уверенно отбрасывает как чужеродные.
Каждый раз, когда ребёнок с церебральным параличом собирается пошевелить ногой, в его мозге возникает особый электрический всплеск — медленный сдвиг напряжения. Учёные называют его потенциалом, связанным с движением. Интерфейс мозг-компьютер (система, читающая намерения по сигналам мозга) может этот всплеск уловить и превратить в команду для тренажёра.
Камеры беспилотного автомобиля улавливают свет, словно телескопы, направленные на далёкую галактику. Каждый кадр — отрывочное наблюдение; вместе они должны сложиться в карту пути.
Компьютер, подобно астроному, не склеивает снимки, а генерирует несколько возможных видов сверху и сравнивает их с реальными данными.
Обычный радар фиксирует дрон лишь как точку на экране — безликий маркер в пространстве. Новый метод превращает радиоэхо в объёмную скульптуру: отражённый сигнал обрисовывает форму, наклон и характер движения объекта.
В трёхмерной сцене каждая точка подобна конфете с переливающейся обёрткой: её цвет меняется в зависимости от угла зрения. Чтобы описать эту игру оттенков, для каждой точки хранят десятки чисел — специальную математическую функцию, разложение в ряд, предложенное ещё Жозефом Фурье.
Мозг в медитации можно представить как оркестр, где внимание — дирижёр. Когда вы сосредоточены на дыхании, все «инструменты» играют слаженно. Но вот мысль-виолончель берёт фальшивую ноту — это естественное блуждание ума. Опытный дирижёр не паникует: он мгновенно улавливает диссонанс и мягко возвращает оркестр к главной мелодии — дыханию.
Учёные построили компьютерную модель этого процесса.
Обычные алгоритмы компьютерного зрения воспринимают медицинские изображения как набор несвязанных фрагментов — любые два несовпадающих снимка для них абсолютно различны. Это напоминает попытку отличить близнецов, не зная об их родстве. В медицине же пациенты с одним заболеванием часто выглядят на МРТ почти идентично, и алгоритм ошибается, путая «родственные» случаи.
Однопиксельная камера работает подобно художнику, создающему картину через трафарет с множеством отверстий. В каждом кадре на единственный датчик попадает лишь часть светового потока, модулированная маской — пространственным модулятором света, — а затем компьютер реконструирует целостное изображение, собирая эту мозаику с помощью вычислительных алгоритмов.
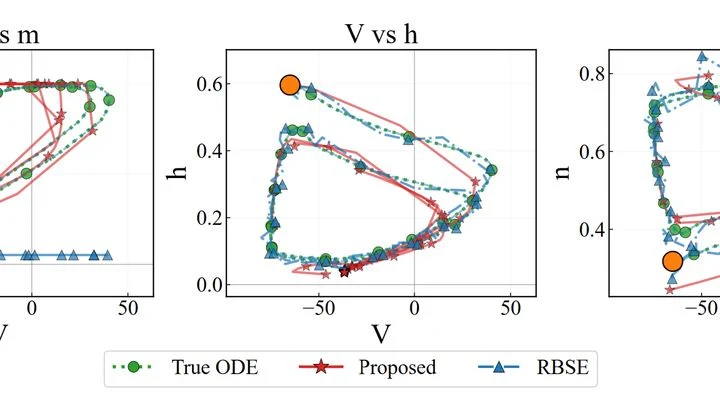
Многие природные процессы описываются дифференциальными уравнениями, но в распоряжении учёных часто оказываются лишь фрагментарные данные — своего рода обрывки карты. Новый вычислительный метод работает как картограф, восстанавливающий целостную карту местности по немногим ориентирам.
Классическая система слежения напоминает штурмана, прокладывающего курс по звёздам. Но стоит облакам закрыть небо — координаты начинают дрейфовать, а в данных нарастает энтропия — мера неопределённости. Новый алгоритм получает «второго пилота» — модуль, который непрерывно оценивает, насколько уверен основной навигатор в своих расчётах.
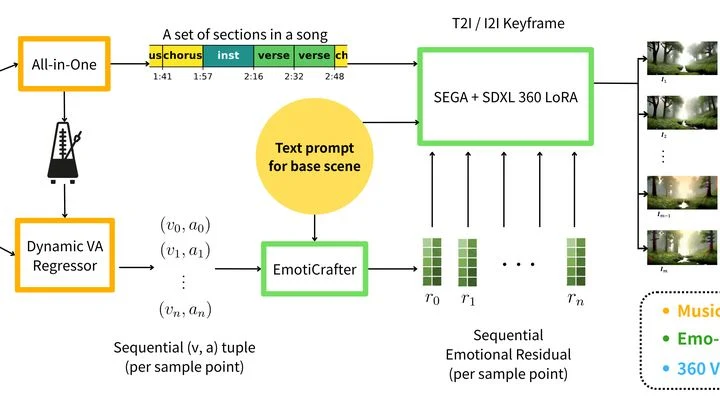
Дирижёр держит не палочку, а кисть, и каждый взмах рождает цвет и форму. Эта аналогия помогает понять новую технологию: она преобразует эмоциональную динамику песни в панорамное видео, окружающее слушателя, — подобно тому, как художник превращает замысел в объёмное полотно.
Данные о работе генов обычно выглядят как длинная строка чисел, напоминающая радужную полоску (спектр) без видимых связей. В модели scVision эти числа преобразуют в осмысленное изображение — не список ингредиентов, а фото готового блюда.
Современный стандартный подход к обучению искусственного интеллекта можно сравнить с ребёнком, запертым в библиотеке: он запоминает миллионы книг, но не знает, что огонь обжигает, а падение приносит боль.
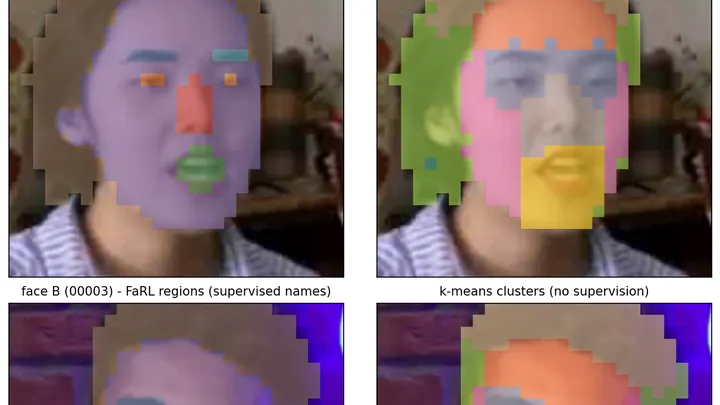
Обученная на обычных снимках без каких-либо меток, модель компьютерного зрения DINOv3 неожиданно проявила способность, напоминающую работу спектроскопа: она самопроизвольно научилась выделять на лицах отдельные зоны — глаза, нос, рот — словно раскладывая портрет на спектральные составляющие.
Человек в лодке интуитивно поворачивает, смещая вес собственного тела. Тот же физический принцип использует беспилотное судно: манёвр выполняет подвижный груз, перемещающийся внутри корпуса. Его движением управляет нейросеть — алгоритм, обученный предугадывать хаос волн и порывы ветра.
Томографы не создают готовых изображений напрямую. Их принцип работы — сбор множества «теней», то есть проекций внутренней структуры, полученных под разными углами или с помощью различных физических сигналов. Затем математические алгоритмы восстанавливают по этим проекциям трёхмерную картину.
Ребёнок, осваивая незнакомую квартиру, ползает от предмета к предмету и запоминает, что видно из каждого угла. Так мозг строит мысленную карту — внутреннюю модель пространства. Алгоритм gradCSCG действует по тому же принципу: он получает видеопоток с камеры и самостоятельно рисует схему помещения, опираясь лишь на смену картинок.
Представьте кухню с газовыми конфорками: каждая греет по-своему, и если повар переставит кастрюли, еда может подгореть. Так и в беспроводной сети: антенны-конфорки и пользователи-кастрюли требуют точной расстановки. Обычные нейросети не различают позиции, считая все конфорки одинаковыми, поэтому им трудно оценить качество связи или настроить передачу.
Представьте повара, который учится готовить исключительно по рисованным картинкам — он почти наверняка испортит каждое блюдо. Схожая ловушка подстерегает и компьютерное зрение: для обучения моделей требуются тысячи размеченных снимков, но собирать и аннотировать их вручную — дорого и муторно.
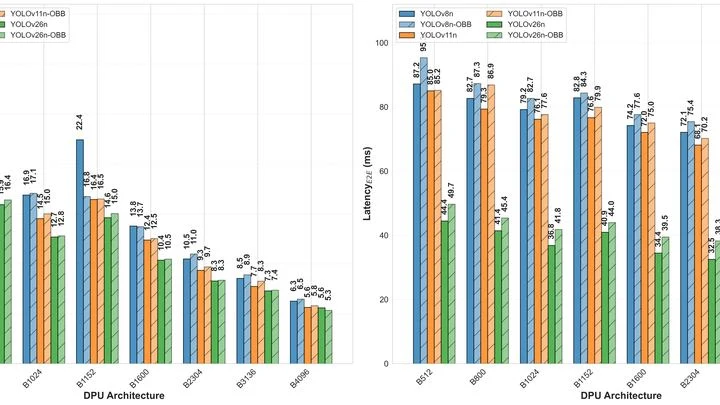
Современные системы машинного зрения обретают автономность: инженерам удалось реализовать алгоритм распознавания образов непосредственно на миниатюрном чипе, избавив камеру от необходимости передавать данные на громоздкий компьютер.
Поплавок в бачке унитаза — идеальный контроллер: чувствуя уровень воды, он мгновенно приводит систему в равновесие без оглядки на прошлое. Инженеры применили этот принцип к нейросетям. Они переписали стандартную архитектуру так, что вместо каскада вычислений она решает одно уравнение равновесия.
Сборка светового чипа похожа на игру, где нужно провести луч через лабиринт из крошечных зеркал и светоделителей. Каждый такой элемент работает как стрелка на железной дороге: он либо пропускает свет прямо, либо направляет на соседний путь. Задача — получить на выходе строго определённый световой узор, потратив как можно меньше «стрелок».
Обычно инженеры годами ищут самый короткий маршрут для каждой задачи.
Электронный микроскоп — гигантский орган: вместо труб — электромагнитные линзы, вместо воздуха — поток ускоренных электронов. Раньше он лишь рисовал немые фрески атомного мира, обрекая учёных на изнурительную расшифровку.
Вглядитесь в ночное небо — перед вами не россыпь огней, а многослойная рукопись. Под яркими чернилами звёзд и галактик проступает блёклый, почти стёртый текст. Это послание тёмной материи, начертанное гравитационным линзированием: невидимые массы искажают свет далёких галактик, оставляя едва заметные водяные знаки на космическом пергаменте.
Гравитационное микролинзирование — удивительный космический эффект, предсказанный Эйнштейном и развитый Цвикки. Массивное тело, проходя между нами и далёкой звездой, искривляет её свет подобно линзе, создавая характерные усиления и искажения.
В юной Вселенной, около десяти миллиардов лет назад, галактики напоминали бескрайние поля после грозы: повсюду, вскипая, всходили гигантские — в тысячи световых лет — сгустки звездорождения, где молодые звёзды нарождались с безудержной энергией. Сегодня эти участки — почти исчезнувший вид: в окрестных галактиках буйные очаги встречаются редко.