مرشح ذكي للجسيمات النادرة سريع
في أعماق جبل، تحت طبقات الصخور، توجد بلورة جرمانيوم بحجم قبضة اليد. تنتظر حدثًا نادرًا للغاية: اضمحلال ذرة يحدث مرة كل مليارات السنين. لكن داخل البلورة هناك دائمًا شيء يطن — الأشعة الكونية، وآثار النشاط الإشعاعي، والضوضاء الحرارية. فصل الإشارة الحقيقية عن هذه الخلفية يشبه سماع همسة في حفلة موسيقى صاخبة.
في السابق، كان الفيزيائيون يستمعون إلى نغمات منفردة فقط: يقيسون مدى سرعة تصاعد الإشارة، وكم الطاقة المنبعثة، ومدة اضمحلالها. بناءً على هذه النغمات، كانوا يقررون ما إذا كان الحدث مشابهًا للاضمحلال المطلوب. لكن هذا النهج كان يفقد التفاصيل. الآن، تم وضع شبكة عصبية على المسار الصوتي بأكمله — محول قادر على التقاط الاختلافات الدقيقة في شكل النبضة. إنه لا يقارن الأرقام فحسب، بل يرى النمط بأكمله، مثل موسيقي خبير يسمع نغمة خاطئة في وتر.
النتيجة فاجأت الجميع: وجدت الشبكة العصبية أحداثًا حقيقية أكثر بنسبة 20% من الطرق القديمة، مع نفس مستوى الإنذارات الكاذبة. وفي الحالات الأكثر تعقيدًا، حيث تكاد الإشارة تندمج مع الضوضاء، يكون الربح أكبر. هذا يعني أننا نستطيع التعمق أكثر في سر النيوترينو — الجسيم الذي ربما يساوي نقيضه. إذا كان الأمر كذلك، فإن الاضمحلال الذي يلتقطه الكاشف سيكشف لماذا يوجد في الكون مادة بينما اختفت المادة المضادة.
الآن، لا يستمع الكاشف إلى النغمات العالية فقط، بل إلى همس الكون بأكمله.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2603.06192
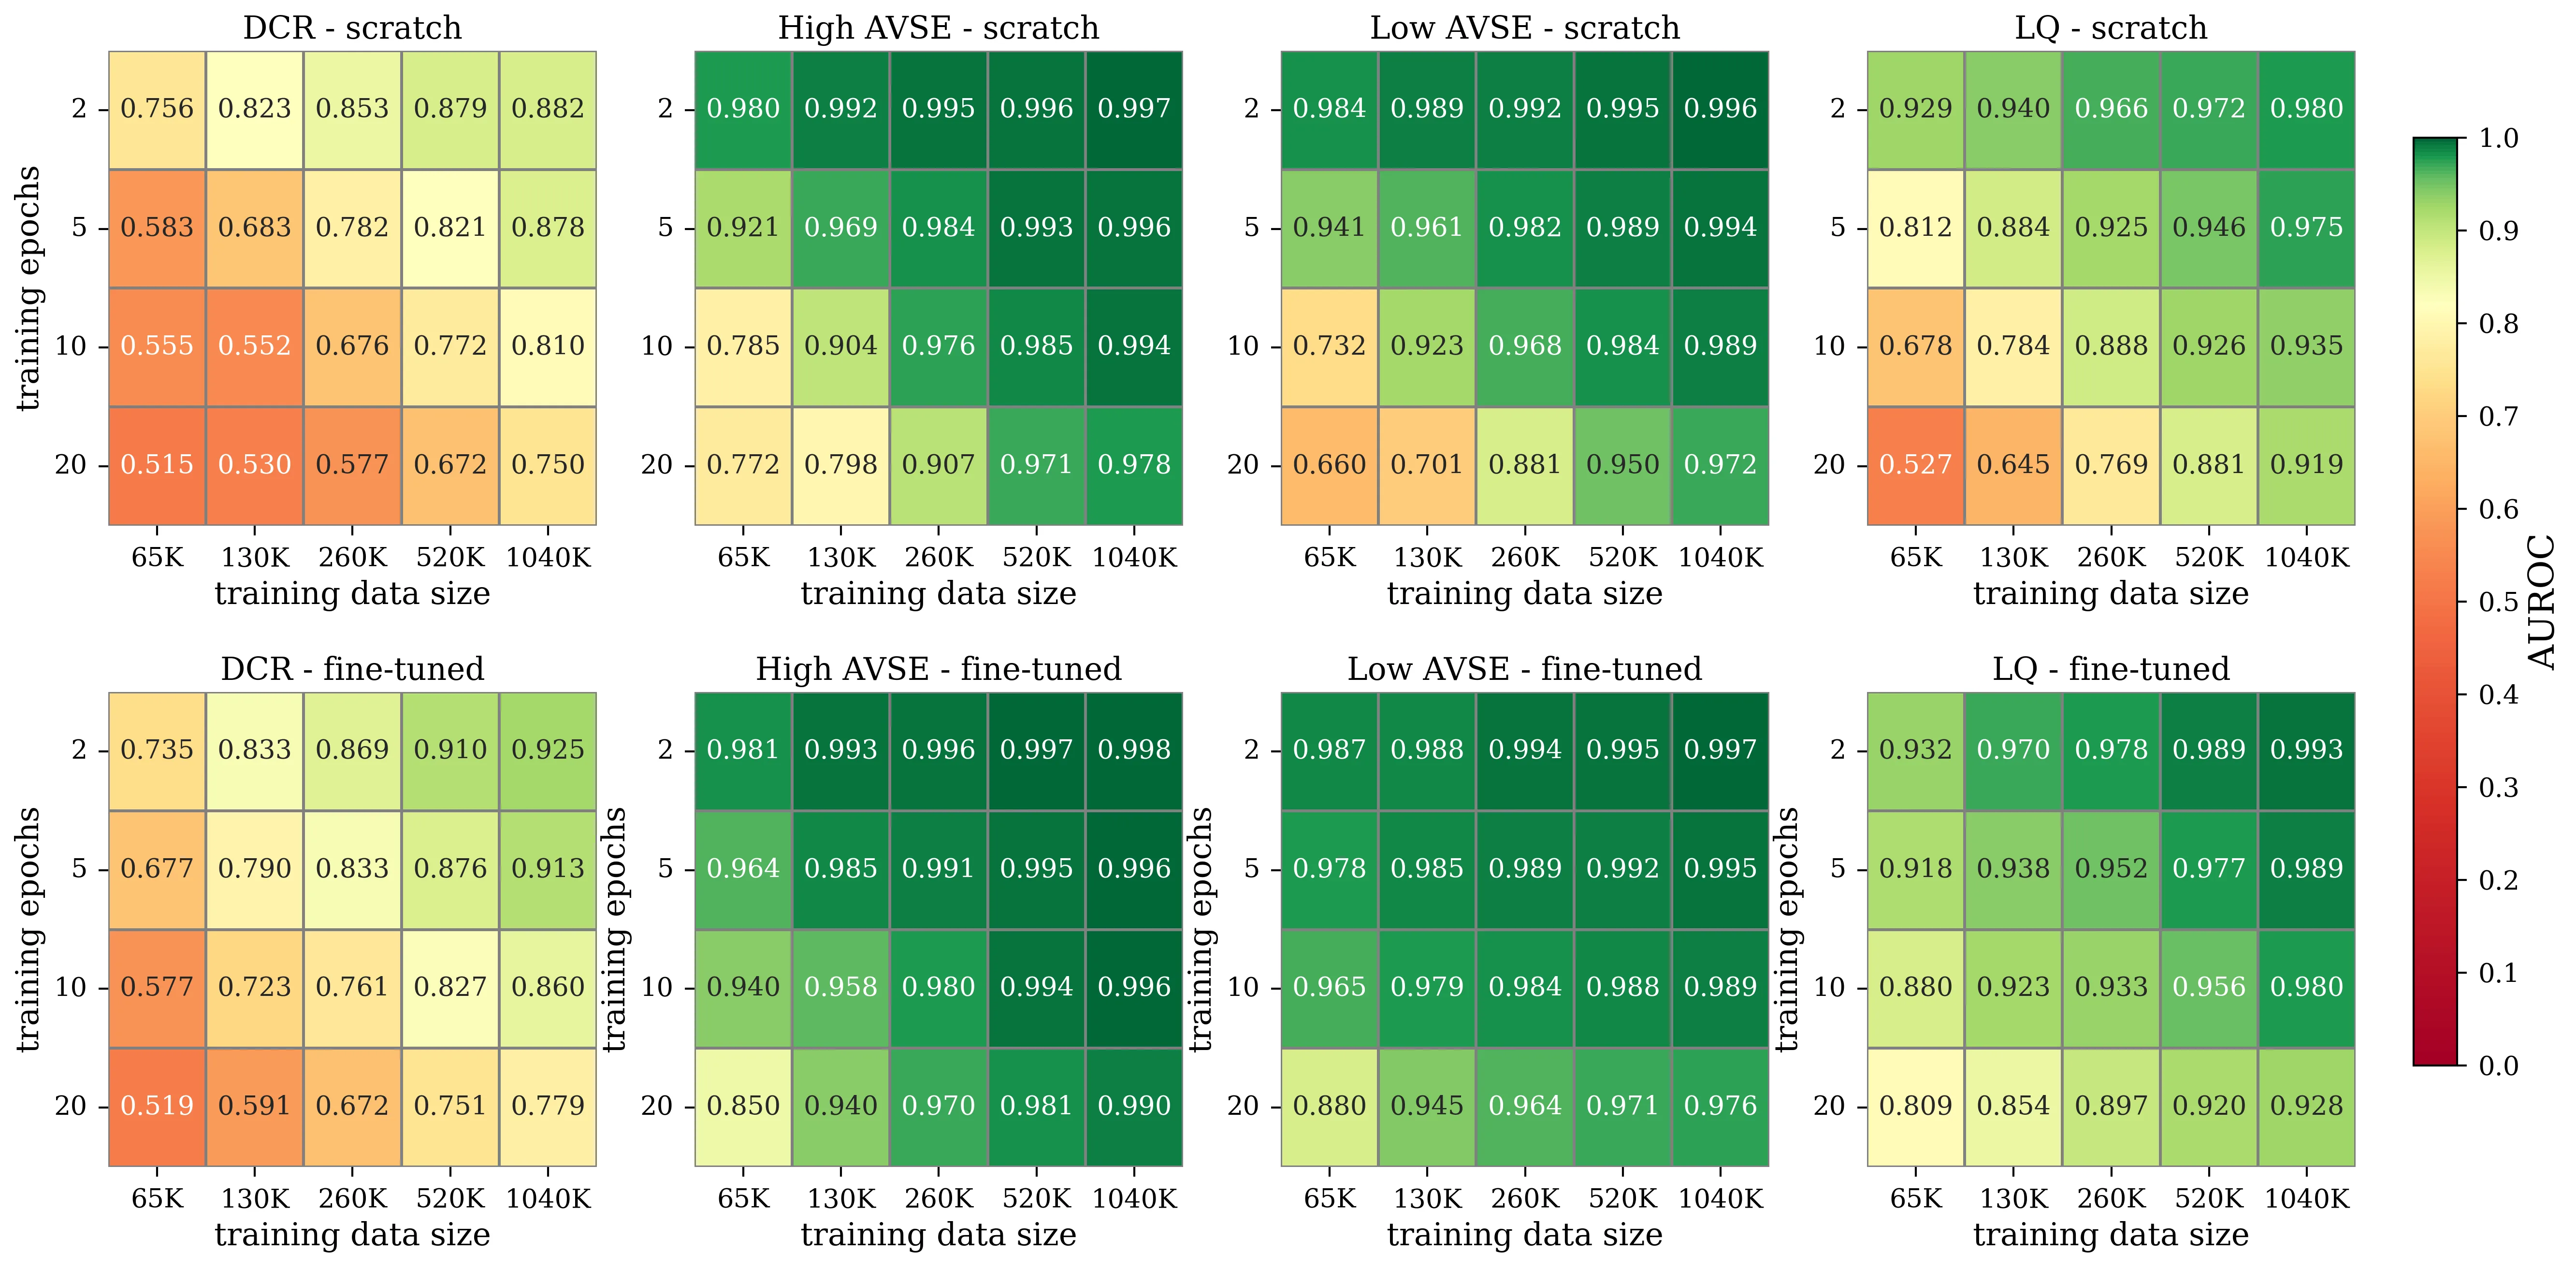
Pulse-shape discrimination (PSD) in high-purity germanium (HPGe) detectors is central to rare-event searches such as neutrinoless double-beta decay (0vBB), yet conventional approaches compress each waveform into a small set of summary parameters, potentially discarding information in the full time series that is relevant for classification. We benchmark transformer-based models that operate directly on digitised waveforms using the Majorana Demonstrator AI/ML data release. Models are trained to reproduce the collaboration-provided accept/reject labels for four standard PSD cuts and to regress calibrated energy. We compare supervised training from scratch, masked autoencoder (MAE) self-supervised pre-training followed by fine-tuning, and a feature-based gradient-boosted decision tree (GBDT) baseline. Transformers outperform GBDT across all PSD targets, with the largest gains on the most challenging labels and on the combined PSD-pass definition. MAE pre-training improves sample efficiency, reducing labelled-data requirements by factors of 2-4 in low-label regimes. For energy regression, both transformer variants show a small common underestimation on the test split, while fine-tuning modestly narrows the residual distribution. These results motivate follow-up studies of robustness across detectors and operating conditions and of performance near QBB.
تُزرع بلورة الجرمانيوم لهذا الكاشف على مدى أشهر، ثم تُحفظ عند درجة حرارة النيتروجين السائل لمنع الضوضاء الحرارية من إغراق الإشارات الضعيفة.