تشير البيانات المُعلَّمة إلى مجموعات البيانات التي يقترن فيها كل مثال إدخال بالقيمة الصحيحة أو الهدف المطلوب، مما يوفر الحقيقة الأساسية التي تستخدمها نماذج التعلم الخاضع للإشراف للتعلم. في مهام مثل تصنيف الصور، أو التعرف على الكلام، أو التشخيص الطبي، تعمل البيانات المُعلَّمة كمعلم: يضبط النموذج معالمه الداخلية لتقليل الفرق بين توقعاته والتسميات المقدمة. غالبًا ما تكون جودة وكمية البيانات المُعلَّمة هي العوامل الأكثر أهمية في تحديد أداء النموذج.
التاريخ
يعود استخدام البيانات المُعلَّمة في التعلم الآلي إلى تجارب البيرسبترون المبكرة في الخمسينيات والستينيات من القرن العشرين، لكنه أصبح نموذجًا مركزيًا مع صعود التعلم العميق في العقد الثاني من القرن الحادي والعشرين، عندما قادت مجموعات البيانات المُعلَّمة الكبيرة مثل ImageNet طفرات في الرؤية الحاسوبية.
كيف يعمل
أثناء التدريب، يعالج النموذج الخاضع للإشراف المدخلات المُعلَّمة، ويقوم بتنبؤات، ويقارنها بالتسميات الحقيقية باستخدام دالة خسارة. ثم يُعاد نشر الخطأ عبر الشبكة، مما يحدّث الأوزان لتقليل الأخطاء المستقبلية. هذه العملية التكرارية، التي تتكرر عبر العديد من الأمثلة، تسمح للنموذج بتعميم الأنماط من البيانات المُعلَّمة إلى المدخلات غير المرئية. تؤثر دقة التسميات مباشرة على موثوقية النموذج، لأن التعليقات التوضيحية غير الصحيحة تعلّم النموذج ارتباطات خاطئة.
في التطبيق
تُستخدم البيانات المُعلَّمة في تطبيقات تتراوح من تصفية البريد العشوائي وكشف الاحتيال إلى القيادة الذاتية، حيث تقوم الصور المُعلَّمة للطرق والعوائق بتدريب أنظمة الإدراك.
حقيقة طريفة
إن إنشاء البيانات المُعلَّمة يتطلب عمالة مكثفة لدرجة أنه ولّد صناعة عالمية من عمال 'التعليق على البيانات'، حيث يقوم ملايين الأشخاص بتسمية الصور والنصوص والصوت لتدريب الذكاء الاصطناعي.
كانت خرائط الكنز القديمة تُرسم بناءً على إشاعات: فمن وجد ذهبًا عند النهر، ومن وجده في الجبال، وكان كلٌّ يحفر في مكانه. حدث شيء مشابه مع الموصلات الفائقة ذات درجة الحرارة المرتفعة: وُجدت الكوبرات في مركبات معينة، وبكينتيدات الحديد في أخرى، والنيكيلات في ثالثة، دون وجود خريطة موحدة.
ينظر أخصائي الأشعة إلى صورة البطن ولا يرى مجرد أعضاء، بل يرى ترتيبها المكاني: أي كلية أكبر، وأين يقع الورم بالنسبة للوعاء الدموي. هذا يشبه قراءة خريطة، حيث لا يكفي أن تعرف أين تقع المدينة عادةً، بل يجب أن تكون قادرًا على قياس المسافة بين نقطتين على الأرض. باحثون من IIIT Hyderabad وAIG Hospitals بنوا SPAR-Bench، وهي ثماني مهام تختبر ما إذا كانت نماذج الرؤية الطبية قادرة على هذا النوع من الاستدلال.
أطلس قديم لطرق السيارات ملقى على الطاولة. على صفحاته تصل الخطوط بين المدن، ويشير سُمك كل خط إلى مدى ازدحام الحركة عليه. تنظر شبكة عصبية إلى خريطة كهذه وتخبرك بعمر السيارة التي سارت عليها. بهذا التقريب تقريبًا صُمِّم النموذج الذي دُرِّب على التنبؤ بعمر الإنسان من خريطة روابط دماغه.
بدل المدن، تحتوي هذه الخريطة على 84 منطقة من مناطق الدماغ، وبدل الطرق، حزم من الألياف العصبية تصل بينها.
الألماس ليس مجرد حلي. داخل شبكته البلورية تختبئ عيوب تستشعر المجال المغناطيسي أفضل من كثير من الأجهزة. أحد هذه العيوب هو مركز NV، الذي يعمل كبوصلة مصغرة، لكن إبرته تهتز بسبب الحرارة والضوضاء. لكي تشير البوصلة إلى الاتجاه الصحيح، نحتاج إلى معايرة. عادةً ما تكون هذه عملية يدوية طويلة، وهنا تتعلم الشبكة العصبية بنفسها.
من السهل جدًا أن تضيع في قاعة المرايا: كل جدار يعكس الآخر، ويبدو أنك كنت هنا من قبل. بنفس الطريقة تقريبًا يرتبك الدماغ عندما يكون هناك الكثير من الأماكن المتشابهة حوله. العصبونات — الخلايا المسؤولة عن خريطة الفضاء — قد تُصدر إشارة متطابقة لزاويتين مختلفتين من الغرفة. تُسمى هذه الظاهرة بالغموض المكاني: يتلقى الدماغ معلومات غامضة حول موقع الجسم بالضبط.
مهندس البروتينات يشبه طاهياً يحاول أن يجعل الطبق لذيذاً ومفيداً ورخيصاً في نفس الوقت. بتغيير مكوّن واحد، يخاطر بإفساد مكوّن آخر. في السابق، كانت المساعدات الحاسوبية تقيّم خصائص البروتينات بشكل منفصل فقط، دون رؤية كيفية ارتباطها ببعضها البعض.
كاميرا تراقب وجه الشخص ويديه، ومن خلال تغيرات طفيفة في حرارة الجلد تدرك أنه يمر بضغط نفسي. حرارة الجسم مثل حبر خفي يظهر عند الإجهاد. يندفع الدم إلى بعض المناطق وينسحب من أخرى، وتكون الصورة مختلفة لكل شخص. المهمة هي العثور في هذا النمط الحراري على المناطق واللحظات التي تكشف القلق. أجهزة الاستشعار المعتادة على المعصم تتطلب أن يرتديها الشخص.
شعاع الليزر لا يعرف فقط كيف يسخّن، بل يعرف أيضًا كيف يهدّئ الحركة. عندما يدخل الضوء إلى مصيدة من المرايا، فإنه يضغط عليها — وإذا ضُبط لون الشعاع بشكل صحيح، يتحول الضغط إلى كبح لطيف. هكذا تُبرَّد الاهتزازات الميكانيكية الدقيقة حتى قرب الصفر المطلق. عادةً، يتم ذلك ببساطة عن طريق اختيار لون ثابت لليزر وقوة توهجه.
مؤلفو العمل الجديد حوّلوا الضبط إلى رقصة.
مائة ألف نجم في النواة المزدحمة لعنقود نجمي كروي تتحرك ككرات فولاذية في آلة بينبول عملاقة. كل «دفعة» — لقاء ثقالي بين نظام مزدوج ونجم منفرد — تشعل سلسلة من الأحداث غير المتوقعة. قد يتفرق الزوجان، وقد يُزيح النجم الدخيل أحد الشريكين ويحتل مكانه، وأحياناً يعلق الثلاثة في رقصة هرمية معقدة.
استعادة صورة كاملة من أجزاء متقطعة تشبه سماع لحن الأوركسترا في قاعة صاخبة. تظهر مثل هذه المهام في الفوتومتري، حيث تُستعاد شدة إضاءة نجم من وميضه الضعيف. تتطلب الطرق التقليدية معلومات دقيقة عن التشويش، وهي غالبًا غير معروفة.
الخوارزم الجديد يصقل نموذج بياناته بنفسه: كالعازف الذي يضبط آلته أثناء العزف، فهو يقلل درجة الإنتروبيا خطوة بخطوة.
يحتاج الطيار في القتال إلى فهم فوري للهدف ونواياه. تنتظر الأنظمة التقليدية بيانات الرادار الكاملة، تمامًا مثل حارس المرمى الذي لا يتفاعل إلا بعد التسديدة. تعمل الخوارزمية الجديدة كحارس مرمى خبير: من خلال الحركات الأولى للمهاجم، تتنبأ بمناورة الهدف.
تجمع الخوارزمية الإشارات المتقطعة وتُحسّن الاستنتاج تدريجيًا.
روبوتات الاستكشاف تشبه مجموعة من الطهاة يتذوقون طبقًا واحدًا. كل واحد يأخذ عينة من منطقته ويشارك انطباعه: فارغة، مشغولة، أو غير واضحة. لكن الأذواق نسبية — فقد لا يلاحظ البعض ساق كرسي، أو قد يتذوق البعض حافة فقط. بدلاً من حساب متوسط الآراء المتضاربة، تتفق الروبوتات على أن تكتب بصراحة 'لا أعرف' في المناطق غير المؤكدة. لتحقيق ذلك، يتبادلون قيمة e — وهي مقياس لعدم اليقين (مدى الشك في تقريرهم).
تتصرف إشارات الراديو في الأماكن المغلقة مثل الموجات الصوتية في قاعة الحفلات: إذ تنعكس مرارًا وتكرارًا عن الجدران والأثاث والأسطح الأخرى، فتشكل نمط تداخل فريدًا — وهو بمثابة «لحن» صامت لكل مكان. الهاتف الذكي المزود بجهاز استقبال، وكأنه أذن حساسة، يسجل هذا النمط من خلال تحليل التداخلات وتشوهات الإشارة.
الذكاء الاصطناعي التقليدي ينظر إلى الصور الطبية كما لو كانت أحجية من قطع غير مألوفة — فهو يعتبر أي صورتين غير متطابقتين مختلفتين تمامًا. هذا أشبه بمحاولة التمييز بين توأمين دون معرفة قرابتهما. أما في الطب، فالمرضى المصابون بنفس المرض يبدون متشابهين تقريبًا في صور الرنين المغناطيسي، فيخطئ الخوارزم ويخلط بين "الأقارب".
الذكاء الاصطناعي الذي يتنبأ بصوتيات قاعة ما يشبه طالباً في امتحان يحفظ الإجابات دون فهم. إذا كانت نقاط الفحص هي نفسها نقاط التدريب، يقوم النموذج ببساطة بحفظ "البصمة" الصوتية لكل موضع – كطالب يتعرف على ورقة الأسئلة من ثنية صغيرة فيها. شَدِّد القواعد – جمِّع البيانات حسب المواقع وأخفِ الدلائل الترددية – وستنهار الدقة من 85% إلى 9–57%.
النماذج التي تحول النص إلى صوت تتقن إعادة إنتاج الأصوات المنفردة، لكنها تحتار عندما يتضمن السيناريو عدة أحداث. على سبيل المثال، وفقًا للسيناريو يأتي رنين الجرس أولاً، ثم خطوات الأقدام، ثم صوت إغلاق الباب. قد يعيد المولد ترتيب الأحداث، فيسمع المستمع خطوات الأقدام قبل رنين الجرس.
وجد الباحثون حلاً غير متوقع: بدلاً من برمجة قواعد معقدة، أخذوا شبكة عصبية 'تفهم' الصوت، وجعلوها مراقبًا صارمًا.
حكّام الكلام الآليون هم خوارزميات تُقيّم النطق والعواطف. لكنهم غالبًا ما يعملون كناقد طعام يُصدر حكمه بعد قراءة القائمة دون تذوّق الطبق. فبدلاً من تحليل الصوت، يتشبث النموذج بالمؤشرات النصية — كما لو كان يحكم على طبق من خلال وصفتها لا مذاقها. أظهرت التجارب أنه إذا قمت ببساطة بتبديل تسجيلين صوتيين، فإن حكم الذكاء الاصطناعي يغيّر درجته، رغم بقاء الصوت كما هو.
النهج المعياري الحالي لتعلم الذكاء الاصطناعي يشبه طفلًا محبوسًا في مكتبة: يتذكر ملايين الكتب، لكنه لا يعلم أن النار تحرق، وأن السقوط يسبب الألم. أدمغتنا، المبنية من الكربون ومواد بسيطة أخرى، تعمل بطريقة مختلفة: أولاً يستكشف الجسد العالم من خلال الحركات واللمسات والأخطاء، وعندها فقط تكتسب الكلمات معناها.
الدماغ يتحدث عبر طقطقات كهربائية قصيرة. في السابق، لتعلم هذه اللغة، كانت هناك حاجة إلى آلاف الأمثلة المترجمة من قبل المجرِّب. طريقة MOJO تسلك مسارًا مختلفًا: كما يحدث عند تعلم لغة عن طريق الانغماس، فهي أولاً 'تستمع' إلى 'تيار الوعي' دون أي تلميحات وتجد بنفسها الأنماط المتكررة.
تقييم جودة الصورة مهمة تحتاج إلى مفتش دقيق يحمل مجموعة من الأدوات. شبكة IQA-T1 العصبية تتصرف تمامًا هكذا: فهي لا تكتفي بالتحديق في الصورة، بل تستخدم تارة مطيافًا وتارة مقياس إضاءة. الضوضاء الرقمية، مثل تموجات على سطح الماء، تخفي العيوب، لكن تحليل الترددات — مطيافية الصورة — يكشف فقدان الوضوح.
الطفل، وهو يستكشف شقة غير مألوفة، يزحف من شيء إلى آخر ويتذكر ما يراه من كل زاوية. هكذا يبني الدماغ خريطة ذهنية — نموذجاً داخلياً للفضاء. خوارزمية gradCSCG تعمل بالمبدأ نفسه: تستقبل بثاً من الكاميرا وترسم مخطط المكان بنفسها، معتمدة فقط على تغير الصور. في السابق، كانت الآلات تحتاج إلى تلميحات — مثل كائنات محددة مسبقاً في الصور. أما الطريقة الجديدة فتستغني عنها.
في غرفة صاخبة، يميز الإنسان الصوت المطلوب بفضل الأذنين اللتين تلتقطان الفرق في وصول الصوت. يعمل الكمبيوتر المزود بعدة ميكروفونات بالطريقة نفسها: يحصل على تلميحات مكانية — من أين يتحدث كل شخص.
في السابق، كانت هذه التلميحات تُستخدم للتركيز على اتجاه واحد، مثل شعاع المصباح. لكن عند تداخل الأصوات، كان التركيز يتشتت ويُفقد جزء من الإشارة — كما لو كنا نحاول رؤية ممثلَين في نفس شعاع الكشاف دفعة واحدة.
تخيّل طبّاخًا يتعلّم الطهي من صور مرسومة فقط — شبه مؤكد أنه سيفسد كل طبق. فخّ مشابه يتربّص بـ الرؤية الحاسوبية: تدريب النماذج يتطلب آلاف الصور الموسومة، لكن جمعها ووضع العلامات عليها يدويًا مكلف ومضجر. الصور الاصطناعية المولّدة بالخوارزميات تحل المشكلة، لكن بشرط أن تبدو حقيقية. هنا تظهر أداة GraNatPy التي تقيّم مصداقية الصور الاصطناعية.
عندما تكتب "سلطة" وتقترح لوحة المفاتيح الذكية "قيصر"، خلف الكواليس تتعلم ملايين الهواتف معًا التنبؤ بالكلمات. إنها لا تتبادل رسائلك، بل فقط تحسينات الخوارزمية المشتركة — مثل مدرب يرسل للرياضيين فقط التغييرات في خطة التدريب: "أضف 5 تمارين ضغط إلى برنامج الأمس".
أخذ العلماء 16 نشاطًا يوميًا — من غسل الأطباق إلى القرفصاء — وحللوا الحركات إلى مكونات أولية، تمامًا كما يحلل المطياف الضوء إلى طيف. بعد مقارنة ثلاث طرق، وجدوا مفتاحًا غير متوقع للتعرف: لقطة متوسطة واحدة تكفي. تسعة مفاصل فقط من بين عشرات المفاصل حملت المعلومات الحاسمة — ولم تؤثر البقية تقريبًا.
يشبه البحث في الإنترنت غربلة الدقيق للخبز: قد تظهر بين الجزيئات البيضاء بقع داكنة من التربة. هذا هو تلوث البيانات - شوائب غير ملحوظة تفسد النتيجة النهائية. يعمل C3R كمنخل ذكي: فهو لا يغربل فقط النفايات المعلوماتية، بل يمكنه أيضًا التوقف إذا كانت النفايات كثيرة جدًا. بدلاً من المخاطرة، ترفض الخوارزمية الإجابة بأمانة.
النهج القياسي لرقمنة الكلام، الذي يقوم عليه النموذج القياسي للاتصالات الحديثة، هو أخذ عينات مباشر: آلاف المرات في الثانية يتم تسجيل شدة الإشارة اللحظية. تخيل أنك تتذوق المرق بملعقة صغيرة — كل رشفة تعطي لمحة خافتة عن الطعم، ولإدراك النكهة الكاملة عليك أن تغرف مرارًا وتكرارًا. وهكذا هنا: تتدفق البيانات وتتضخم، رغم أن الحمل الدلالي فيها ضئيل.
يشبه نظام الطاقة الحي كائنًا حيًا: خطوط نقل الكهرباء هي الأوعية الدموية، والتيار هو الدم. أما البيانات فهي النبضات العصبية التي كانت تُفقد سابقًا. تقوم mAIEnergy بتوصيل هذه «الأعصاب» بـ«دماغ» موحد. يضم مستودع البيانات هذا صور الأقمار الصناعية، وقراءات عدادات الكهرباء، والمقالات، وتقارير الطقس. من بين 25 مليون سجل، توجد قراءات تمتد لنحو نصف قرن، بمعدل قراءة لكل دقيقة.
سماء أشعة غاما التي صوّرها تلسكوب فيرمي هي سيمفونية مهيبة من آلاف المصادر. فيها النبضات المنتظمة لـالنجوم النابضة، والأوتار القوية لـأنوية المجرات النشطة، لكن الأكثر هي أجرام مجهولة الهوية يبقى لحنها لغزًا.
تخيل: تعزف أوركسترا سيمفونية، لكن الميكروفون لا يلتقط سوى طنين مدمج - tutti، حيث اختلطت أصوات الكمان الأجهر والنايات والصنوج. مهمة مشابهة واجهها الفيزيائيون لعقود، محدقين في حقول الكثافة أو درجة الحرارة أو الحث المغناطيسي.
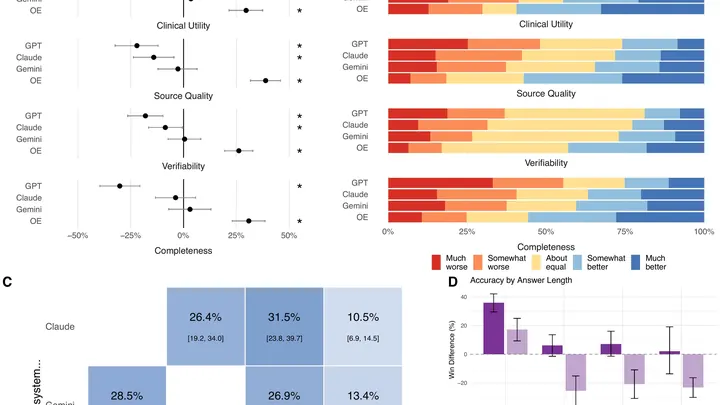
كل أسبوع، يطرح الأطباء ملايين الأسئلة على مساعدي الذكاء الاصطناعي بجانب سرير المريض. لكن عادةً ما تُختبر هذه الأدوات على مسائل امتحانية، وليس على ما يُسأل في العيادة الحقيقية. قررت مجموعة من الباحثين تصحيح هذا الأمر.
جمعوا 620 سؤالًا حقيقيًا من أطباء في 30 تخصصًا — من أمراض القلب إلى كشف سرطان الدماغ. طُرحت هذه الأسئلة على منصة OpenEvidence.
يتصفح الطبيب سجل المريض ويرى سطرًا: «الدواء يقلل الخطر». ولكن إلى أي مدى يمكن تصديق ذلك؟ هل يستند الادعاء إلى حالات قليلة من الممارسة العملية أم إلى عشرات الآلاف من المرضى في دراسة عمياء؟ يعتمد العلاج على الإجابة. اليوم، كثيرًا ما يكتب هذه النصوص ليس البشر، بل النماذج اللغوية الكبيرة — تلك التي تساعد في البحث عن المعلومات وإعداد الملخصات.
لقرون، ظل الفلكيون يتأملون سماء الليل، ملتقطين أدق التغيرات في ضياء النجوم. هذه السلاسل غير المنتظمة – منحنيات الضوء – أشبه بالمدرج الموسيقي: كل نجم يعزف لحنه الفريد. لكن اليوم، تحولت تدفقات البيانات من التلسكوبات كمسح فيرا روبين (LSST) إلى نشاز يصم الآذان – مليارات «التسجيلات» كل ليلة.
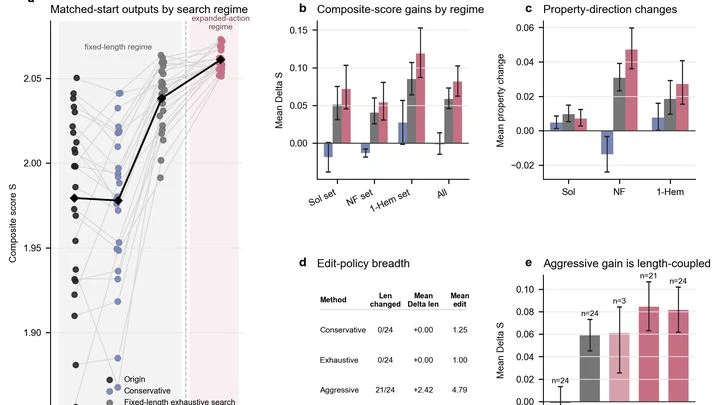
مهندس يضبط هوائيًا: يشدّ جزءًا — يتردد التردد، يغيّر الزاوية — ينخفض الكسب. هكذا تقريبًا يُدار تطوير الببتيدات العلاجية (سلاسل بروتينية قصيرة). الذوبانية، والقدرة على عدم تدمير كريات الدم الحمراء، ومقاومة التصاق الفضلات البروتينية — هذه الخصائص الثلاث متشابكة، ومحاولة تحسين واحدة غالبًا ما تكسر الأخرى.
النظام الجديد Pepti-Agent يعمل بشكل مختلف.
تحكي لصديقك قصة، فيبدو دماغه وكأنه يضبط على موجتك — تنشط نفس المناطق في إيقاع كلماتك. سجّل العلماء هذا "التزامن العصبي" باستخدام تخطيط الدماغ المغناطيسي (جهاز يلتقط المجالات المغناطيسية للدماغ) وقرروا اختبار ما إذا كان نموذج اللغة الحاسوبي قادرًا على تكرار هذه الرقصة من المعاني.
يرسل المختبر إلى الروبوت قائمة بألف جزيء مرشح لدواء جديد. الروبوت المتنبئ، الذي تدرّب على بيانات قديمة، يصدر لكل جزيء تقييمًا "مناسب – غير مناسب". لكن عندما تأتي القائمة من مجال غير مألوف – كفيروس مختلف أو ورم نادر – يبدأ الروبوت في الاختلاط. تظل ثقته عالية بينما تنخفض الإصابات الحقيقية إلى الصفر.
مصوّر فوتوغرافي يلتقط غابة ليلية محاولًا الإمساك باليراعات في كادر. الومضات نادرة وخافتة، وحوله ضجيج الريح وأضواء بعيدة. هكذا تقريبًا يعمل الكاشف الضخم Hyper-Kamiokande في اليابان: فهو يلتقط النيوترينوات — جسيمات شبه غير ملموسة — عبر ومضات ضوئية صغيرة في 260 ألف طن من الماء.
نردان دائمًا ما يسقطان بنفس الطريقة، مهما كانت المسافة بينهما. في الفيزياء الكمومية، يُسمى هذا السلوك تشابكًا، وهو المورد الأساسي لحواسيب المستقبل والاتصالات الآمنة. لكن المشكلة أن ليس كل تشابك يسهل رصده. بعض أشكاله — مثل حبر غير مرئي: الارتباط موجود، لكن الفحص القياسي (ويُسمى «معيار الإيجابية تحت النقل الجزئي») يُظهر صفحة بيضاء.
تتذوق طبقًا في مطعم دون أن ترى القائمة. تسأل النادل أسئلة — هل هو مالح أكثر من اللازم؟ ما البهارات المستخدمة؟ — وتحاول من إجاباته أن تخمن أي طاهٍ أعدّه. هكذا تقريبًا يدرس الباحثون الشبكات العصبية الحديثة عندما يكون الوصول إليها فقط عبر API (واجهة برمجة تطبيقات، حيث يمكنك طرح سؤال والحصول على إجابة، لكن لا يمكنك النظر إلى الداخل).
لكن ليست كل الأسئلة مفيدة بنفس القدر.