عينان خير من عين: كيف تتعلم الشبكة العصبية رؤية الورم سريع
يتأمل الطبيب صورة الدماغ: في مكان ما بين تشابك الأنسجة يختبئ الورم. نظرة واحدة تلتقط البقع الصغيرة والحدود، وأخرى ترى الشكل العام والموقع. الإنسان يجمع بين الاثنتين، لكن على مئات الصور يصبح ذلك مرهقًا. البرنامج الجديد يفعل الشيء نفسه تلقائيًا.
جزء منه يعمل كعدسة مكبرة: ينزلق على الصورة ويجمع التفاصيل الدقيقة — الملمس، الحواف، التغيرات الموضعية. والثاني ينظر بنظرة واسعة، كما لو كان من الأعلى، ويربط بين المناطق البعيدة: أين يقع الورم بالنسبة للبطينات، وكيف يندرج في الصورة العامة. سابقًا كانت تُدمج هاتان النظرات بشكل تقريبي — بمجرد خلط النتائج. الآن أُضيفت «غرفة تفاوض»: وحدة خاصة تقرر مقدار ما يُؤخذ من كل نظرة لصورة معينة ولمنطقة معينة.
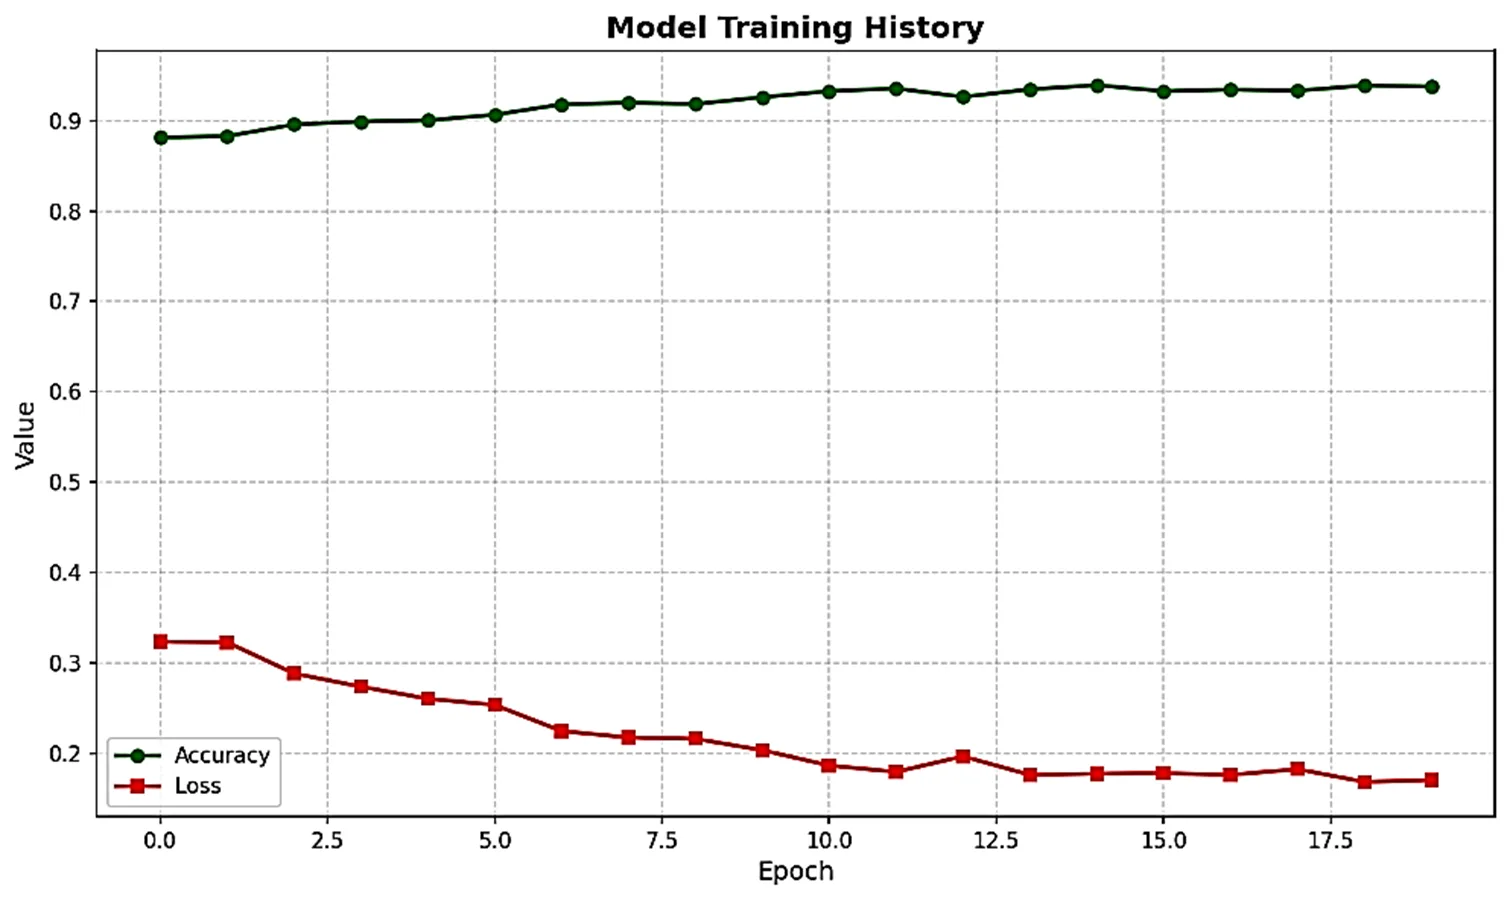
دُرّب النموذج على مجموعة صور مع أورام وبدونها. تعرف على الورم بشكل صحيح في 97.6% من الحالات — وهي نسبة أعلى من كل جزء على حدة ومن الطرق السابقة للدمج. الدقة والاستدعاء والمؤشر العام للجودة — كلها ارتفعت. هذا يعني أن الموازنة المرنة بين النظرةين تساعد على رؤية المرض بوضوح أكبر.
هذا النهج قد يفيد ليس فقط أورام الدماغ: أي صور طبية تكون فيها التفاصيل الدقيقة والصورة العامة مهمة معًا ستستفيد من «عينين مع قائد أوركسترا».
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2604.23137
Early detection and classifying brain tumors using Magnetic Resonance Imaging (MRI) images is highly important but difficult to extract in medical images. Convolutional Neural Networks (CNNs) are good at capturing both local texture and spatial information whereas Vision Transformers (ViTs) are good at capturing long-range global dependencies. We propose a new hybrid architecture that combines a SqueezeNet-style CNN branch with a MobileViT-style global transformer branch, through an Adaptive Attention Gate mechanism, in this paper. The gate learns dynamically per-sample, per-feature weights to weight the contribution of each branch, allowing context-sensitive merging of local and global representations. The proposed model has a test accuracy of 97.60, a precision of 97.30, a recall of 97.50, an F1-score of 97.40, and a macro-average area under the curve (AUC) of 0.9946 with a trained and evaluated on the Brain Tumor MRI Dataset (Kaggle). These scores are higher than single CNN and ViT baselines, and current competitive fusion methods, showing that dynamic feature weighting is an effective way to classify medical images.
مؤشر AUC البالغ 0.9946 يعني أنه إذا أخذنا صورة عشوائية بها ورم وصورة عشوائية بدونه، فسيضع النموذج دائمًا تقريبًا درجة أعلى لـ«الشبه بالورم» للأولى.