تعتمد الرؤية الحاسوبية على الشبكات العصبية الالتفافية (Convolutional Neural Networks, CNN). تعكس بنيتها تركيب القشرة البصرية: الخلايا البسيطة تستجيب للخطوط بزاوية معينة، والخلايا المعقدة تستجيب لتوليفاتها. تقوم الطبقة الالتفافية بمسح الصورة بنافذة صغيرة، وتضربها بالمرشح (filter) لتنتج خرائط المعالم (feature maps). وتقوم عدة طبقات من هذا القبيل بتجميع تمثيلات متزايدة التجريد: من الحواف والنسيج إلى أجزاء الأشياء والوجوه الكاملة. تستخدم الأنظمة الحديثة أيضًا آلية الانتباه (attention mechanism) والمحولات (transformers)، حيث تعالج الصورة كسلسلة من البقع (patches).
التاريخ
وتعتبر نقطة الانطلاق عمل هوبل وويزل (1959) حول بنية القشرة البصرية، الذي ألهم النماذج الهرمية. في عام 1963، طبق لاري روبرتس برنامج «Blocks World» الذي يفسر صور المكعبات. وفي السبعينيات، تطورت الأساليب الهندسية بنشاط. وفي التسعينيات، ظهرت أول كواشف فعالة للحواف. وقد اقترح يان ليكون الشبكات الالتفافية عام 1989 واستخدمها للتعرف على الأرقام. وجاء التحول الحقيقي عام 2012، عندما قدم أليكس كريجفسكي وزملاؤه شبكة AlexNet التي استخدمت وحدات معالجة الرسوميات (GPU) – فارتفعت الدقة على ImageNet من حوالي 74% إلى حوالي 84%. وفي السنوات التالية، تعمقت البنى: VGG، وResNet (2015) التي عالجت مشكلة تلاشي التدرجات عبر الوصلات التجاوزية. ومنذ عام 2020، نقلت محولات الرؤية (Dosovitskiy وآخرون) آلية الانتباه الذاتي إلى الصور، وتعلمت نماذج مثل DALL·E 2 وStable Diffusion توليد صور جديدة من وصف نصي.
كيف يعمل
اللبنة الأساسية هي الالتفاف: نواة بحجم k×k تُضرب عنصرًا بعنصر مع جزء من الصورة، ويُجمع الناتج. تقوم طبقة التجميع (pooling) بتقليل الدقة وإبراز الأهم. وتستقبل الطبقات المترابطة بالكامل متجه المعالم النهائي وتصدر التنبؤ. ويتم التدريب بطريقة الانحدار التدريجي (gradient descent) مع الانتشار العكسي للخطأ. في الأنظمة الحديثة، غالبًا ما يُدرَّب نموذج كبير مسبقًا على مجموعات بيانات ضخمة (ImageNet-21k) ثم يُعاد تدريبه على مهمة محددة (transfer learning). ولتوليد الصور، تُستخدم المشفرات التلقائية المتغيرة (VAE)، والشبكات التوليدية التنافسية (GAN)، ومؤخرًا النماذج الاحتمالية الانتشارية (diffusion models) التي تزيل التشويش تدريجيًا من حقل عشوائي أولي حتى الحصول على صورة واضحة.
في التطبيق
تتعرف السيارة على إشارات المرور والمشاة في الوقت الفعلي لتفعيل الفرامل أو تنبيه السائق في الوقت المناسب.
حقيقة طريفة
يستطيع تطبيق «ترجمة جوجل» ترجمة النص على صورة قائمة الطعام في الوقت الفعلي: توجه الكاميرا إلى النص بلغة أجنبية، فيظهر على الشاشة بالعربية – كل ذلك بفضل التعرف على الصورة وفهمها.
في ثمانينيات القرن العشرين، وضعت مسابقة DARPA للتعرف على الكلام حدًا للجدل بين الأساليب الإحصائية والقواعد المكتوبة يدويًا، ووضعت معيارًا موحدًا للمجال بأكمله. أما بالنسبة للواجهات العصبية الكلامية التي تترجم النشاط الدماغي إلى كلمات، فلم يكن هناك حتى الآن مثل هذا المعيار المشترك: كل نظام يستخدم مفرداته الخاصة، وطريقته في التسجيل، ونوع الكلام.
ينظر أخصائي الأشعة إلى صورة البطن ولا يرى مجرد أعضاء، بل يرى ترتيبها المكاني: أي كلية أكبر، وأين يقع الورم بالنسبة للوعاء الدموي. هذا يشبه قراءة خريطة، حيث لا يكفي أن تعرف أين تقع المدينة عادةً، بل يجب أن تكون قادرًا على قياس المسافة بين نقطتين على الأرض. باحثون من IIIT Hyderabad وAIG Hospitals بنوا SPAR-Bench، وهي ثماني مهام تختبر ما إذا كانت نماذج الرؤية الطبية قادرة على هذا النوع من الاستدلال.
من السهل جدًا أن تضيع في قاعة المرايا: كل جدار يعكس الآخر، ويبدو أنك كنت هنا من قبل. بنفس الطريقة تقريبًا يرتبك الدماغ عندما يكون هناك الكثير من الأماكن المتشابهة حوله. العصبونات — الخلايا المسؤولة عن خريطة الفضاء — قد تُصدر إشارة متطابقة لزاويتين مختلفتين من الغرفة. تُسمى هذه الظاهرة بالغموض المكاني: يتلقى الدماغ معلومات غامضة حول موقع الجسم بالضبط.
تخيل أنك تبحث عن اليراعات في غابة مظلمة. بدلاً من تصوير الغابة بأكملها كل ثانية ثم تحليل الصور، تحمل معك جهازًا صغيرًا يلاحظ الومضات بنفسه ويقتطع من الإطار دائرة صغيرة حول كل واحدة. الباقي — السواد — لا يُحفظ. هكذا يعمل المستشعر الجديد للكاميرات العلمية.
الكاميرات عالية السرعة التقليدية تصور مليون إطار في الثانية، وكل إطار يمثل كمية هائلة من البيانات. من المستحيل نقل كل ذلك عبر الأسلاك: قناة النقل تختنق.
تنتقل البيانات عبر الألياف البصرية بسرعة الضوء، لكن الطريق ليس مثاليًا: تتشوش الإشارة مثل الصوت في ممر طويل. كلما زادت السرعة والمسافة، زاد التشوه. عادةً ما تُصحح هذه التشوهات إلكترونيًا، لكن الإلكترونيات لا تستطيع مواكبة الضوء.
جمع العلماء حاسوبًا ضوئيًا من عدة ليزرات مترابطة في سلسلة. كل ليزر يعمل كعقدة في شبكة، تصحح الإشارة قليلًا.
شعاع ضوء يدخل كوفيتة زجاجية تحتوي بخار سيزيوم، فيغيّر الحالة الداخلية للذرات — هكذا تُكتب المعلومات. بعد لحظة، يقرأ شعاع آخر هذه المعلومات من خلال كيفية امتصاص الذرات للضوء. هذا ليس قرصًا صلبًا، بل أقرب إلى دفتر ملاحظات يقلب صفحاته بنفسه.
تُنشأ ثماني «صفحات» من هذا القبيل بواسطة مُنحرف صوتي-ضوئي — جهاز يحرف الشعاع باستخدام الصوت. تحمل كل صفحة حتى 3.8 بت.
كاميرا الهاتف الذكي تلتقط الضوء بمستشعرات صغيرة، لكنها بحد ذاتها لا تميّز الألوان. لذلك توضع أمامها مرشحات ملونة: أحمر، أخضر، أزرق — مثل الزجاج الملون في النوافذ. كل مستشعر يرى لونه فقط، ثم يجمع البرنامج هذه القطع لتكوين صورة كاملة. لكن هناك طريقة أخرى: بدلاً من المرشحات، يمكن وضع بنية نانوية تفرّق الضوء بنفسها حسب الألوان، مثل الموشور الذي يحلل الشعاع الأبيض إلى قوس قزح.
الصورة ذات الجرعة المنخفضة من الأشعة السينية تشبه النظر عبر زجاج مغشى: يمكن تخمين المعالم، لكن التفاصيل تغرق في ضباب كثيف. يحتاج الأطباء إلى مثل هذه اللقطات أثناء العلاج الإشعاعي — لتوجيه الحزمة بدقة نحو الورم وتجنب إصابة الأنسجة السليمة. ومع ذلك، فإن توفير الإشعاع يؤدي إلى تشويش وخطوط وبقع تعيق رؤية المهم.
التنبؤ بمردود تفاعل كيميائي هو محاولة لتقدير المحصول الزراعي دون معرفة سوى تكوين التربة. لفترة طويلة، اعتمد الكيميائيون على أعمدة طويلة من الأرقام، تُسمى الواصفات الكمومية (quantum descriptors)، التي تصف طاقة الإلكترونات لكنها تتجاهل شكل الجزيء. ومع ذلك، قد يتصرف مركبان بخصائص رقمية شبه متطابقة بشكل مختلف لمجرد أن أحدهما ضخم كباقة زهور والآخر مسطح كورقة.
التنبؤ بمردود تفاعل كيميائي هو محاولة لتقدير المحصول الزراعي دون معرفة سوى تكوين التربة. لفترة طويلة، اعتمد الكيميائيون على أعمدة طويلة من الأرقام، تُسمى الواصفات الكمومية (quantum descriptors)، التي تصف طاقة الإلكترونات لكنها تتجاهل شكل الجزيء. ومع ذلك، قد يتصرف مركبان بخصائص رقمية شبه متطابقة بشكل مختلف لمجرد أن أحدهما ضخم كباقة زهور والآخر مسطح كورقة.
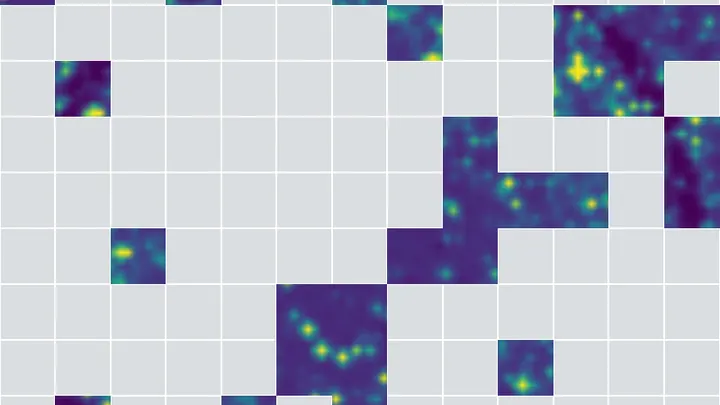
في المجرة الحلزونية الألعاب النارية — 6410 مشتلاً نجمياً. هذا هو عدد المناطق التي تولد فيها الآن نجوم ضخمة، كشفت عنها الخوارزمية في صور قديمة فوق بنفسجية من هابل. ليست مجرد بقع على الصورة — لكل منها حدود واضحة، كدولة على خريطة كنتورية.
كل صباح، تُوجّه عشرات التلسكوبات نحو الشمس. تلتقط كاميراتها شريطًا ضيقًا من الضوء الأحمر — خط Hα، الذي اكتشفه Johann Jakob Balmer. تظهر في الصور خيوط داكنة، منحنية بأشكال بديعة. إنها أشبه بغرز نسيج ضخم يخيط الهالة المتوهجة. هذه هي الخيوط الشمسية. أقواس كثيفة من البلازما، تحوم فوق دروز مغناطيسية خفية.
زرعة العين لا تنقل إلى الدماغ صورة فوتوغرافية، بل نقاطًا ضوئية متفرقة نادرة تُعرف بالفوسفينات. لتمييز كوب أو مفاتيح في هذا الرذاذ، يضطر الشخص إلى تحريك رأسه مثل مصباح يدوي في الظلام، وجمع ملامح الجسم شيئًا فشيئًا. هذه عملية بطيئة تشبه تجميع أحجية أُلقيت معظم قطعها.
حاولت مجموعة من الباحثين تلميح الدماغ عندما يكون مركزًا حقًا في البحث.
عند تجميع أحجية الكون، اعتاد علماء الفلك على أن كل قطعة جديدة يجب أن تتناسب تمامًا مع الصورة المكتملة. لكن في بعض الأحيان تظهر قطع تبدو وكأنها مأخوذة من لغز آخر. عشرون ألف نواة مجرة نشطة — وأحد عشر بالمئة منها ترفضها الشبكة العصبية بثقة باعتبارها غريبة.
في كل مرة يستعد فيها طفل مصاب بالشلل الدماغي لتحريك ساقه، يحدث في دماغه وميض كهربائي مميز — انزياح بطيء في الجهد الكهربائي. يسميه العلماء "الجهد المرتبط بالحركة" (movement-related potential). يمكن لواجهة الدماغ-الحاسوب (نظام يقرأ النوايا من إشارات الدماغ) أن تلتقط هذا الوميض وتحوّله إلى أمر لجهاز التمرين. لكن هناك عقبة: قبل كل جلسة تدريب، يجب ضبط النظام لفترة طويلة ليتكيف مع الطفل المحدد.
تلتقط كاميرات السيارة ذاتية القيادة الضوءَ كما تفعل التلسكوبات الموجّهة نحو مجرّة بعيدة. كل لقطة هي رصد مجتزأ؛ ويجب أن تتجمع معًا لتشكل خريطة المسار.
الحاسوب، مثل عالم فلك، لا يلصق اللقطات، بل يولّد عدة مناظر علوية محتملة ويقارنها بالبيانات الفعلية. يُختار أفضل خيار وفقًا لـ الإنتروبيا — مقياس عدم اليقين الذي ينخفض عندما يتطابق الرسم مع الواقع.
الرادار العادي لا يرى الدرون إلا كنقطة على الشاشة — علامة بلا ملامح في الفضاء. أما الطريقة الجديدة فتحوّل صدى الراديو إلى منحوتة مجسّمة: الإشارة المنعكسة ترسم شكل الجسم وميله وطبيعة حركته. المبدأ يشبه المطياف — وهو جهاز يحلّل الضوء إلى طيف مثل قوس قزح — لكن هنا لا يُحلَّل الضوء المرئي بل إشارة الراديو المنعكسة.
في المشهد ثلاثي الأبعاد، كل نقطة تشبه قطعة حلوى يتغير لونها تبعاً لزاوية الرؤية. ولوصف تلاعب الألوان هذا، يُخزّن لكل نقطة عشرات الأعداد — دالة رياضية خاصة ابتكرها جوزيف فورييه. وتمتلئ الذاكرة بسرعة.
الطريقة الجديدة تُجمّع قطع الحلوى ذات السلوك اللوني المتشابه: بدلاً من تذكّر الظل الدقيق لكل منها، يُحفظ اللون المتوسط مع تصحيح بسيط.
دماغ المتأمل هو أوركسترا، والانتباه هو قائدها. عندما تركز على التنفس، تعزف جميع الآلات بتناغم. لكن فجأة، تعزف آلة التشيلو نغمة نشازًا — هذا هو شرود الذهن. القائد المتمرس لا يصاب بالذعر: بل يلتقط التنافر فورًا ويعيد الأوركسترا بلطف إلى اللحن الرئيسي — التنفس.
بنى العلماء نموذجًا حاسوبيًا لهذه العملية.
الذكاء الاصطناعي التقليدي ينظر إلى الصور الطبية كما لو كانت أحجية من قطع غير مألوفة — فهو يعتبر أي صورتين غير متطابقتين مختلفتين تمامًا. هذا أشبه بمحاولة التمييز بين توأمين دون معرفة قرابتهما. أما في الطب، فالمرضى المصابون بنفس المرض يبدون متشابهين تقريبًا في صور الرنين المغناطيسي، فيخطئ الخوارزم ويخلط بين "الأقارب".
تعمل الكاميرا أحادية البكسل مثل رسام يرسم لوحته عبر استنسل مليء بالثقوب. في كل إطار، يصل إلى المستشعر الوحيد جزءٌ فقط من الضوء، معدَّلًا بواسطة قناع — وهو مُعدِّل ضوء مكاني (spatial light modulator) — ثم يعيد الكمبيوتر بناء الصورة الكاملة بتجميع هذا الفسيفساء عبر خوارزميات حسابية. في السابق، كان تسلسل الأقنعة ثابتًا: وكأن الرسام يستخدم دائمًا نفس الاستنسل دون أن يتأمل المشهد.
تُوصف العديد من العمليات الطبيعية بمعادلات تفاضلية، لكن العلماء غالبًا لا يملكون سوى بيانات مجزأة — أشبه بقطع خريطة ممزقة. تعمل الطريقة الحسابية الجديدة كخرّيط يعيد بناء خريطة كاملة للتضاريس من معالم قليلة.
يشبه برنامج التتبع العادي ملاحاً يوجه سفينة بالاعتماد على النجوم. ولكن ما إن تتلبد السماء بالغيوم حتى تبدأ الإحداثيات بالانحراف، وتزداد في البيانات الإنتروبيا (مقياس اللايقين). يحصل الخوارزم الجديد على "مساعد طيار" — وحدة تراقب مدى ثقة الملاح الرئيسي.
وعندما تبدأ الحسابات بالانحراف عن الواقع، يُطلق إشارة: "لقد تغيرت مواقع النجوم، حان وقت تحديث الخريطة".
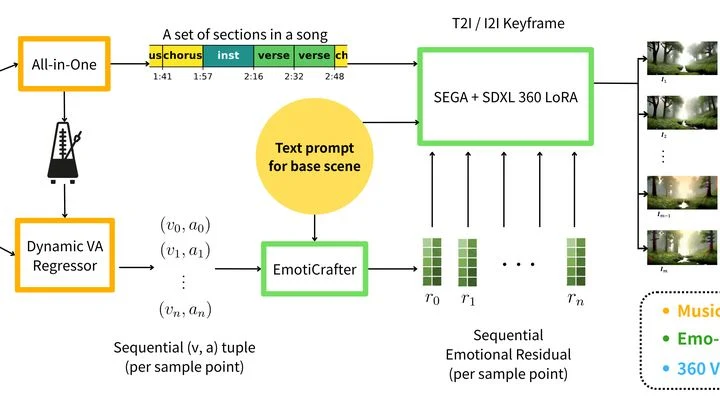
قائد الأوركسترا لا يحمل عصا، بل فرشاة، وكل إيماءة تولّد لونًا وشكلًا. هذا التشبيه يساعد على فهم التقنية الجديدة: فهي تحوّل الديناميكية العاطفية للأغنية إلى فيديو بانورامي يحيط بالمستمع — تمامًا كما يحوّل الفنان فكرته إلى لوحة مجسمة.
أولًا، يقوم الخوارزمية، مثل التحليل الطيفي — وهو أسلوب لتحليل الضوء إلى أطوال موجية — بتفكيك المقطع إلى مكونات عاطفية.
عادةً ما تظهر بيانات عمل الجينات كسلسلة طويلة من الأرقام، تشبه شريطًا طيفيًا (الطيف) دون روابط واضحة. في نموذج scVision، تُحول هذه الأرقام إلى صورة ذات معنى — ليست مجرد قائمة بالمكونات، بل صورة مكتملة. تُرتب الجينات على 'خريطة تنظيمية' مشتركة: الجينات المتعاونة تكون متجاورة، ونشاطها يُمثل بالسطوع، مثل قياس شدة الإضاءة (القياس الضوئي).
النهج المعياري الحالي لتعلم الذكاء الاصطناعي يشبه طفلًا محبوسًا في مكتبة: يتذكر ملايين الكتب، لكنه لا يعلم أن النار تحرق، وأن السقوط يسبب الألم. أدمغتنا، المبنية من الكربون ومواد بسيطة أخرى، تعمل بطريقة مختلفة: أولاً يستكشف الجسد العالم من خلال الحركات واللمسات والأخطاء، وعندها فقط تكتسب الكلمات معناها.
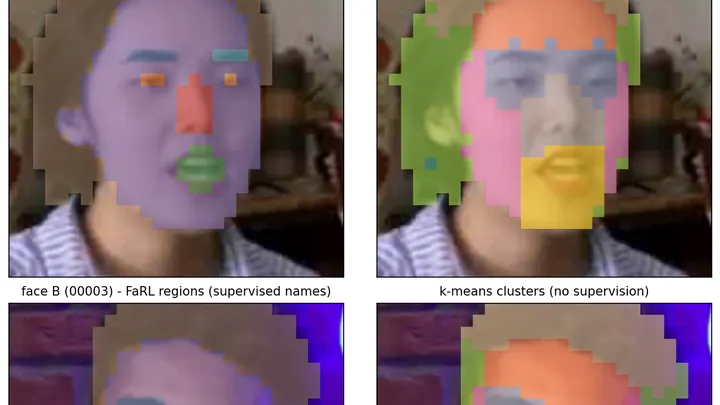
درّبت على صور عادية دون أي تسميات، أظهر نموذج الرؤية الحاسوبية DINOv3 قدرة غير متوقعة تشبه عمل المطياف: فقد تعلّم تلقائيًا تمييز مناطق منفصلة في الوجوه — العينين والأنف والفم — وكأنه يفكك الصورة إلى مكوناتها الطيفية.
الإنسان في القارب يوجّه بشكل حدسي بإزاحة وزن جسمه. نفس المبدأ الفيزيائي تستخدمه المركبة المائية بدون طيار: المناورة تنفذها كتلة متحركة تنتقل داخل الهيكل. حركتها تتحكم بها شبكة عصبية — خوارزمية تدرّبت على توقع فوضى الأمواج وهبّات الرياح.
لا تُنتج أجهزة التصوير المقطعي صورًا جاهزة مباشرة. مبدأ عملها هو جمع العديد من "الظلال"، أي إسقاطات البنية الداخلية، من زوايا مختلفة أو باستخدام إشارات فيزيائية متنوعة. ثم تقوم الخوارزميات الرياضية بإعادة بناء صورة ثلاثية الأبعاد من هذه الإسقاطات.
الطفل، وهو يستكشف شقة غير مألوفة، يزحف من شيء إلى آخر ويتذكر ما يراه من كل زاوية. هكذا يبني الدماغ خريطة ذهنية — نموذجاً داخلياً للفضاء. خوارزمية gradCSCG تعمل بالمبدأ نفسه: تستقبل بثاً من الكاميرا وترسم مخطط المكان بنفسها، معتمدة فقط على تغير الصور. في السابق، كانت الآلات تحتاج إلى تلميحات — مثل كائنات محددة مسبقاً في الصور. أما الطريقة الجديدة فتستغني عنها.
في المطبخ بمواقد الغاز، كل شعلة تسخن بطريقتها. إذا أعاد الطاهي ترتيب القدور، قد يحترق الطعام. هكذا في الشبكة اللاسلكية: الهوائيات-الشعلات والمستخدمون-القدور يتطلّبون ترتيبًا دقيقًا. الشبكات العصبية العادية لا تميّز المواقع، معتبرةً كل الشعلات متشابهة. لذلك يصعب عليها تقدير جودة الاتصال أو ضبط الإرسال.
تخيّل طبّاخًا يتعلّم الطهي من صور مرسومة فقط — شبه مؤكد أنه سيفسد كل طبق. فخّ مشابه يتربّص بـ الرؤية الحاسوبية: تدريب النماذج يتطلب آلاف الصور الموسومة، لكن جمعها ووضع العلامات عليها يدويًا مكلف ومضجر. الصور الاصطناعية المولّدة بالخوارزميات تحل المشكلة، لكن بشرط أن تبدو حقيقية. هنا تظهر أداة GraNatPy التي تقيّم مصداقية الصور الاصطناعية.
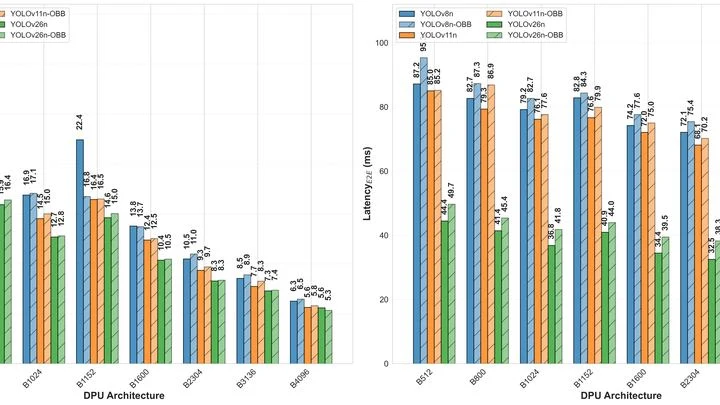
أنظمة الرؤية الآلية الحديثة تكتسب استقلالية متزايدة: تمكن المهندسون من تنفيذ خوارزمية التعرف على الأنماط مباشرة على شريحة مصغرة، مما يلغي حاجة الكاميرا إلى إرسال البيانات إلى حاسوب ضخم. يشبه مبدأ العمل استراتيجية تلسكوب يبحث عن كواكب خارجية: بدلاً من المسح السلبي لكامل مجال الرؤية، تركز الكاميرا بشكل انتقائي على الأجسام المهمة — الأهداف المتحركة، والحدود، والوجوه.
عوّامة في خزان ماء: متحكم مثالي، تستشعر مستوى الماء فتعيد النظام فوراً إلى التوازن دون النظر إلى الماضي. طبق المهندسون هذا المبدأ على الشبكات العصبية. أعادوا كتابة البنية المعيارية بحيث تحل معادلة توازن واحدة بدلاً من سلسلة متتالية من الحسابات. تنبثق إشارة التحكم فوراً — مثل وضعية العوّامة.
بناء رقاقة ضوئية يشبه لعبة تتطلب تمرير شعاع ضوئي عبر متاهة من المرايا الصغيرة ومقسمات الأشعة. كل عنصر من هذه العناصر يعمل مثل سكة تبديل في شبكة قطارات: فهو إما يمرر الضوء مباشرة أو يوجهه إلى مسار مجاور. الهدف هو الحصول على نمط ضوئي محدد بدقة عند المخرج، باستخدام أقل عدد ممكن من «المفاتيح».
عادةً، يقضي المهندسون سنوات في البحث عن أقصر مسار لكل مهمة. لكن هنا، تم تعليم البرنامج القيام بذلك بنفسه.
المجهر الإلكتروني هو أرغن ضخم: بدلاً من الأنابيب — عدسات كهرمغناطيسية، وبدلاً من الهواء — تيار من الإلكترونات المسرّعة. في السابق، كان يرسم فقط لوحات جدارية صامتة عن العالم الذري، محملاً العلماء بفك تشفير مرهق. أما الآن فقد دخل القائد إلى القاعة — التعلّم العميق، محوّلاً نشاز البكسلات إلى سيمفونية من البنى، حيث كل ذرة نغمة.
تأمل في سماء الليل — ما تراه ليس مجرد تناثر أضواء، بل مخطوطة متعددة الطبقات. تحت حبر النجوم والمجرات اللامع، يظهر نص باهت يكاد يُمحى. إنها رسالة المادة المظلمة، منقوشة بالعدساتية الجاذبية: كتل خفية تشوّه ضوء المجرات البعيدة، تاركةً علامات مائية خافتة على رقّ الكون.
العدسية التجاذبية الميكروية هي أثر كوني مذهل، تنبأ به أينشتاين وطوّره تسفيكي. جسم ضخم، يمر بيننا وبين نجم بعيد، يحني ضوءه كالعدسة، مُحدِثاً تضخيمات وتشوهات مميزة.
في الكون الفتي، قبل نحو عشرة مليارات سنة، كانت المجرات تشبه حقولاً لا نهائية بعد عاصفة رعدية: في كل مكان، كانت تغلي وتنبت تكتلات عملاقة — بآلاف السنين الضوئية — من تكوّن النجوم، حيث كانت النجوم الفتية تولد بطاقة جامحة. أما اليوم، فقد كادت هذه المناطق أن تنقرض: ففي المجرات القريبة، نادراً ما توجد البؤر المتأججة.