صيد الجينات بكلمة واحدة سريع
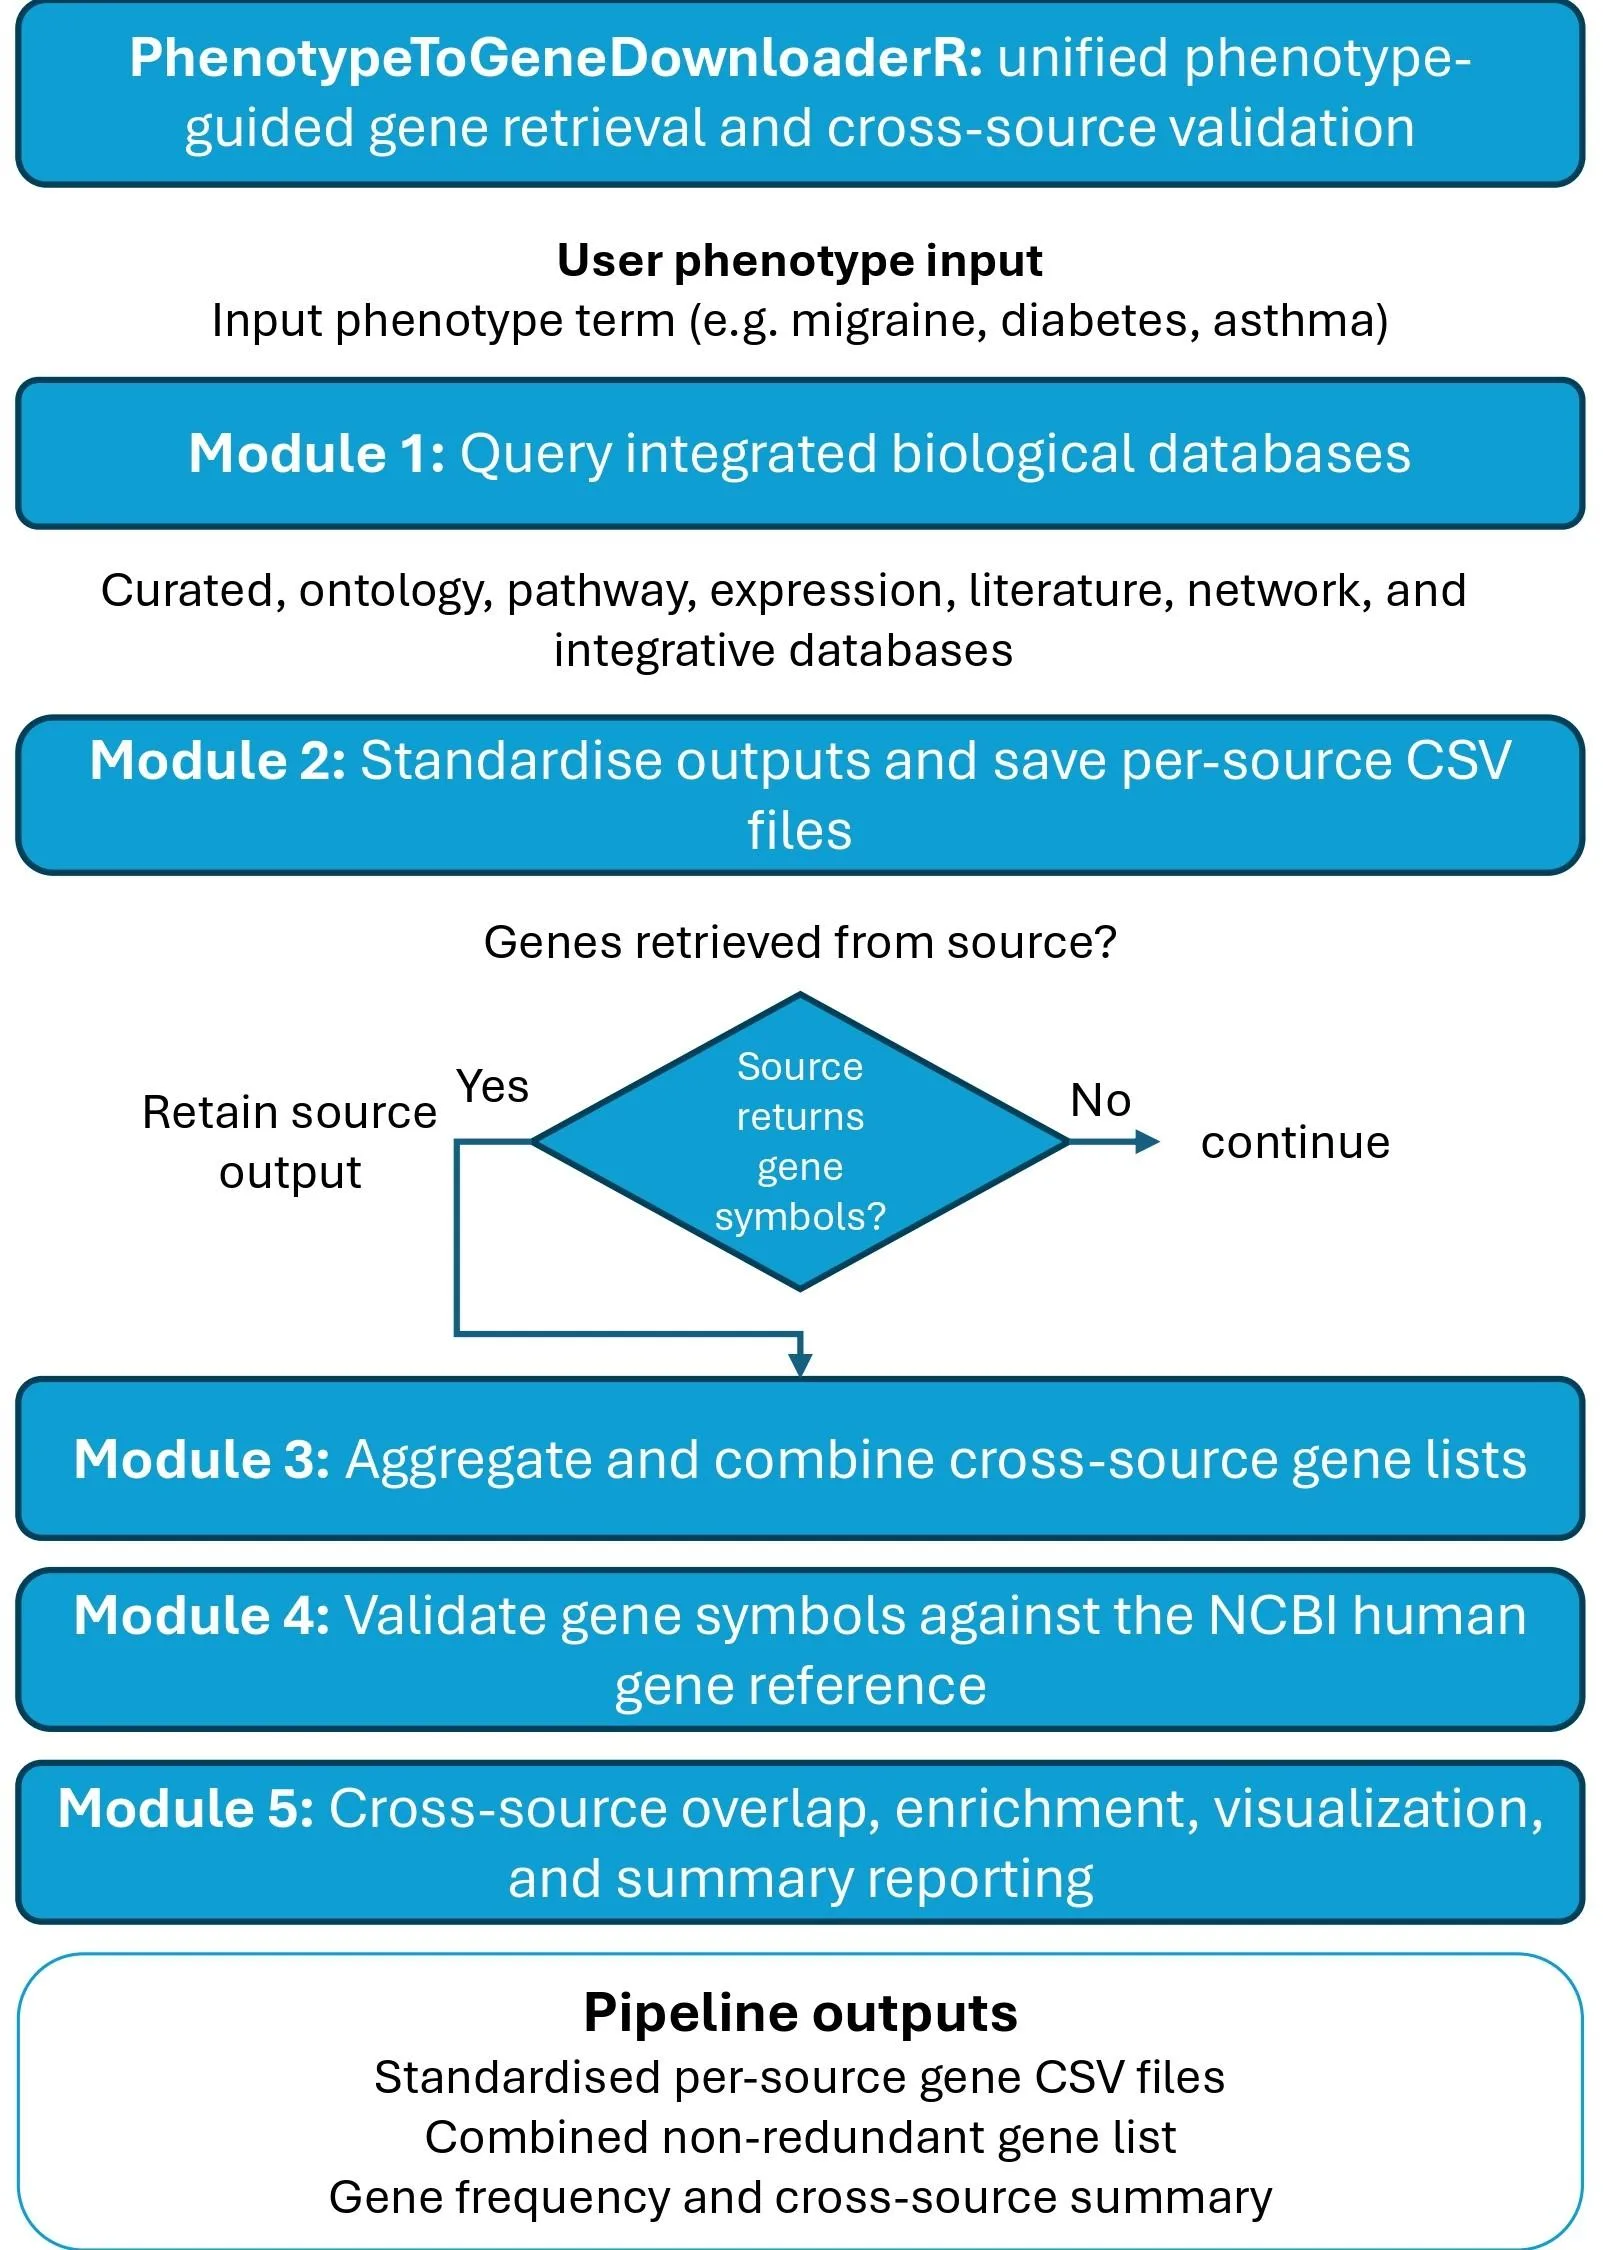
تجميع أحجية مبعثرة قطعها في 13 صندوقًا بأنظمة ترقيم مختلفة — هكذا يبدو البحث عن الجينات المرتبطة بمرض معين. البيانات موجودة، لكنها مخبأة في قواعد بيانات بواجهات وتنسيقات وحتى لغات وصف خاصة بها. البرنامج الجديد PhenotypeToGeneDownloaderR يتولى دور المترجم والفرّاز: تعطيه اسم المرض، فيجول بنفسه على جميع المستودعات، ويستخرج قوائم الجينات، ويوحدها في قاسم مشترك.
القوائم المجمعة غالبًا لا تتطابق مع بعضها — كل قاعدة بيانات ترى المشكلة من زاويتها، وهنا تكمن قوة النهج: بدمجها نحصل على صورة أكثر اكتمالًا. وعند اختبار البرنامج وفق "المعيار الذهبي" المكون من ثلاثة مصادر موثوقة (HPO وClinVar وOMIM)، وجد 1039 من أصل 1056 جينًا معروفًا — أي 98.4%. وهذا يعني أنه لم يتم تفويت أي شيء تقريبًا، والزيادة في حدها الأدنى. هذه الأداة توفر أسابيع من العمل اليدوي وتقلل خطر الخطأ عندما يقوم طبيب أو عالم بنقل الأسماء يدويًا من نظام إلى آخر.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2605.01378
Identifying phenotype-associated genes is a common first step in polygenic risk score construction, enrichment testing, target prioritisation and variant interpretation, but relevant evidence is distributed across heterogeneous databases with different interfaces, formats and evidence models. Here, we present PhenotypeToGeneDownloaderR, a phenotype-guided R/Python pipeline for automated gene retrieval, harmonisation, symbol validation and cross-source summary analysis. Given a phenotype term, the pipeline queries integrated biological databases, standardises per-source outputs, combines gene lists, validates retrieved symbols against the NCBI human gene reference and generates summary tables and visualisations. Across 13 clinically relevant phenotypes and 13 databases, PhenotypeToGeneDownloaderR generated 136,487 raw gene retrievals, with at least one source returning genes for every phenotype. Across all 13 phenotypes, 100,175 of 114,345 combined input symbols were retained after direct or synonym-based validation, corresponding to an 87.6\% validation rate. Cross-source overlap was low, supporting the complementarity of integrated evidence sources. Against an HPO/ClinVar/OMIM-derived gold standard, the pipeline recovered 1,039 of 1,056 known phenotype-associated genes, corresponding to 98.4\% recall. PhenotypeToGeneDownloaderR provides a lightweight, reproducible upstream framework for generating candidate gene sets for downstream prioritisation and interpretation. The pipeline is implemented in R and Python, released under the MIT licence, and available at https://github.com/MuhammadMuneeb007/PhenotypeToGeneDownloaderR.
أسماء الجينات تتغير أحيانًا مثل عناوين الشوارع عند إعادة تسمية المدينة — وبدون التحقق من الدليل المحدث، قد تظل لسنوات تشير إلى "منزل قديم" لم يعد موجودًا على الخرائط الرسمية.