Le sucre, une semaine à l'avance express
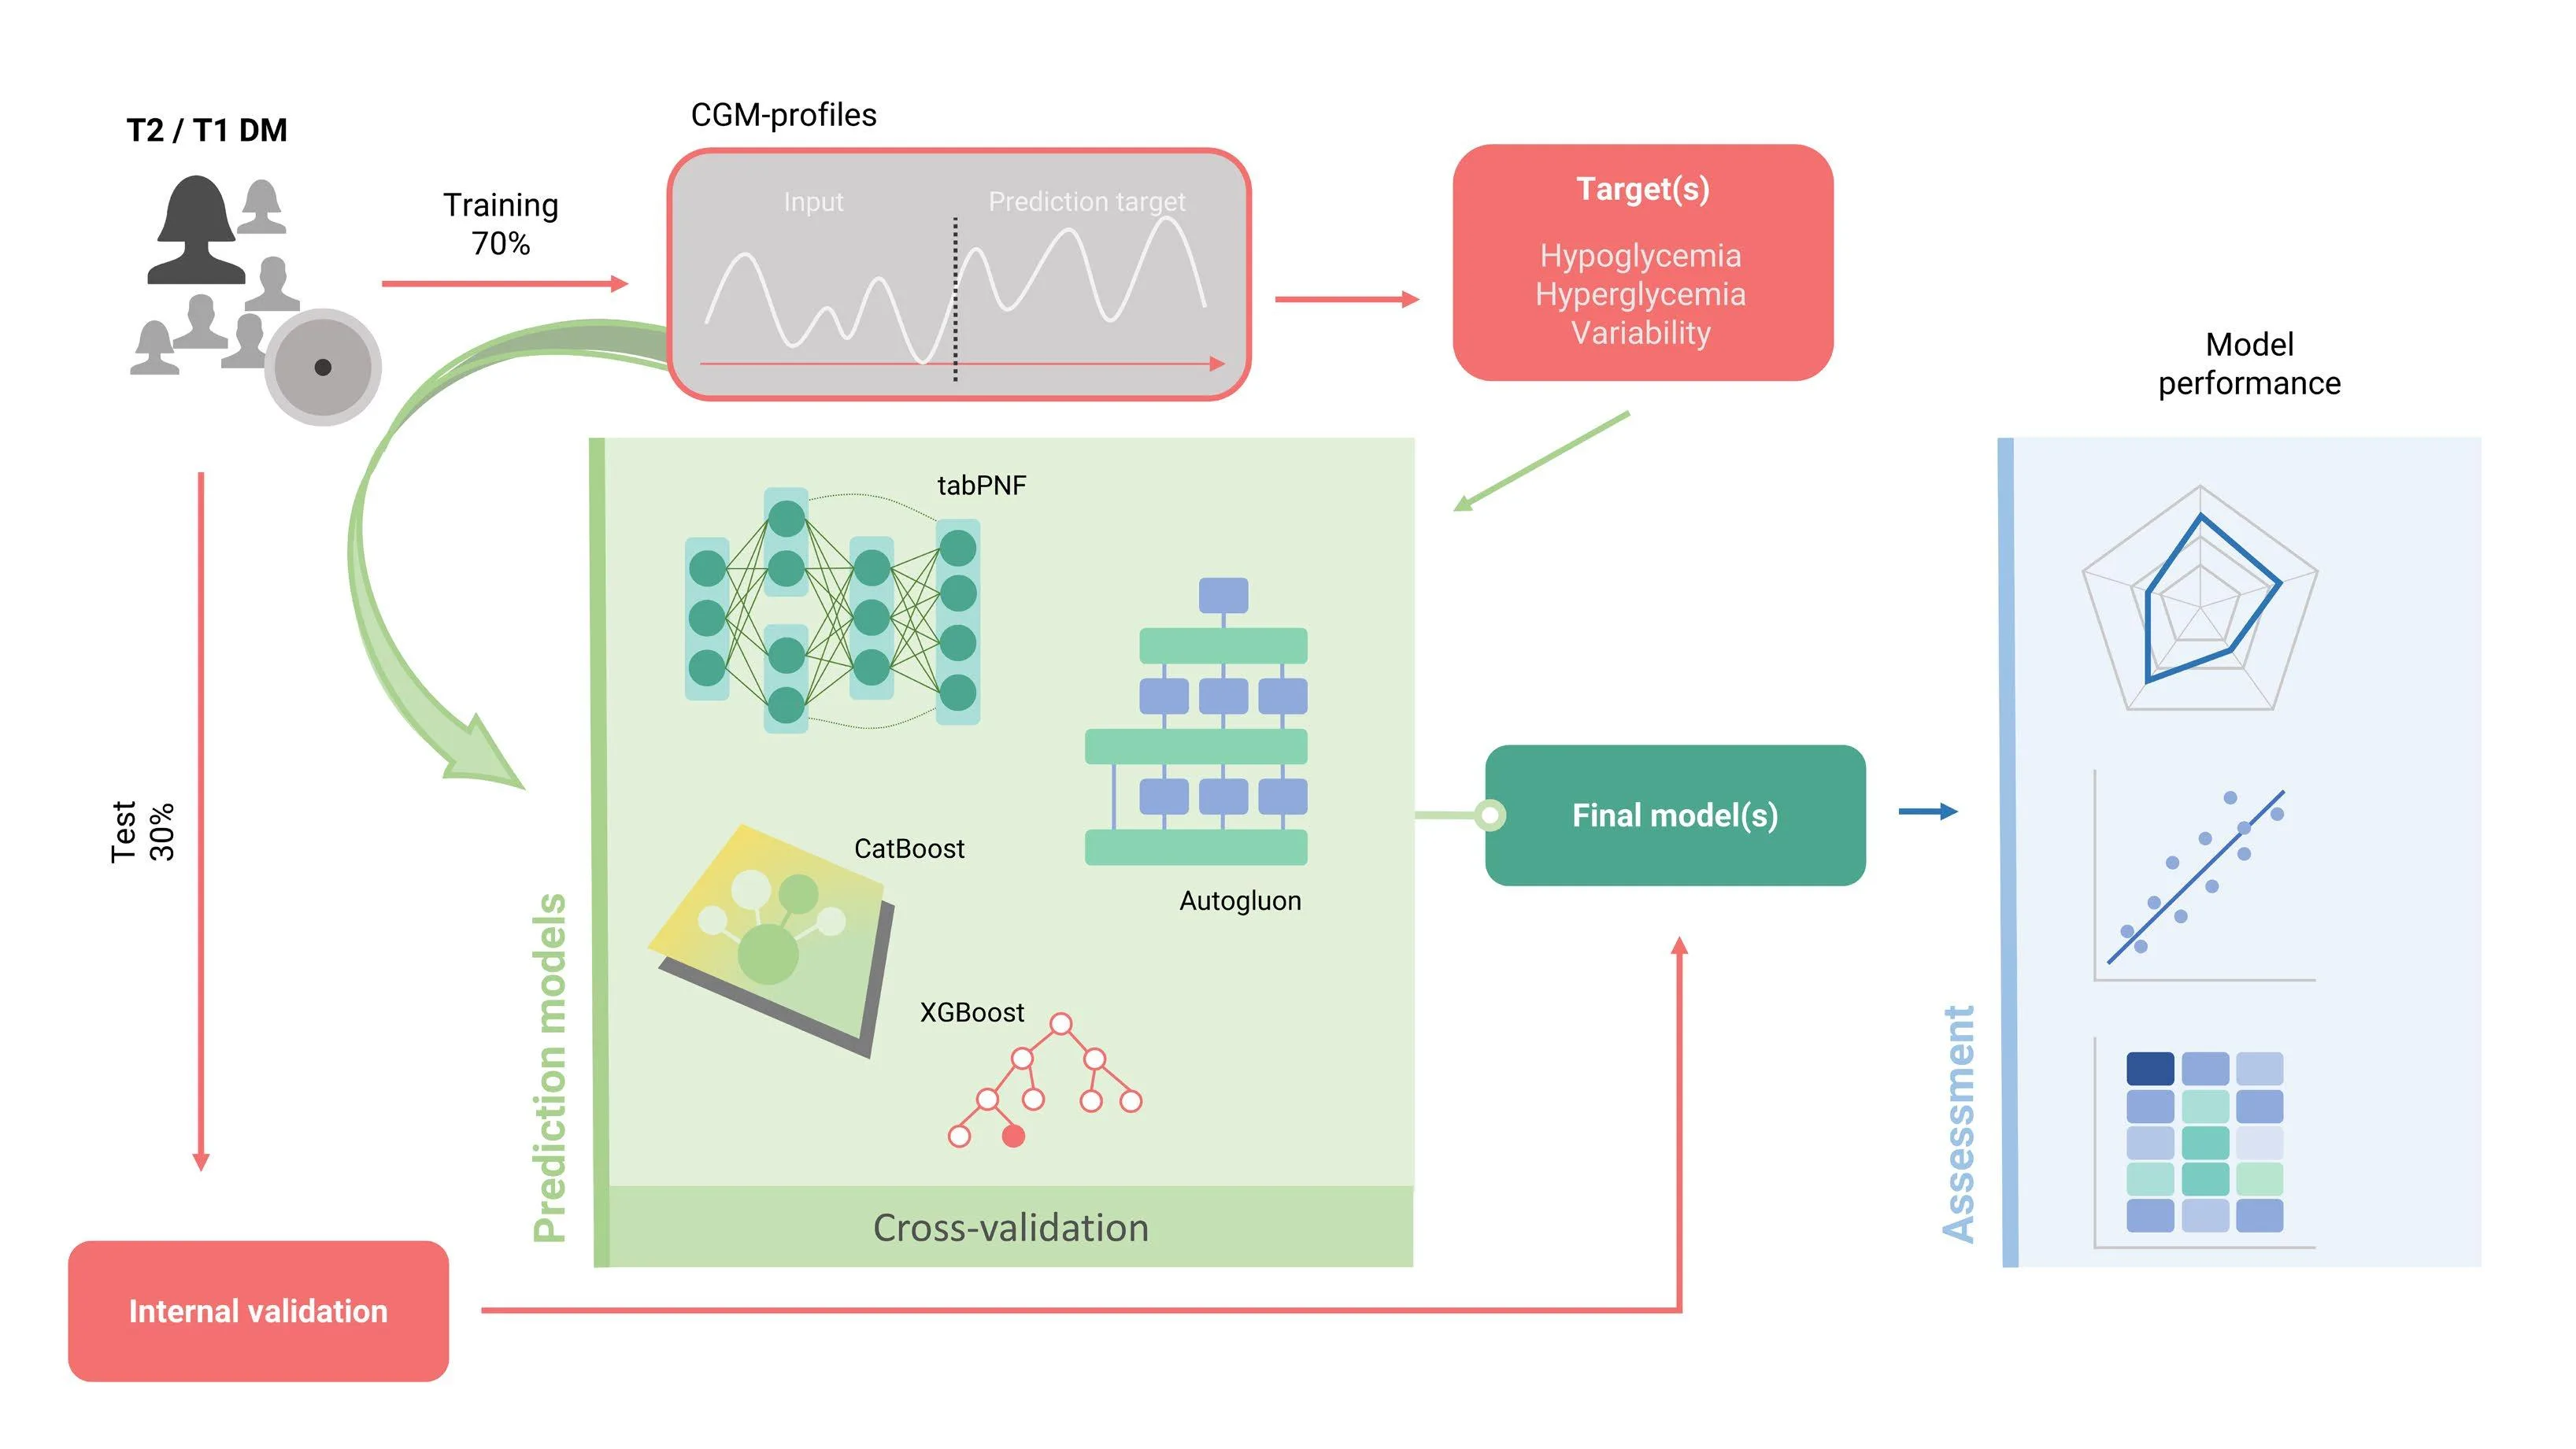
Un capteur sur le bras mesure le sucre dans le sang 24 heures sur 24 et envoie les données au téléphone. Mais le médecin ne les voit qu'après coup : le sucre a chuté la nuit, a grimpé après le déjeuner. Et si on pouvait voir une semaine à l'avance quel sera le niveau de glucose ? C'est exactement ce que les auteurs de l'étude ont tenté de faire.
Ils ont utilisé les enregistrements de 4622 semaines d'observation chez des personnes atteintes de diabète de type 1 et de type 2. Quatre modèles informatiques — comme quatre experts différents — ont appris à partir des semaines passées à prédire six indicateurs pour la semaine suivante. Par exemple, combien de temps le sucre restera dans les limites de sécurité, ou à quel point il fluctuera. Il s'est avéré que tous les modèles réussissent à peu près aussi bien pour la plupart des indicateurs : l'erreur de prédiction est d'environ 8 à 16 pour cent. Mais avec les chutes de sucre rares (hypoglycémie), c'est plus compliqué : l'erreur monte à 48 pour cent, même si en chiffres absolus elle reste faible. C'est comme prédire la météo : les jours ensoleillés sont faciles à deviner, mais un orage rare est difficile à prévoir.
Conclusion pratique : prédire la tendance générale du sucre une semaine à l'avance est déjà possible, mais les chutes de sucre rares et dangereuses restent un défi. À l'avenir, de telles prédictions pourraient aider les personnes diabétiques à ajuster leur dose d'insuline ou leur alimentation à l'avance — comme les prévisions météo aident à prendre un parapluie.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2601.00613
Background: Accurate week-ahead forecasts of continuous glucose monitoring (CGM) derived metrics could enable proactive diabetes management, but relative performance of modern tabular learning approaches is incompletely defined. Methods: We trained and internally validated four regression models (CatBoost, XGBoost, AutoGluon, tabPFN) to predict six weekahead CGM metrics (TIR, TITR, TAR, TBR, CV, MAGE, and related quantiles) using 4,622 case-weeks from two cohorts (T1DM n=3,389; T2DM n=1,233). Performance was assessed with mean absolute error (MAE) and mean absolute relative difference (MARD); quantile classification was summarized via confusion-matrix heatmaps. Results: Across T1DM and T2DM, all models produced broadly comparable performance for most targets. For T1DM, MARD for TIR, TITR, TAR and MAGE ranged 8.5 to 16.5% while TBR showed large MARD (mean ~48%) despite low MAE. AutoGluon and tabPFN showed lower MAE than XGBoost for several targets (e.g., TITR: p<0.01; TAR/TBR: p<0.05 to 0.01). For T2DM MARD ranged 7.8 to 23.9% and TBR relative error was ~78%; tabPFN outperformed other models for TIR (p<0.01), and AutoGluon/ tabPFN outperformed CatBoost/XGBoost on TAR (p<0.05). Inference time per 1,000 cases varied markedly (PFN 699 s; AG 2.7 s; CatBoost 0.04 s, XGBoost 0.04 s). Conclusions: Week-ahead CGM metrics are predictable with reasonable accuracy using modern tabular models, but low-prevalence hypoglycemia remains difficult to predict in relative terms. Advanced AutoML and foundation models yield modest accuracy gains at substantially higher computational cost.
L'erreur de prédiction pour les chutes de sucre rares est énorme en termes relatifs — environ 48 pour cent, alors qu'en valeur absolue il ne s'agit que de quelques minutes par jour. Autrement dit, les modèles ont « presque raison », mais ces quelques minutes peuvent être les plus dangereuses.