Карта болезней: как связать гены и недуги экспресс
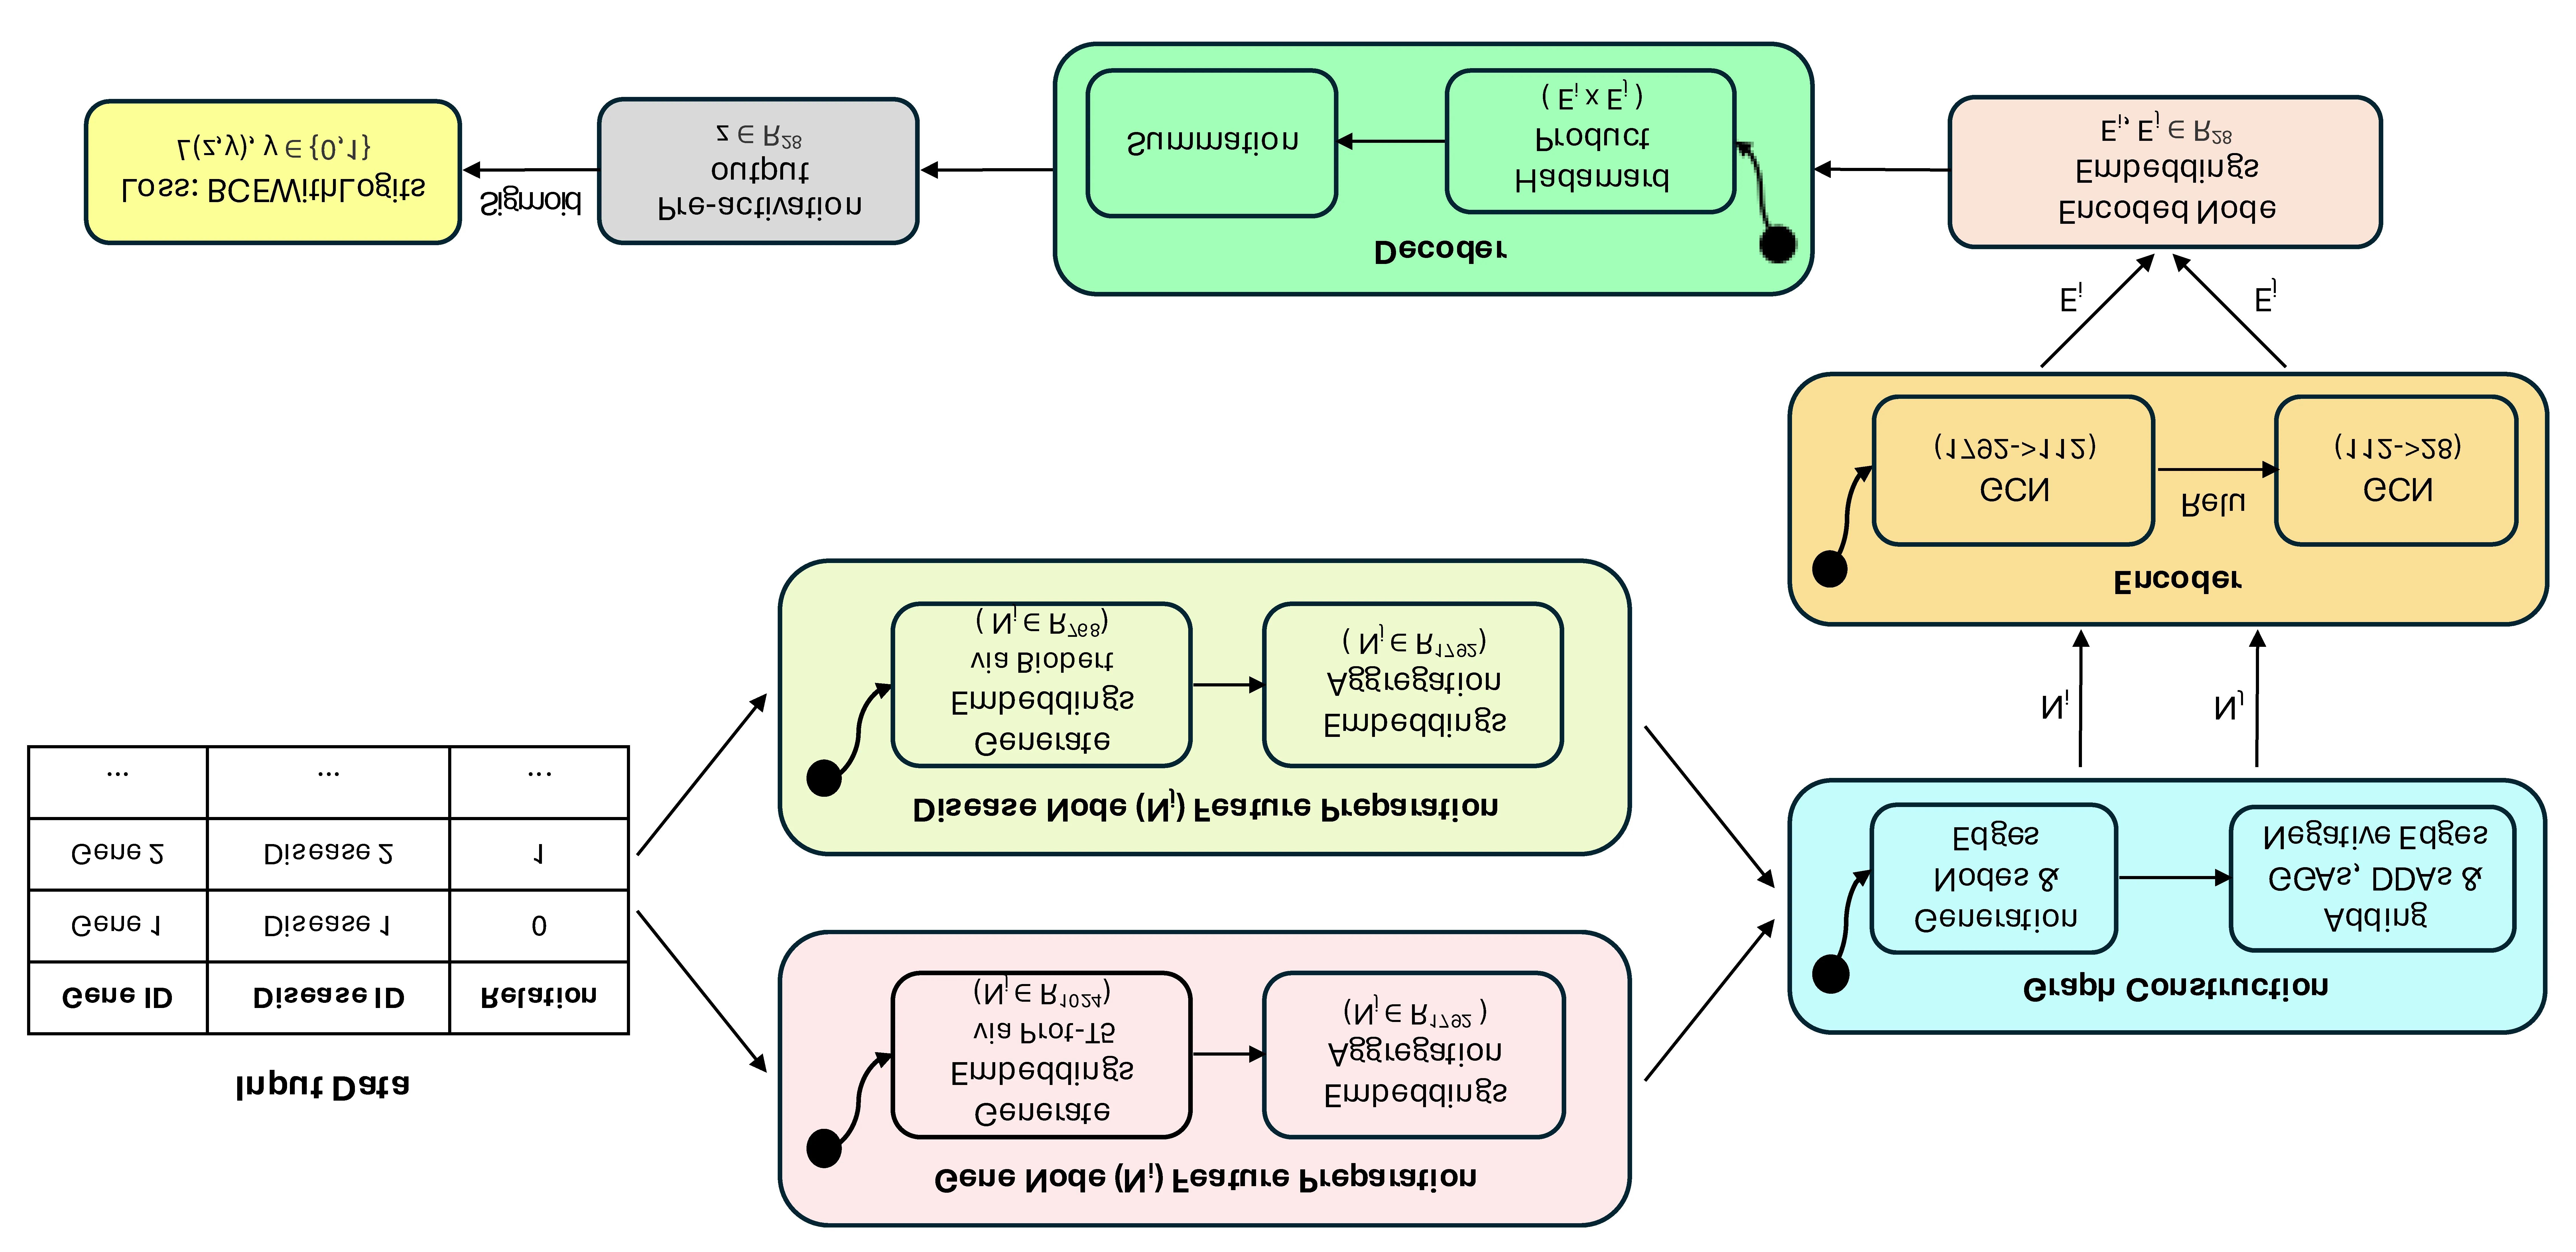
Внутри каждой клетки идёт непрерывная работа: белки общаются, гены включаются и выключаются, а сбои в этой системе приводят к болезням. Чтобы найти виновника недуга, учёные раньше вручную перебирали научные статьи и базы данных — как детектив, который опрашивает свидетелей по одному. Но связей так много, что в одиночку не справиться.
Новая модель GLaDiGAtor работает как умный граф: она строит карту, где точки — это гены и болезни, а линии между ними — известные взаимодействия. Затем она учится на этой карте, как на примерах, и предсказывает, где должны быть недостающие линии. В карту встроены и текстовые подсказки: описания болезней и последовательности белков, которые модель читает как аннотации к точкам. Благодаря этому она видит не только прямые связи, но и скрытые закономерности.
Такой подход ускоряет поиск генов-мишеней для лекарств. Вместо месяцев ручной работы — несколько часов вычислений. И чем больше данных попадает в карту, тем точнее становятся предсказания. Возможно, скоро мы сможем заранее видеть, какой ген выйдет из строя при той или иной болезни, и готовить лечение до появления симптомов.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2602.18769
Understanding disease-gene associations is essential for unravelling disease mechanisms and advancing diagnostics and therapeutics. Traditional approaches based on manual curation and literature review are labour-intensive and not scalable, prompting the use of machine learning on large biomedical data. In particular, graph neural networks (GNNs) have shown promise for modelling complex biological relationships. To address limitations in existing models, we propose GLaDiGAtor (Graph Learning-bAsed DIsease-Gene AssociaTiOn pRediction), a novel GNN framework with an encoder-decoder architecture for disease-gene association prediction. GLaDiGAtor constructs a heterogeneous biological graph integrating gene-gene, disease-disease, and gene-disease interactions from curated databases, and enriches each node with contextual features from well-known language models (ProtT5 for protein sequences and BioBERT for disease text). In evaluations, our model achieves superior predictive accuracy and generalisation, outperforming 14 existing methods. Literature-supported case studies confirm the biological relevance of high-confidence novel predictions, highlighting GLaDiGAtor's potential to discover candidate disease genes. These results underscore the power of graph convolutional networks in biomedical informatics and may ultimately facilitate drug discovery by revealing new gene-disease links. The source code and processed datasets are publicly available at https://github.com/HUBioDataLab/GLaDiGAtor.
Модель использует два языка: один «читает» последовательности белков, другой — медицинские тексты, и объединяет их в единую карту.