Большие языковые модели — это методы на основе нейронных сетей, которые учатся генерировать и предсказывать человекоподобный текст по огромным наборам данных.
Современные большие языковые модели — это нейросети с архитектурой «трансформер», насчитывающие от сотен миллионов до сотен миллиардов параметров. Каждый параметр — это число, влияющее на то, как сигнал от одного слова передаётся другому. Модель не хранит слова, а превращает их в векторы чисел — математические точки в многомерном пространстве смыслов. Предобучение идёт по задаче автозаполнения: модель закрывает пропущенные слова или предсказывает следующее слово в последовательности. После этого её можно дообучить на специализированных примерах, чтобы она вела диалог, решала задачи или писала код.
История
История началась с статистических n-граммных моделей (1950‑е), затем нейросетевых языковых моделей (Bengio et al., 2000‑е). Поворотным моментом стала статья Attention Is All You Need (2017), предложившая архитектуру трансформера. Компания OpenAI в 2018 выпустила GPT-1 с 117 млн параметрами, а в 2020 GPT-3 с 175 млрд параметрами продемонстрировала, что модель без явного обучения умеет переводить, программировать и рассуждать, просто получив инструкцию на естественном языке. С тех пор соревнование идёт как в сторону увеличения моделей, так и повышения эффективности (Mixture-of-Experts, Chinchilla scaling laws).
Как это работает
Модель получает на вход контекстное окно из n токенов. Каждый токен отображается в эмбеддинг и кодируется слоями самовнимания, создавая контекстуализированные представления. На выходе линейный классификатор предсказывает распределение вероятностей следующего токена. Обучение минимизирует перекрёстную энтропию между предсказанием и истинным токеном. При генерации текст порождается последовательным сэмплированием токенов (обычно с ядром top-p или top-k). Ключевые техники: предварительное обучение на неразмеченном тексте, затем инструктивное или RLHF‑дообучение для настройки на полезность и безопасность. Механизм внимания вычисляет веса схожести запросов и ключей для каждой пары токенов, позволяя фокусироваться на дальних зависимостях.
Где применяется
Такие модели пишут новости, сочиняют стихи, генерируют программный код, отвечают на вопросы клиентов в чатах и помогают врачам составлять выписки из историй болезни.
Любопытный факт
GPT-3 способна написать эссе, которое комиссия не отличила от написанного человеком, за 2 секунды — время, за которое человек только открывает текстовый редактор.
В марте 2020 года Франция опустела: люди перестали ходить на работу, в школы и кафе, а улицы наполнились тишиной. Эпидемиологи смотрели на графики и понимали, что вирус распространяется не сам по себе, а через рукопожатия, разговоры и поездки в метро. Но как предсказать, сколько контактов останется у человека, если правительство объявит новые ограничения?
В марте 2020 года Франция опустела: люди перестали ходить на работу, в школы и кафе, а улицы наполнились тишиной. Эпидемиологи смотрели на графики и понимали, что вирус распространяется не сам по себе, а через рукопожатия, разговоры и поездки в метро. Но как предсказать, сколько контактов останется у человека, если правительство объявит новые ограничения?
Белок в клетке не статичен, как манекен в витрине. Его атомы непрерывно колеблются, растягиваются и изгибаются — подобно натянутой гитарной струне, которая продолжает вибрировать после щипка. Чтобы понять функцию белка, необходимо оценить жёсткость связей между его участками.
Переводчик отвлекается на каждый шорох в зале — и час совещания превращается в два. Так и молекулярные фундаментальные модели: они выучивают язык молекул на гигантских корпусах, но для каждого нового разговора требуют настройки. Monroe меняет правила: она не учит новый язык, а мгновенно находит общий смысл по нескольким примерам.
Медицинская карта — это своего рода хроника: визиты к врачу, диагнозы, назначения, результаты анализов. Врач, работая с пациентом, вынужден просматривать эту хронику, чтобы восстановить контекст. Теперь же этот процесс берёт на себя алгоритм — и справляется за секунды.
Поиск нового материала напоминает кулинарные эксперименты без рецепта: пробуешь, пробуешь — и часто выбрасываешь. Раньше учёные вручную просматривали научные статьи и по одному проверяли составы. Теперь появился «робот-повар», который сам читает литературу, смешивает компоненты и анализирует результат.
Радиотелескоп, словно чуткое ухо, улавливает шёпот далёких галактик. Среди этого шума прячутся исполины — гигантские радиоисточники. Это облака заряженных частиц, выброшенные из окрестностей сверхмассивных чёрных дыр. Они растянулись на миллионы световых лет — в десятки раз больше нашей Галактики.
В духовке при повышении температуры молекулы движутся быстрее, и беспорядок растёт. С языковыми моделями вроде ChatGPT всё наоборот. Когда разработчики увеличивают параметр «температура» — величину, управляющую случайностью выбора слов, — модель получает доступ к более широкому выбору слов, но её длинные тексты внезапно зацикливаются.
Магнитоэнцефалограф — прибор, похожий на шлем с сотнями датчиков, — улавливает слабые магнитные поля, которые создают работающие нейроны. Если человек слушает речь, в этих сигналах прячутся отпечатки услышанных слов. Но достать их оттуда непросто: сигнал от тысяч источников сливается в запутанный клубок.
Человеческий разум похож на конструктор, который сам себя достраивает. Новые идеи не умирают вместе с человеком — они передаются, смешиваются и отбираются. Этот процесс называют культурной эволюцией: полезные изобретения закрепляются, а бесполезные забываются. Так работает храповик — механизм, который крутится только вперёд.
Четыре слабых штриха на снимке — всё, что видит астроном. Так скульптор по четырём теням восстанавливает форму невидимого стекла. Около ста лет назад Альберт Эйнштейн предсказал, а Фриц Цвикки предложил использовать гравитационные линзы — естественные телескопы из тёмной материи, усиливающие свет далёких…
Двести сорок две тысячи триста двадцать семь галактик — как песчинок на пляже. Но астрономы превратили этот хаос в карту: алгоритм UMAP (метод машинного обучения) взял у каждой из галактик одиннадцать параметров — семь цветов от оптики до среднего инфракрасного диапазона (это фотометрия), звёздную величину, радиус и фотометрическое…
В 2025 году большие языковые модели вроде GPT уже не просто болтают — они помогают учёным ставить эксперименты. Но тот же инструмент может попасть в руки злоумышленника. Группа исследователей построила цифровой полигон, чтобы это выяснить.
Художник делает быстрый набросок углём — и лицо на портрете уже узнаваемо. Астрофизики решают схожую задачу: спектр звезды — это её индивидуальный портрет, раскрывающий температуру, состав, силу тяжести. До недавнего времени для получения такого портрета требовалась кропотливая «живопись маслом» — код радиативного переноса в условиях отклонения от локального теплового равновесия (non-LTE).
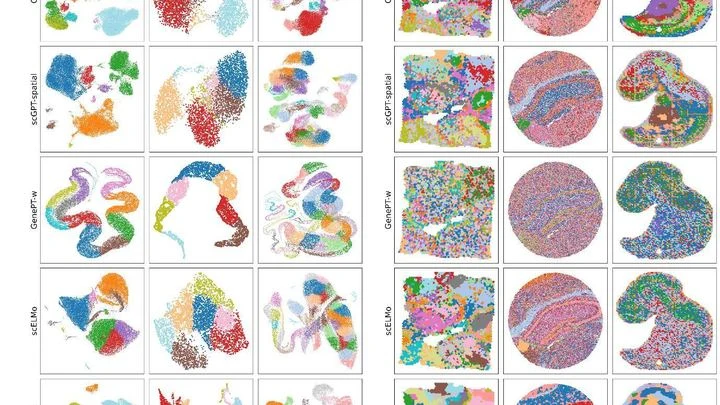
Биологи всё чаще доверяют компьютерам чтение «инструкций по эксплуатации» живой клетки. Шесть свежих моделей искусственного интеллекта — Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo и Novae — как шесть переводчиков с разных диалектов одного и того же клеточного языка.
Представьте кулинарную книгу, которая переписывается от поколения к поколению. Однажды рецепт борща получает секретный ингредиент от кондитера — и с этого момента вкус помнит не только предков, но и соседа. В стандартной модели эволюции гены ведут себя так же. Гены — это инструкции для организма, своего рода молекулярные рецепты.
Радиосигналы в замкнутом пространстве ведут себя подобно акустическим волнам в концертном зале: многократно отражаясь от стен, мебели и других поверхностей, они формируют уникальную интерференционную картину — своего рода безмолвную «мелодию» каждого места. Смартфон, оснащённый приёмником, подобно чуткому уху, регистрирует эту картину через анализ помех и искажений сигнала.
Обычные алгоритмы компьютерного зрения воспринимают медицинские изображения как набор несвязанных фрагментов — любые два несовпадающих снимка для них абсолютно различны. Это напоминает попытку отличить близнецов, не зная об их родстве. В медицине же пациенты с одним заболеванием часто выглядят на МРТ почти идентично, и алгоритм ошибается, путая «родственные» случаи.
Человек без усилий выхватывает нужный голос из гомона вечеринки — наш мозг справляется с этой задачей, словно опытный рыбак, безошибочно узнающий плеск знакомой рыбы в бурном потоке. Для компьютера то же самое — пока задача на пределе возможностей. Прежние программы тренировались на стерильных записях, где нет ни эха, ни звона приборов.
Модели, превращающие текст в аудио, хорошо воссоздают одиночные звуки, но путаются, когда в сценарии их несколько. Например, по сценарию сначала звонок, потом шаги, потом хлопок двери. Генератор может переставить события, и зритель услышит шаги до звонка.
Исследователи нашли неожиданное решение: вместо программирования сложных правил они взяли нейросеть, которая «понимает» аудио, и сделали её строгим контролёром.
Автоматические судьи речи — это алгоритмы, обученные оценивать произношение и эмоциональную окраску голоса. Однако, как показали исследования, они часто ведут себя подобно кулинарному критику, который выносит вердикт, прочитав меню, но не попробовав само блюдо.
В сердце каждой нейтронной звезды скрыта симфония — сложное переплетение квантовых полей и релятивистской гравитации. Почти век назад Фриц Цвикки описал эти объекты как «звёзды-атомы», а Джоселин Белл Бернелл подарила нам их голос — строгий ритм пульсаров.
В кастрюле с супом достаточно двух термометров, чтобы понять температуру везде — если знать, что тепло идёт кругами от дна. Так и в науке: по редким замерам нужно восстановить полную картину теплового поля.
Мозг общается короткими электрическими разрядами — потенциалами действия. Прежде расшифровка этого языка требовала тысяч размеченных примеров: экспериментатор сопоставлял сигнал с конкретным движением или словом. Метод MOJO предлагает иной подход — подобно изучению языка через погружение, он сначала вслушивается в «поток сознания» без всяких подсказок и самостоятельно выявляет повторяющиеся паттерны.
Долгое время биологи изучали клетки, слушая лишь один голос в многоголосом хоре: например, измеряли активность генов — транскриптом, игнорируя, как упакована ДНК — эпигеном. Это всё равно что пытаться понять смысл разговора, зная только один язык.
Оценка качества снимка — это работа для дотошного контролёра с целым арсеналом инструментов. Нейросеть IQA-T1 действует именно так: она не просто разглядывает картинку, а методично применяет то спектроскоп, то люксметр. Цифровой шум, словно рябь на воде, маскирует дефекты, но анализ частот — спектроскопия изображения — позволяет выявить потерю резкости.
Звуковой сигнал удобно представлять комплексным числом: его модуль (амплитуда) отражает громкость, а аргумент (фаза) — положение волны во времени, её мгновенный сдвиг. Традиционные нейросети расщепляют это единое описание на две независимые координаты — грубо говоря, задают адрес в декартовой сетке: «два шага на восток, один на север».
Приготовление сложного блюда требует чёткого рецепта: сначала нарезать, потом обжарить, добавить специи в нужный момент. Химические превращения тоже идут по пошаговым рецептам — механизмам, где атомы углерода и водорода перестраиваются строго по очереди.
Раньше нейросети часто выдумывали несуществующие шаги, как повар-фантазёр, заменяющий соль сахаром.
Нейроморфные чипы функционируют по принципам, отличным от классических компьютеров, построенных по архитектуре фон Неймана с раздельными блоками памяти и процессора.
Программные помощники для написания кода, или AI-ассистенты, часто действуют как повар, который ради варки одного яйца перечитывает всю кулинарную книгу. Получив задачу внести крошечное исправление, они заново открывают десятки файлов и проверяют давно известные связи.
Представьте кухню, где каждое «блюдо» — синтезированный по тексту звук — готовят десятки поваров. Многие из них лишь мешают: подают ложные сигналы и бесцельно тратят ресурсы. Именно так устроена полная версия нейросети-генератора звуков: множество её связей не участвуют в деле, но потребляют вычислительную мощность.
Передатчик отправляет лишь грубый набросок сообщения — как художник, рисующий контуры без деталей. На приёме искусственный интеллект, подобно опытному реставратору, восстанавливает полную картину, очищая её от помех. Так устроена технология LiTCom, которая меняет правила игры в будущих сетях 6G.
Крупная нейросеть, такая как Whisper, владеющая сотнями языков, напоминает стандартную модель физики элементарных частиц — стройную систему, где всё находится в тонком равновесии.
Стандартный подход к оцифровке речи, лежащий в основе современных телекоммуникаций, — это прямая дискретизация: тысячи раз в секунду фиксируется мгновенная громкость сигнала. Представьте, что вы пробуете бульон чайной ложкой — каждый глоток даёт лишь слабый намёк на вкус, а чтобы уловить букет, приходится черпать снова и снова.
Семейное древо превращается в клубок, если учесть приёмных детей и повторные браки. Эволюция часто похожа на такой клубок: хотя стандартная модель — традиционное представление о дивергентной эволюции, где виды ветвятся подобно дереву — рисует аккуратное древо видов, на деле гены кочуют не только по наследству, но и напрямую между неродственными организмами — этот…
Живая энергосистема подобна организму: линии электропередач — это сосуды, по которым течёт ток-кровь. Данные же — нервные импульсы, которые прежде рассеивались, не достигая единого центра обработки. Проект mAIEnergy подключает эти «нервы» к общему «мозгу», создавая хранилище, где собраны спутниковые снимки, показания электросчётчиков, научные статьи и метеосводки.
Опытный сыщик не вычисляет путь преступника, решая дифференциальные уравнения движения, — он обращается к картотеке схожих дел. Точно так же действует новый метод предсказания: в его основе не сложные формулы, а гигантский архив уже реализованных траекторий — движений планет, колебаний валютных курсов, сигналов из глубин космоса.
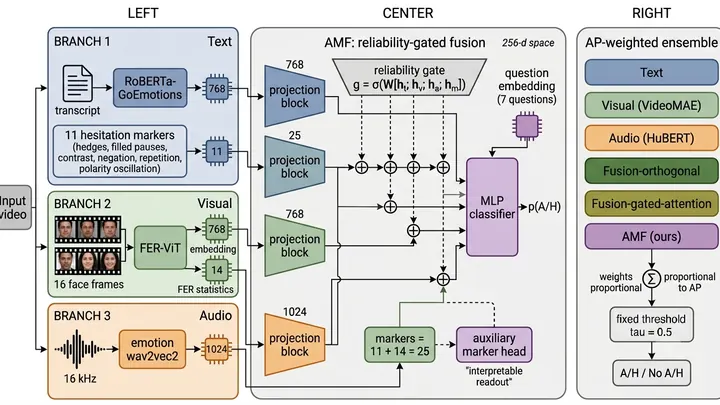
Новая система анализирует короткое интервью, чтобы распознать сомнения человека, объединяя текст, голос и выражение лица. Но главным ключом к неуверенности оказалась тёмная материя речи — паузы и слова-паразиты, которые стандартные речевые системы стирают, словно чёрная дыра, поглощающая всё без следа.
Квантовые устройства перестали быть лабораторными курьёзами. Их собирают, настраивают и чинят как обычную технику — только внутри у них не просто ток, а хитросплетения частиц, которые могут быть в нескольких состояниях сразу. Инженеры чертят схемы, программисты пишут код, физики рассчитывают эффекты. У каждого свой набор моделей, и их нужно сводить воедино, чтобы устройство работало.
Современная космология попала в диссонанс. Локальные измерения постоянной Хаббла по сверхновым и цефеидам дают около 73 км/с/Мпк, тогда как глобальные ограничения из реликтового излучения в рамках стандартной ΛCDM-модели указывают на 67 км/с/Мпк.