Охота на гены по одному слову экспресс
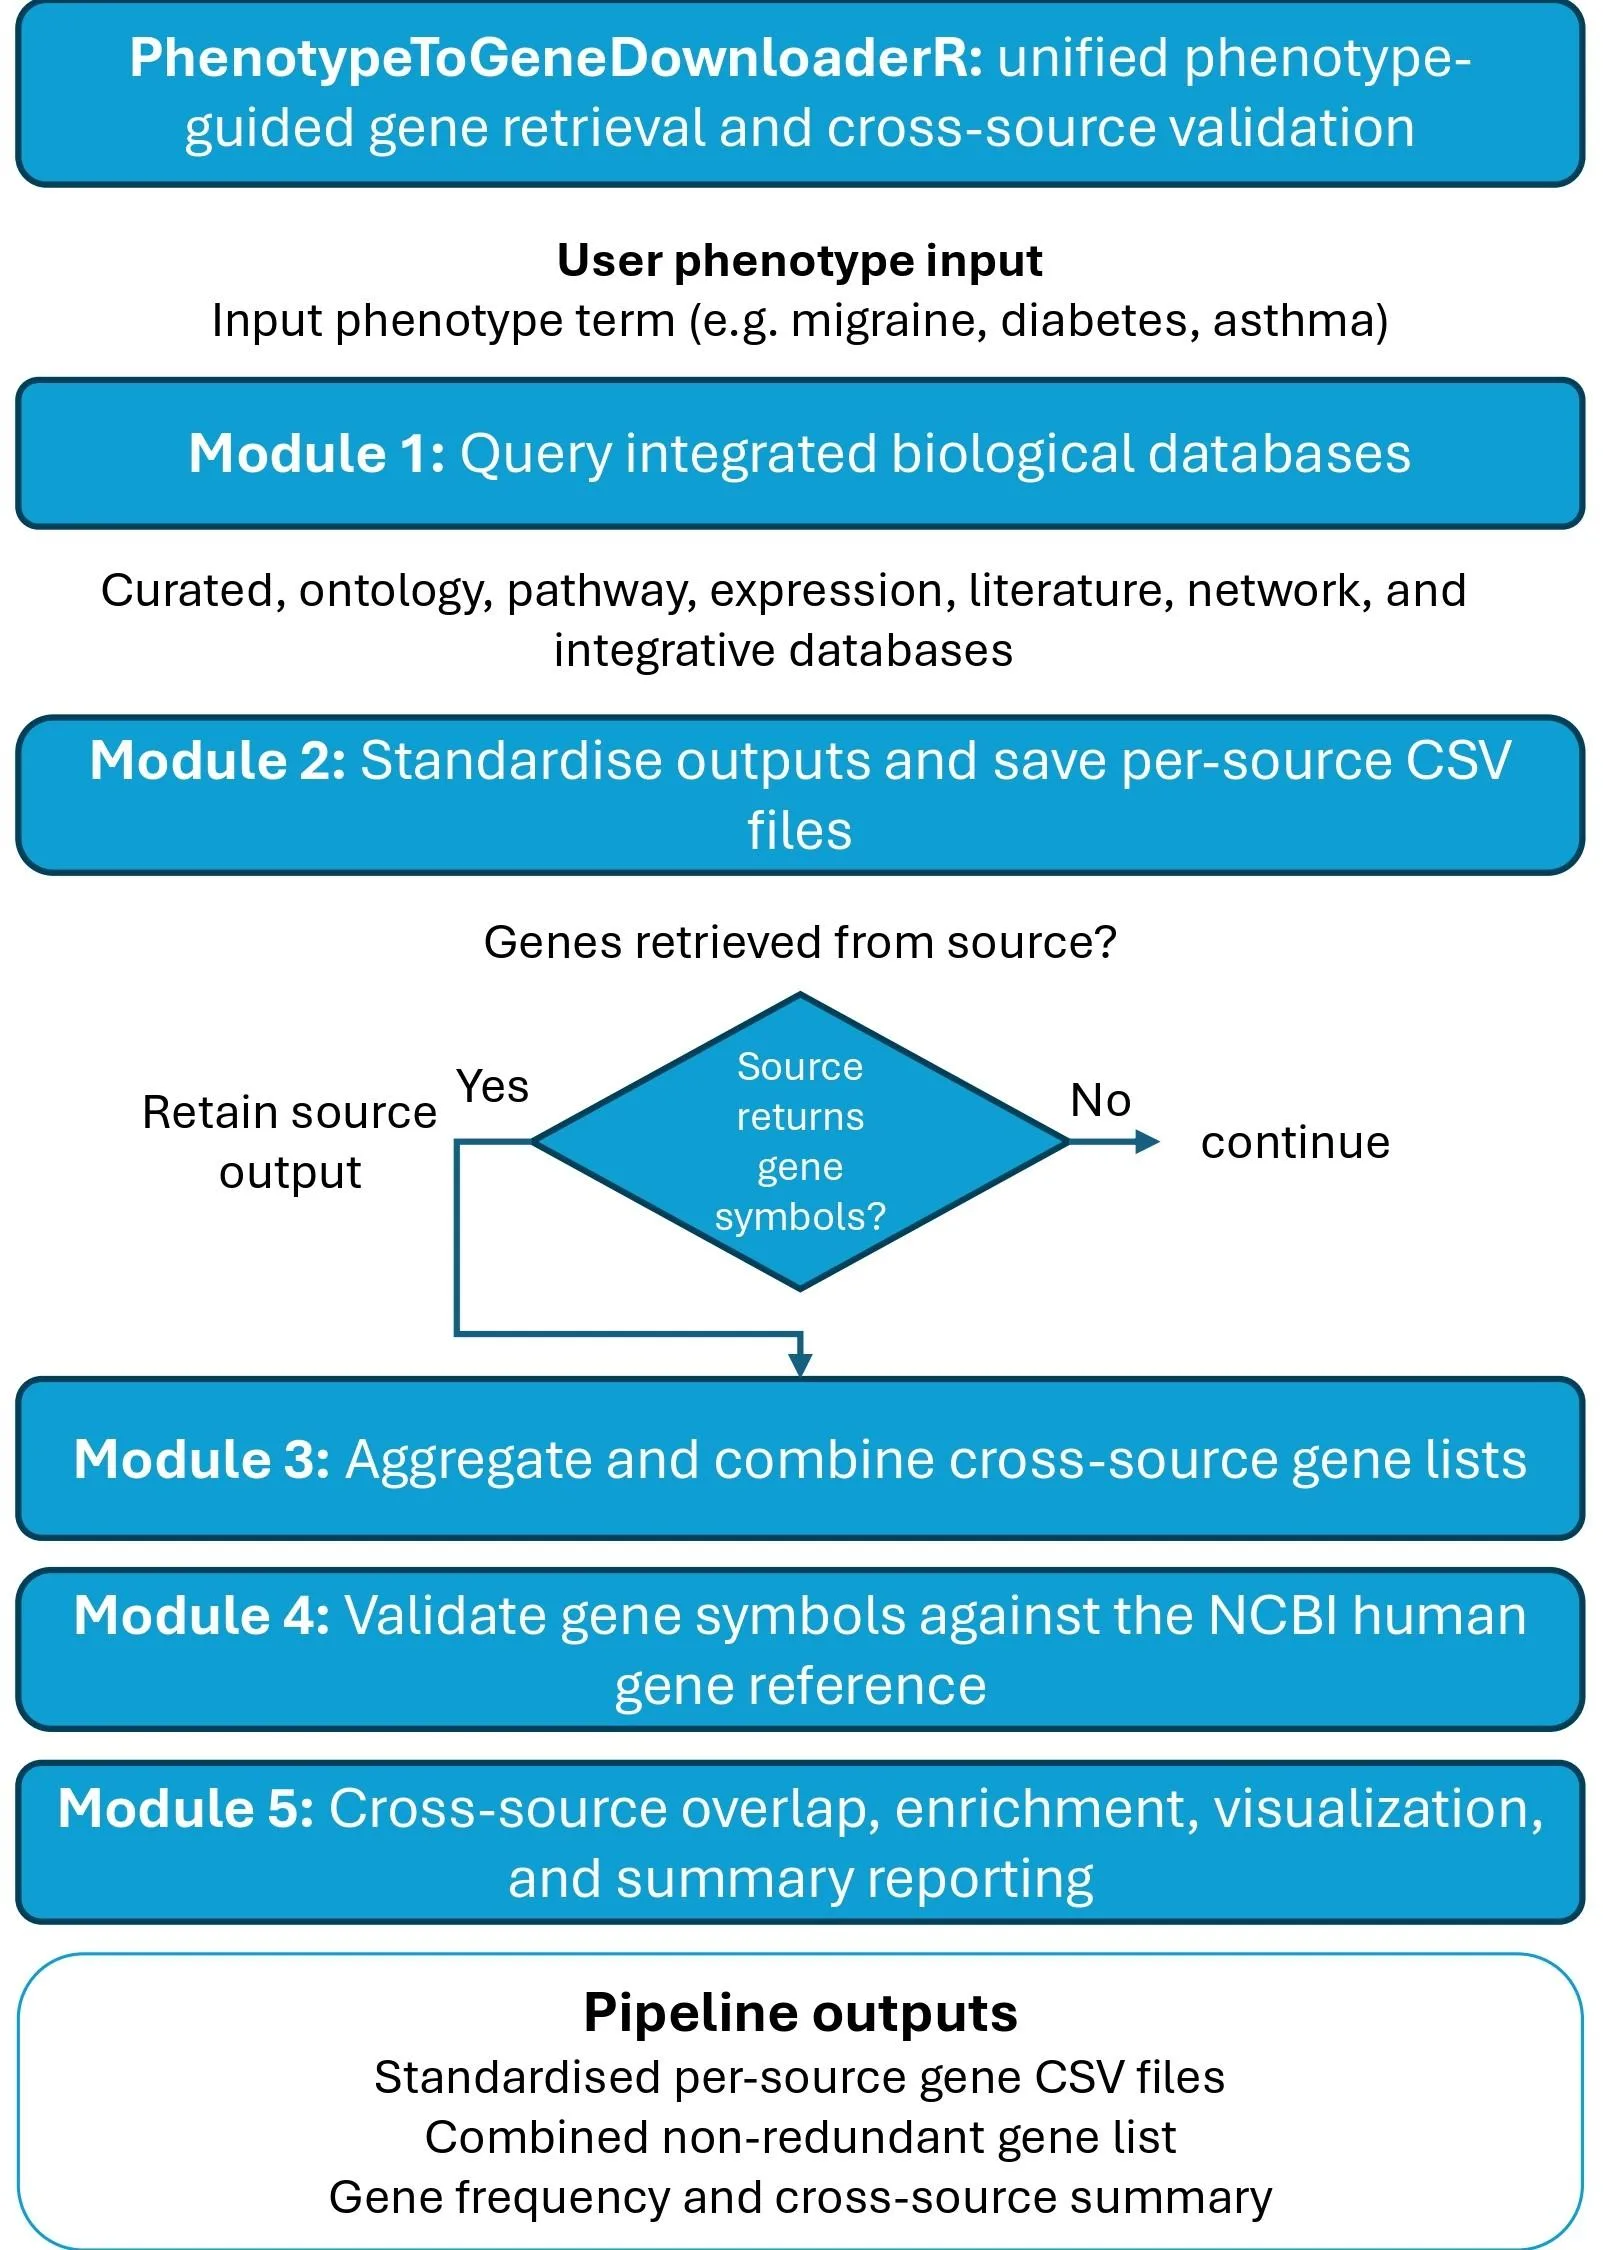
Собрать пазл, когда кусочки разбросаны по 13 коробкам с разными системами нумерации, — примерно так выглядит поиск генов, связанных с конкретной болезнью. Данные есть, но они спрятаны в базах с собственными интерфейсами, форматами и даже языком описания. Новая программа PhenotypeToGeneDownloaderR берёт на себя роль переводчика и сортировщика: вы даёте ей название болезни, а она сама обходит все хранилища, вытаскивает списки генов и приводит их к общему знаменателю.
Собранные списки часто не совпадают друг с другом — разные базы видят проблему под своим углом, и в этом сила подхода: объединяя их, мы получаем более полную картину. Когда программу проверили по «золотому стандарту» из трёх авторитетных источников (HPO, ClinVar и OMIM), она нашла 1039 из 1056 известных генов — то есть 98,4%. Это значит, что почти ничего не пропущено, а лишнего — минимум. Такой инструмент экономит недели ручной работы и снижает риск ошибки, когда врач или учёный вручную переносит названия из одной системы в другую.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2605.01378
Identifying phenotype-associated genes is a common first step in polygenic risk score construction, enrichment testing, target prioritisation and variant interpretation, but relevant evidence is distributed across heterogeneous databases with different interfaces, formats and evidence models. Here, we present PhenotypeToGeneDownloaderR, a phenotype-guided R/Python pipeline for automated gene retrieval, harmonisation, symbol validation and cross-source summary analysis. Given a phenotype term, the pipeline queries integrated biological databases, standardises per-source outputs, combines gene lists, validates retrieved symbols against the NCBI human gene reference and generates summary tables and visualisations. Across 13 clinically relevant phenotypes and 13 databases, PhenotypeToGeneDownloaderR generated 136,487 raw gene retrievals, with at least one source returning genes for every phenotype. Across all 13 phenotypes, 100,175 of 114,345 combined input symbols were retained after direct or synonym-based validation, corresponding to an 87.6\% validation rate. Cross-source overlap was low, supporting the complementarity of integrated evidence sources. Against an HPO/ClinVar/OMIM-derived gold standard, the pipeline recovered 1,039 of 1,056 known phenotype-associated genes, corresponding to 98.4\% recall. PhenotypeToGeneDownloaderR provides a lightweight, reproducible upstream framework for generating candidate gene sets for downstream prioritisation and interpretation. The pipeline is implemented in R and Python, released under the MIT licence, and available at https://github.com/MuhammadMuneeb007/PhenotypeToGeneDownloaderR.
Названия генов иногда меняются, как адреса улиц при переименовании города, — и без сверки со свежим справочником можно годами ссылаться на «старый дом», которого уже нет в официальных картах.