Белковый конструктор с памятью о лучших ходах экспресс
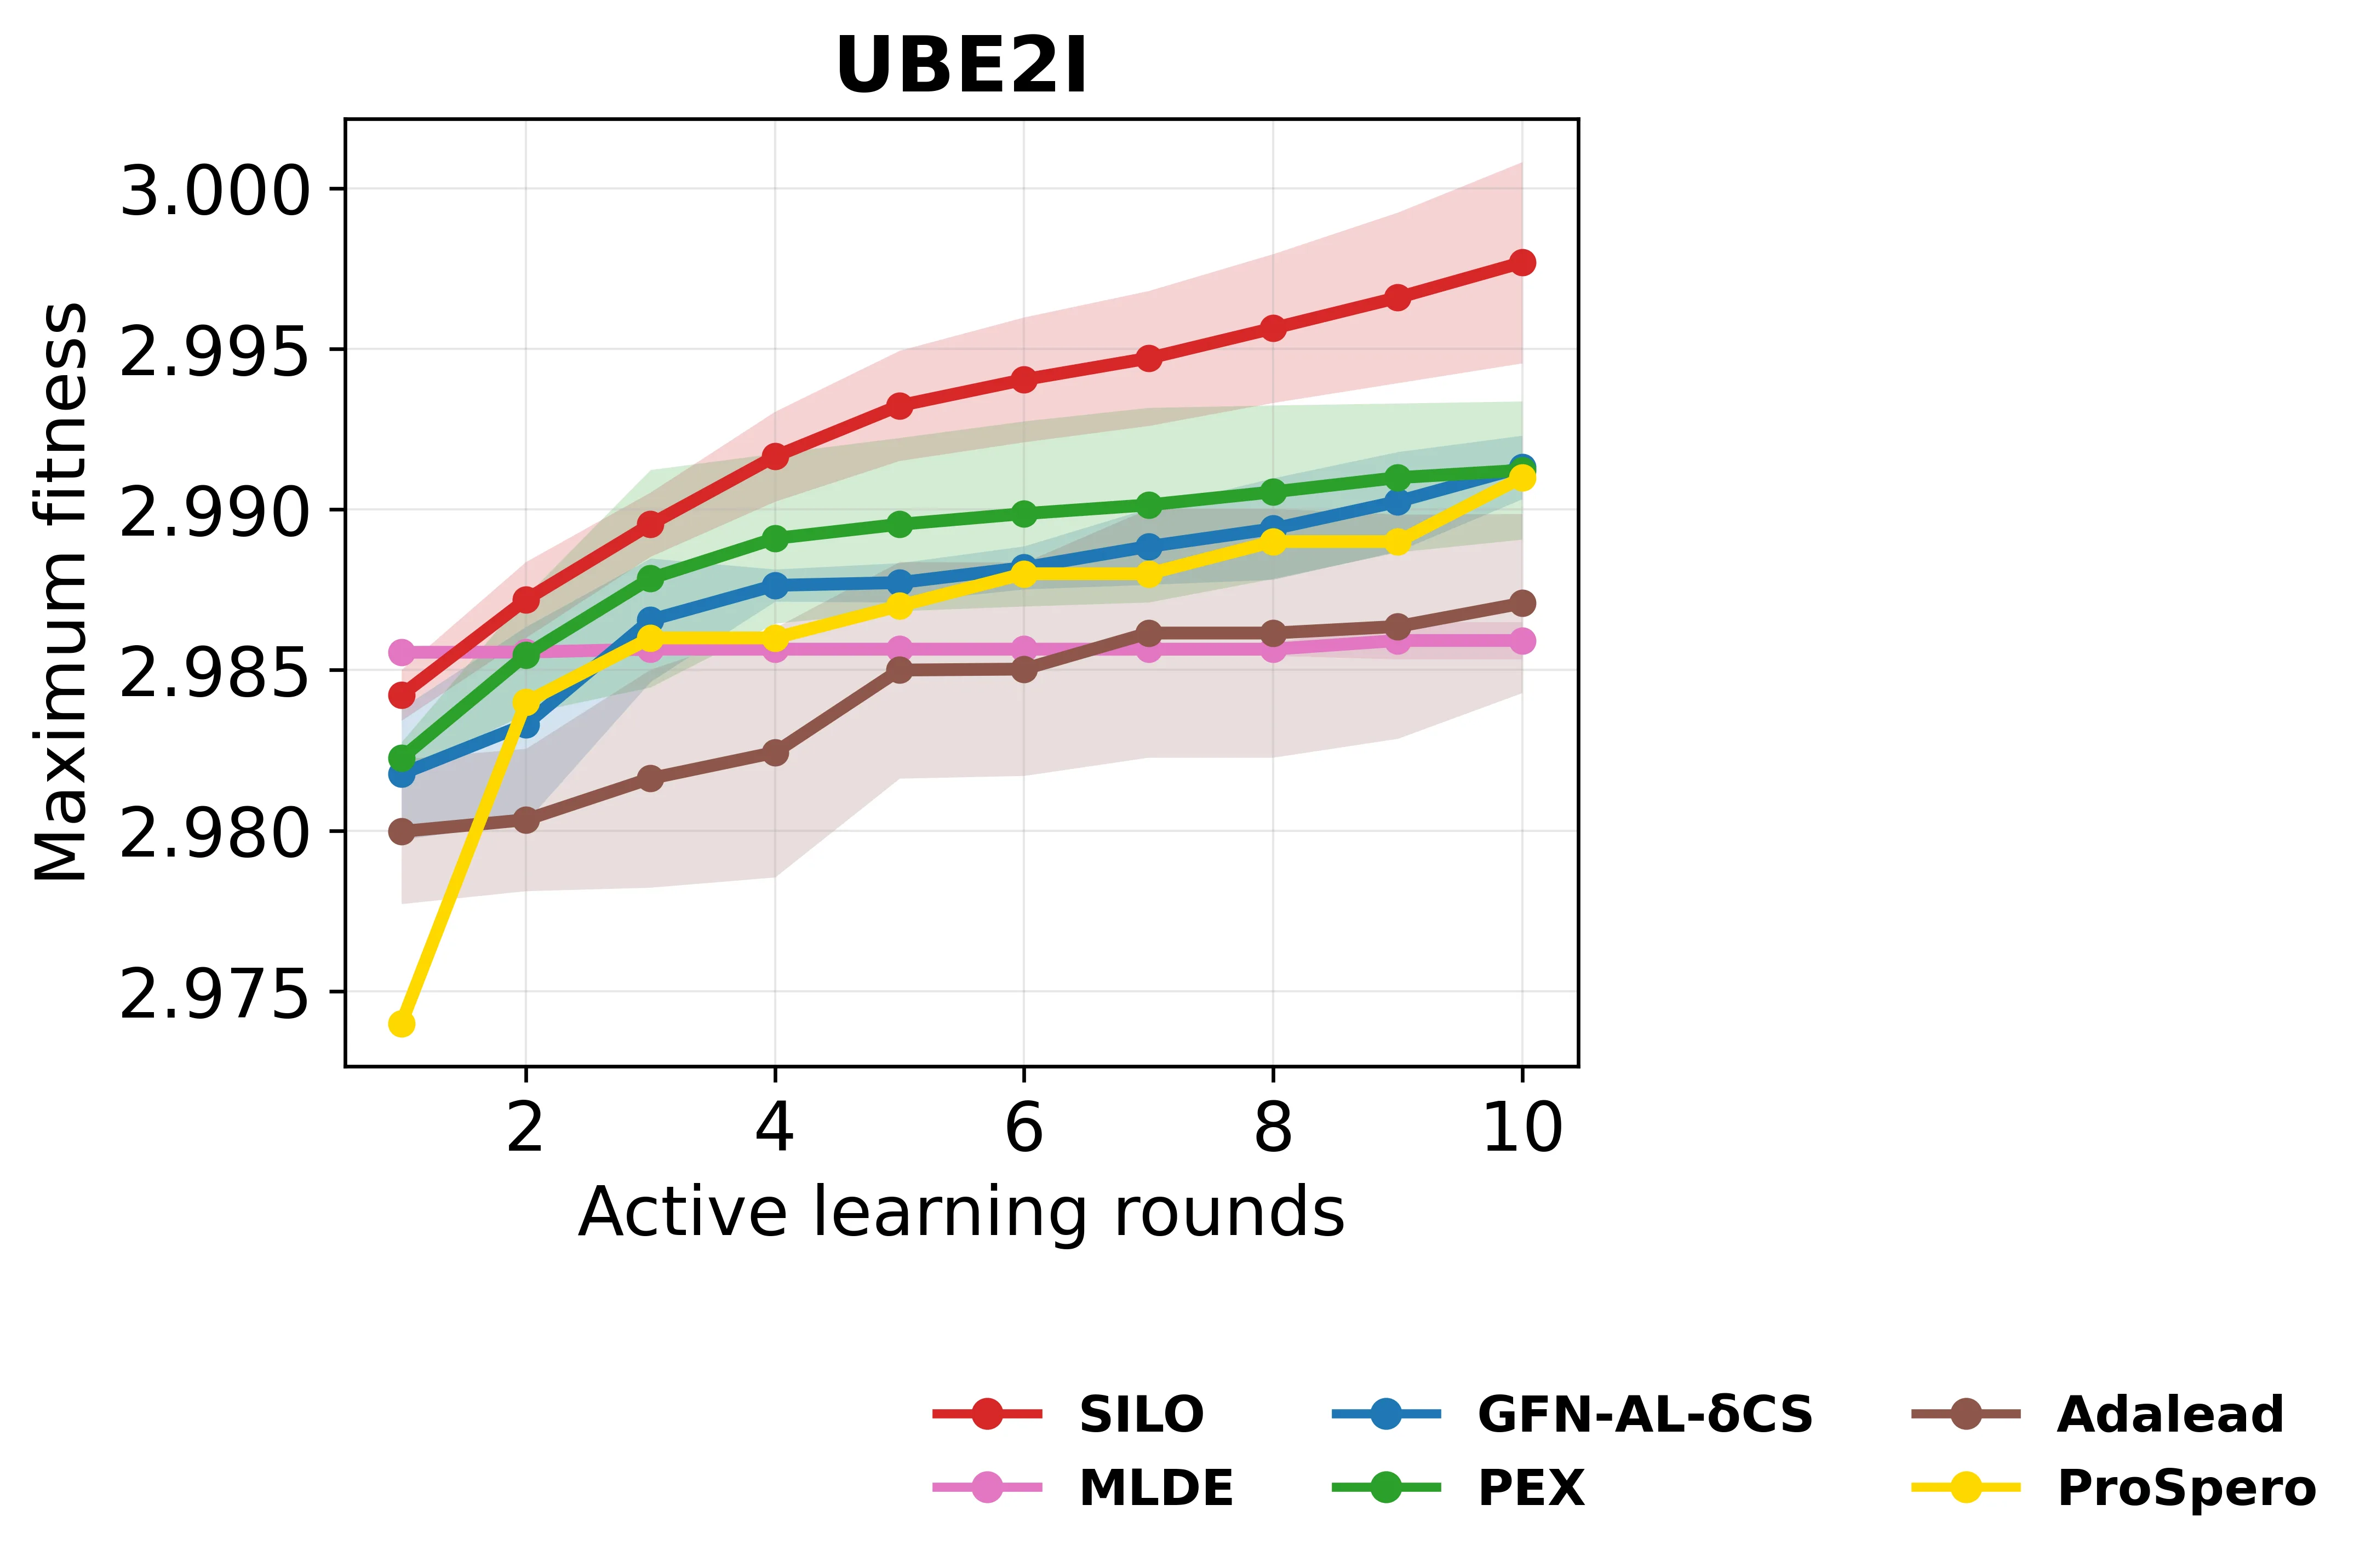
Улучшить рецепт сложного блюда — дело тонкое, особенно если пробовать можно лишь несколько вариантов в день. Менять ингредиенты наугад рискованно: уберёшь соль или разрыхлитель — и основа испорчена. Похожая история с белками: случайные мутации часто ломают жизненно важные части, а каждая проверка в лаборатории стоит времени и денег.
Новый подход под названием SILO действует иначе. Он разбивает каждое изменение на два шага: сначала выбирает позицию в цепочке белка, а потом — какую аминокислоту туда поставить. Это напоминает ремонт двигателя: механик не меняет все детали подряд, а ищет конкретный узел, который барахлит, и подбирает к нему подходящую запчасть. При этом SILO использует хитрый приём — «аланиновый тест»: временно заменяет позицию на простейший кирпичик (аланин), чтобы понять, насколько она важна для работы белка. Так алгоритм не трогает критически важные места.
Во время поиска SILO накапливает опыт. Каждый раунд он генерирует несколько вариантов, тестирует их в компьютерной модели и запоминает самые удачные. Затем он учится подражать этим успешным ходам, не пытаясь предсказать точную «оценку» каждого изменения — ведь такие оценки часто шумят и сбивают с толку. Этот подход похож на обучение повара: вместо того чтобы высчитывать идеальную температуру духовки по формулам, он просто повторяет движения шеф-повара, когда тот готовит лучший вариант блюда.
Итог прост: чтобы создать идеальный белок, не нужно перебирать всё подряд. Достаточно помнить свои лучшие шаги и аккуратно обходить хрупкие места — как опытный мастер, который знает свой инструмент и не портит заготовку.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2605.26690
Protein sequence optimization under tight oracle budgets requires methods that explore vast combinatorial spaces while making each evaluation informative. Existing reinforcement learning and off-policy generative approaches often degrade under surrogate noise, and position-agnostic mutation proposals risk disrupting functionally critical residues. We introduce SILO, a trajectory-level self-improvement imitation framework for oracle-budgeted protein design. SILO uses a hierarchical edit policy that decomposes each mutation into a position choice followed by a residue choice. In each active-learning round, the policy samples candidate trajectories via incremental stochastic beam search without replacement (SBS), and a UCB-based proxy ensemble, combined with an alanine-scan fitness score (AFS), selects candidates with functionally relevant edits for in silico oracle evaluation. The policy is then updated by next-action cross-entropy imitation on the round's best oracle-labeled trajectories, avoiding value-function estimation. Across eight reproduced protein fitness landscapes and five strong baselines from prior work, SILO achieves the highest maximum and top-100 mean fitness on 8 of 8 landscapes within our evaluations, often exhibiting faster early-stage improvement. In low-data and noisy-proxy stress tests on two landscapes per setting, SILO remains competitive or best when several baselines degrade. Ablations show that SBS with AFS account for much of the gains, with iterative imitation providing additional improvement. Code is available at: https://github.com/grimmlab/SILO.git
Аланиновый тест, используемый в SILO, придумали ещё в 1980-х: биологи заменяли аминокислоты на аланин одну за другой, чтобы найти «горячие точки», важные для работы белка. Это как проверять, какая кнопка в лифте сломана, нажимая их по очереди.