Медицинский 3D-сканер, который учится видеть всё и сразу экспресс
Чтобы передать форму статуи в мельчайших деталях, можно разбить её на миллионы крошечных кубиков и описывать каждый — долго, тяжело, и память компьютера трещит по швам. Именно так обычно работают с трёхмерными медицинскими снимками: КТ или МРТ — это огромный массив таких кубиков (вокселей), и чтобы создать или улучшить изображение, машине приходится перелопачивать их все.
Новый подход напоминает работу скульптора, который не лепит по кусочку, а задаёт плавные изгибы единой математической линией. Авторы создали систему, где весь объём — печень, мозг или лёгкие — описывается как непрерывная функция от координат. Достаточно подставить три числа (x, y, z) в формулу, и модель сообщит плотность ткани в этой точке. Сердце метода — компактный автокодировщик: он сначала сжимает снимок в небольшой набор ключевых признаков (как конспект лекции), а потом восстанавливает его обратно, но уже как непрерывный объект. Такой трюк позволяет избежать нарезки на перекрывающиеся куски, которая раньше была неизбежна.
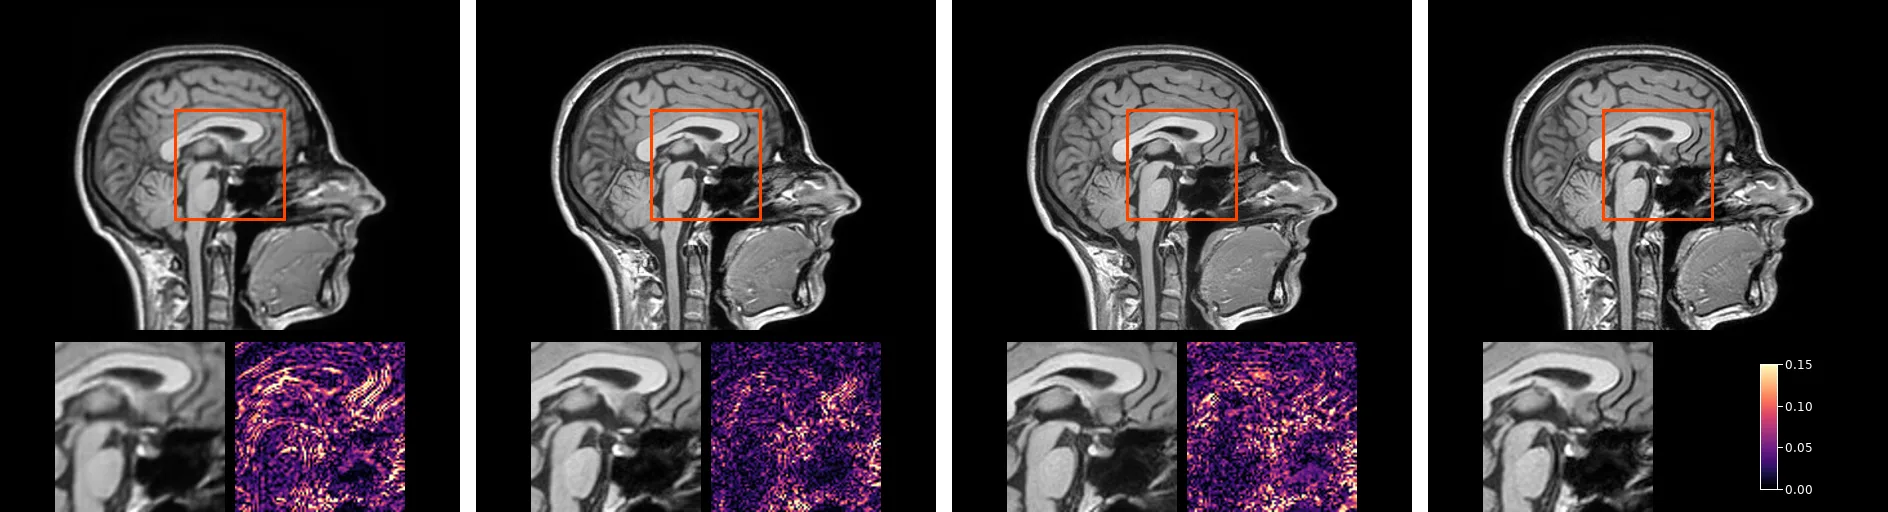
Практическая польза видна сразу в двух сценариях. Первый — создание синтетических, но анатомически правдоподобных 3D-изображений для обучения врачей или алгоритмов. Второй — восстановление качественной картинки из неполных данных. Например, при ускоренном МРТ аппарат делает меньше измерений, чтобы пациент меньше лежал в трубе, а модель достраивает пропущенное, опираясь на выученную «непрерывную» анатомию. И всё это — на одной обычной видеокарте, без сборки картинки из лоскутов с заметными швами.
Конечно, прямое попиксельное восстановление пока чуть точнее в деталях. Но выигрыш в скорости и целостности картинки — это тот компромисс, который открывает дорогу к обработке высокоразрешённых 3D-снимков в рутинной клинической практике, не дожидаясь суперкомпьютеров. И тогда статуя, собранная когда-то по кубикам, наконец обретёт плавные, живые очертания.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2607.16491
High-resolution three-dimensional (3-D) medical diffusion models remain constrained by the cost of processing full volumes, even when denoising is performed in a compact latent space. We introduce a continuous 3-D latent diffusion model (LDM) framework for computed tomography (CT) and magnetic resonance imaging (MRI) generation and measurement-guided reconstruction. Its central component is a compact autoencoder (AE) with a coordinate-conditioned local implicit image function (LIIF) decoder that represents a volume as a continuous function of spatial coordinates. By evaluating the convolutional decoder once on the latent grid and restricting repeated computation to a lightweight implicit head, the proposed design avoids overlapping sub-volume decoding while remaining differentiable for inverse-problem optimization. We evaluate the framework on CT volumes of 512^3 voxels and MRI volumes of 256^3 voxels. On high-resolution CT, the proposed AE is approximately x12-32 faster than the evaluated reference autoencoders, achieves the lowest peak graphics processing unit (GPU) memory use, and retains comparable structural fidelity despite a moderate reduction in voxel-level accuracy. The resulting frozen 3-D latent prior generates coherent full volumes without visible patch seams and can be applied, without task-specific retraining, to sparse-view CT and accelerated MRI reconstruction through hard data consistency. Although direct pixel-domain reconstruction remains more accurate, the results demonstrate that a single volumetric latent prior can support both unconditional generation and measurement-conditioned reconstruction on one GPU. Overall, the framework provides a practical trade-off between continuous volumetric decoding, computational efficiency, and fine-detail preservation. Our code will be made available at https://github.com/mellak/.
Размер типичного КТ-снимка высокого разрешения (512×512×512 вокселей) сопоставим с 134 миллионами пикселей — примерно как 17 кадров в формате 4K, упакованных в один куб.
В фильме «Вспомнить всё» герой Арнольда Шварценеггера проходит через сканер, мгновенно создающий трёхмерный голографический слепок тела — новая модель делает шаг к тому, чтобы подобная реконструкция стала рутиной, а не фантастикой.