مرساة جينية للصحة سريع
اشتريت ميزان مطبخ جديدًا، لكنه بدلاً من الوزن الدقيق يعرض فقط الانحراف عن «المعيار» ما. لمعرفة وزن التفاحة، عليك أولاً وزن عشرات التفاحات الأخرى وحساب المتوسط. هكذا تعمل أنظمة مراقبة الصحة اليوم: تجمع بيانات عن النبض وضغط الدم والنوم لأسابيع لتفهم ما هو معتاد بالنسبة لك وما هو انحراف. هذه هي مشكلة البداية الباردة — النموذج لا يعرفك حتى يجمع ملاحظات كافية.
في العمل الجديد، يقترح العلماء عدم الانتظار لأسابيع، بل إعطاء النظام «ورقة غش» فورًا — ملفك الجيني. الجينات لا تتغير بسبب الإجهاد أو قلة النوم، إنها مثل أساس المنزل الذي وُضع عند البناء. يبني الباحثون على هذا الأساس نقطة مرجعية شخصية: يأخذون مئات المتغيرات الجينية المعروفة (تلك التي تربطها الدراسات الكبيرة بضغط الدم وإيقاع القلب والتمثيل الغذائي) ويحسبون مستوى النبض أو السكر في الدم «المبرمج» خصيصًا لك. هذا ليس حكمًا صارمًا، بل فرضية بداية يتم تحسينها مع كل قياس جديد.
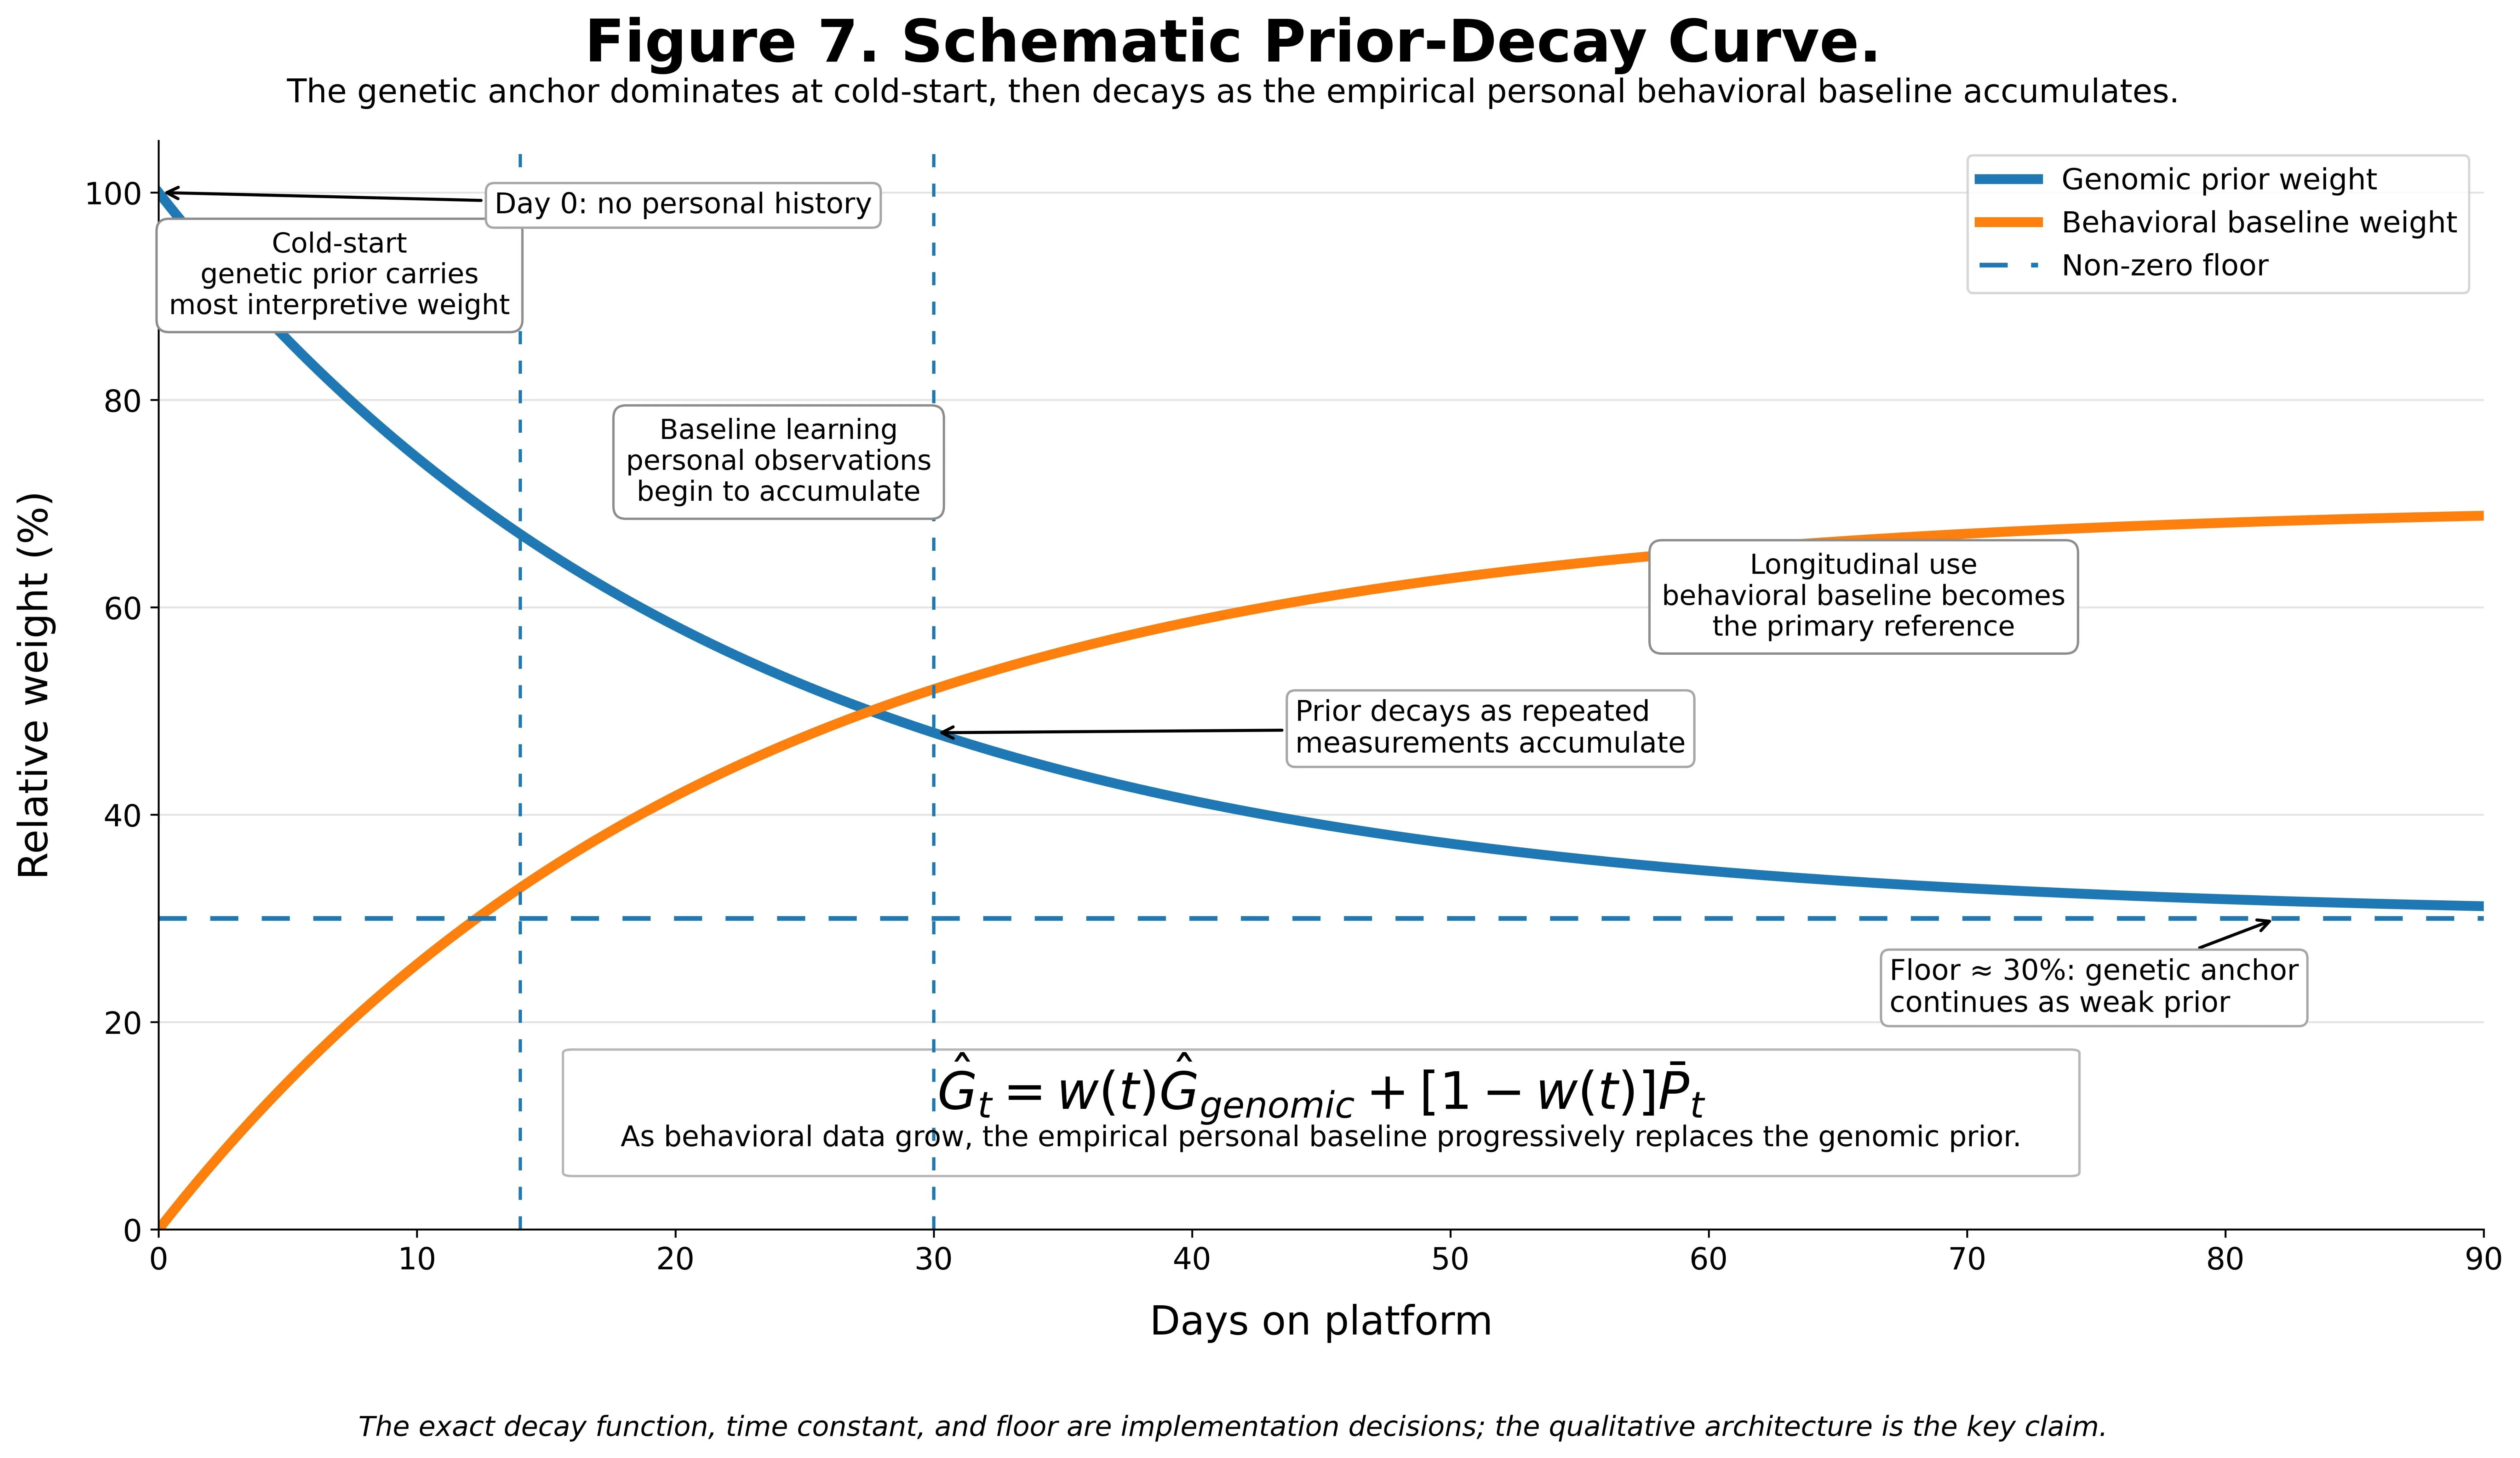
مع تدفق البيانات الحقيقية، تفقد «ورقة الغش» الجينية وزنها تدريجيًا، تاركة المجال للملاحظات الحية. الصيغة بسيطة: في البداية يعتمد النظام بشكل شبه كامل على التوقع الجيني، وبعد أسبوعين — على ما قاسه سوار اللياقة. ولكن حتى في النهاية، لا تختفي المرساة الجينية تمامًا — إنها مثل صديق قديم يعرفك منذ الولادة ويساعدك على عدم الخلط بين الزكام المؤقت والسمة المزمنة. هذا النهج تم اختباره بالفعل على ستة مؤشرات فسيولوجية، من إيقاع القلب إلى مستوى السكر، ويستخدم فقط الجينات الأكثر موثوقية والمتحقق منها مرارًا، وليس «جينات العدوانية» أو «جينات السعادة» المشكوك فيها.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2606.13556
Personalized health AI systems face a fundamental cold-start problem: machine learning models for physiological interpretation require weeks of individual behavioral data before they can distinguish constitutional variation from environmentally driven deviation. We propose a solution grounded in causal inference and Bayesian prior design. An individual's genomic profile serves as an exogenous genetic anchor -- a domain-informed, personalized prior that is fixed at conception, immune to reverse causation, and available before a single behavioral observation is collected. The anchor initializes a Bayesian belief state over an individual's physiological set point G-hat = mu + sum(beta_i * g_i), where beta_i are GWAS-derived effect sizes and g_i are risk-allele counts. Each incoming physiological measurement P produces a non-constitutional deviation delta = P - G-hat that separates the signal attributable to environment and state from the constitutionally fixed baseline. As behavioral data accrue, the prior decays according to G-hat_t = w(t)*G-hat_genomic + [1-w(t)]*P-bar_t, transitioning from genome-dominated to empirical-baseline-dominated inference. The same observed HRV of 55 ms generates a suppression hypothesis for a person whose prior predicts 80 ms, and an enhancement hypothesis for a person whose prior predicts 30 ms -- a reversal impossible without a personalized anchor. We develop this architecture across six physiological domains, grading genomic priors by evidence strength, distinguishing robustly replicated anchors (FTO, FADS1/2, FKBP5) from contested candidate genes (SLC6A4, MAOA, DRD2). We address the inference boundary between association, Mendelian randomization, and individual token causation, and define four constraints for deployment: evidence-graded priors, dynamic decay, ancestry-matched effect sizes, and attribution rather than deterministic output.
الفرق بين النبض المتوقع جينيًا والفعلي يمكن أن يخبرنا عن الإجهاد أكثر من النبض نفسه — كما لو كان الميزان لا يعرض فقط «70 كجم»، بل «زائد 2 كجم بعد العشاء».
في مسلسل «الكربون المعدل» يمكن نقل الشخصية إلى جسد جديد، لكن المرساة الجينية ستجعل هذه التقنية أكثر تعقيدًا: «المعيار» الخاص بك مرتبط بالحمض النووي، وليس بالوعي.