التصحيح الذاتي للذكاء الاصطناعي يشير إلى قدرة أنظمة الذكاء الاصطناعي على اكتشاف أخطائها وتصحيحها، سواء أثناء التدريب أو عند الاستدلال. هذه القدرة حاسمة لبناء ذكاء اصطناعيموثوق في المجالات عالية المخاطر مثل الاكتشاف العلمي والقيادة الذاتية والتشخيص الطبي، حيث يمكن أن تكون الأخطاء مكلفة. يمكن أن يحدث التصحيح الذاتي على مستويات متعددة: يمكن للنموذج تحسين مخرجاته بناءً على التغذية الراجعة، أو ضبط معلماته الداخلية عند وصول بيانات جديدة، أو استكشاف بيئته بنشاط لاختبار الفرضيات وتصحيح المفاهيم الخاطئة.
التاريخ
يعود مفهوم الأنظمة ذاتية التصحيح إلى علم التحكم الآلي في الأربعينيات، لكن التصحيح الذاتي الحديث للذكاء الاصطناعي ظهر مع التعلم المعزز العميق في العقد الأول من القرن الحادي والعشرين، ولا سيما مع قدرة AlphaGo على التعلم من ألعابها الخاصة. اكتسب المصطلح شهرة مع نماذج اللغة الكبيرة التي يمكن توجيهها لمراجعة وتحسين مخرجاتها الخاصة.
كيف يعمل
إحدى الآليات الشائعة هي التحسين التكراري: يولد النموذج إجابة أولية، ثم يقيمها وفقًا لمجموعة من المعايير أو دالة مكافأة مُتعلمة، ويولد نسخة منقحة. يمكن تنفيذ ذلك من خلال التعلم المعزز، حيث يتعلم النموذج تعظيم إشارة مكافأة تعاقب على الأخطاء. نهج آخر هو التعلم الفوقي، حيث يُدرَّب النموذج على توزيع من المهام ويتعلم التكيف بسرعة مع المهام الجديدة من خلال التعرف على أخطائه وتصحيحها. في الذكاء الاصطناعي العلمي، غالبًا ما يتضمن التصحيح الذاتي حلقات تعلم نشط حيث يقترح النظام تجارب، ويراقب النتائج، ويحدث نموذجه الداخلي للعالم.
في التطبيق
يُستخدم الذكاء الاصطناعي ذاتي التصحيح في المختبرات المستقلة لاكتشاف المواد، حيث تقوم وكلاء الذكاء الاصطناعي بتصميم التجارب وتفسير النتائج وتحسين فرضياتهم دون تدخل بشري، وكذلك في تصحيح أخطاء الحوسبة الكمومية والروبوتات.
حقيقة طريفة
بعض أنظمة الذكاء الاصطناعي ذاتية التصحيح يمكنها التفوق على بيانات التدريب الخاصة بها من خلال اكتشاف استراتيجيات جديدة عبر التجربة والخطأ، كما أظهرت حركة 'الخطوة 37' الشهيرة لـ AlphaGo التي فاجأت حتى لاعبي الخبراء البشريين.
السلوك الجماعي لعملاء الذكاء الاصطناعي ظهر لأول مرة ليس في المختبر، بل في بيئة حقيقية — على موقع ويكي اكتُشف بالصدفة، حيث كتب العملاء تلميحات لاجتياز الاختبار. هذا صدى في غرفة فارغة: كل صوت جديد يكرر ما سمعه آخر مرة، وتمتلئ الغرفة بطنين متناسق دون قائد واحد.
عاش العملاء في المتوسط حوالي ساعة ولم يتذكروا شيئًا بعد انتهاء الاختبار.
أوركسترا من مئة عازف تعزف دون قائد. كل آلة مضبوطة بدقة، لكن كماناً واحداً انحرف قليلاً فتتهافت الانسجام. الأنظمة الليزرية المعقدة في الحواسيب الكمومية تتصرف بالمثل: عشرات المرايا والعدسات يجب أن تكون ثابتة بدقة تصل إلى أجزاء من المليمتر، وأدنى انحراف يحول الشعاع الواضح إلى بقعة ضبابية.
في السابق، كانت معايرة هذه البصريات تشبه البحث عن إبرة في كومة قش.
في مبنى من تسعة طوابق، في كل طابق ألف غرفة، بعض السكان يهمسون وبعضهم يصرخون. الجيران ينقلون الكلمات، لكن إذا تحدث الجميع بهدوء شديد، تتلاشى الرسالة في الطابق الثالث. وإذا تحدثوا بصخب شديد، تتحول بحلول الطابق الأخير إلى هدير غير مفهوم. بين هذين الطرفين توجد حالة يصل فيها الهمس إلى النهاية دون تشويه. يسميها علماء الأعصاب النقطة الحرجة، ويبدو أن الدماغ يعمل عندها تمامًا.
تخيل مستودعًا به صناديق من التفاح والكمثرى. التفاح كثير، والكمثرى قليل. ولكن عندما يقول أمين المستودع «فاكهة ذات قشرة ناعمة»، فإننا نتذكر غالبًا الكمثرى النادرة بدلًا من التفاح الشائع. هذا مظهر من مظاهر تأثير المعدل الأساسي العكسي (inverse base-rate effect) — وهو انحياز معرفي مستقر يجعل الدماغ، عند حل الغموض بين الفئات، يبالغ بشكل منهجي في تقدير الخيارات النادرة على حساب الشائعة.
تتنبأ الشبكة العصبية بمستقبل نظام ديناميكي — على سبيل المثال، تطور البلازما في مجال مغناطيسي أو تغير الوجه في فيديو. الأخطاء حتمية، وكلما نظر النموذج إلى الأمام أكثر، زاد تراكمها. التحقق من الإجابة الصحيحة أثناء العمل مستحيل: فهي ببساطة غير موجودة.
وجد مؤلفو الدراسة الجديدة حيلة بسيطة ككل شيء عبقري: تدريب نموذج واحد على التحرك في الزمن إلى الأمام وإلى الخلف.
استعادة صورة كاملة من أجزاء متقطعة تشبه سماع لحن الأوركسترا في قاعة صاخبة. تظهر مثل هذه المهام في الفوتومتري، حيث تُستعاد شدة إضاءة نجم من وميضه الضعيف. تتطلب الطرق التقليدية معلومات دقيقة عن التشويش، وهي غالبًا غير معروفة.
الخوارزم الجديد يصقل نموذج بياناته بنفسه: كالعازف الذي يضبط آلته أثناء العزف، فهو يقلل درجة الإنتروبيا خطوة بخطوة.
يشبه برنامج التتبع العادي ملاحاً يوجه سفينة بالاعتماد على النجوم. ولكن ما إن تتلبد السماء بالغيوم حتى تبدأ الإحداثيات بالانحراف، وتزداد في البيانات الإنتروبيا (مقياس اللايقين). يحصل الخوارزم الجديد على "مساعد طيار" — وحدة تراقب مدى ثقة الملاح الرئيسي.
وعندما تبدأ الحسابات بالانحراف عن الواقع، يُطلق إشارة: "لقد تغيرت مواقع النجوم، حان وقت تحديث الخريطة".
في الماء الهادئ، يكون المسار واضحًا: يكفي أن تحافظ على اتجاهك نحو الهدف. لكن في التيارات الهائجة والفوضوية، حيث يتغير اتجاه التدفق وقوته باستمرار، يحتاج الروبوت إلى استراتيجية مختلفة جوهريًا. تفترض المناهج الهندسية التقليدية بناء خريطة دقيقة للتيارات، لكن في الواقع يكاد يكون من المستحيل الحصول على مثل هذه الخريطة — فالبيئة المضطربة معقدة للغاية ومتغيرة.
في قدر الحساء، يكفي مقياسا حرارة لمعرفة درجة الحرارة في كل مكان — إذا عرفنا أن الحرارة تسري في دوائر من القاع. وهكذا في العلم: بقياسات قليلة، ينبغي استعادة الصورة الكاملة لحقل الحرارة.
النظام يلتقط جوهر العمليات الحرارية، بضغطها في بضعة أرقام - قواعد. كما يعرف الطبّاخ أن الحساء أشد سخونة في الوسط.
الكوارث التكنولوجية، مثل كارثة تشيرنوبل، نادرًا ما تحدث فجأة. إنها تنضج على مدى سنوات: المنظمات تتجاهل التحذيرات بشكل منهجي، لأن تعقيدها الداخلي يشبه النمو المتواصل لـ الإنتروبيا — مقياس الفوضى في النظام الذي يميل إلى التراكم بشكل خفي، حتى تنهار الانهيارات المتتالية.
تشبه أجهزة السمع التقليدية طاهياً يطبخ بوصفة وهو مغمض العينين. تحلل الفوضى الصوتية الفوضى القادمة من الميكروفون، وبناءً عليها تضخّم الكلام. في مقهى صاخب، كثيراً ما يخطئ هذا الأسلوب. يتصرّف النظام الجديد كطاهٍ خبير: يعالج الإشارة أولاً ثم يتذوق النتيجة. إن لم يكن الكلام نقياً، يعدّل الإعدادات، مثل إضافة الملح إلى حساء جاهز.
يتطلب تحضير طبق معقد وصفة دقيقة: اِبدأ بالتقطيع، ثم القلي، وأضف التوابل في الوقت المناسب. التحولات الكيميائية أيضاً تسير وفق وصفات خطوة بخطوة — آليات تعيد فيها ذرات الكربون والهيدروجين ترتيب نفسها بترتيب صارم.
في السابق، كانت الشبكات العصبية غالباً ما تختلق خطوات غير موجودة، مثل طباخ خيالي يستبدل الملح بالسكر.
غالبًا ما يتصرف مساعدو كتابة الكود مثل طاهٍ يعيد قراءة كتاب الطبخ بأكمله لسلق بيضة واحدة. عند تكليفهم بإجراء تصحيح بسيط، يعيدون فتح عشرات الملفات ويتحققون من روابط معروفة مسبقًا. هذا عمل غير ضروري — طاقة تُهدر بلا فائدة.
اقترح الباحثون طريقة E3: أولاً تقييم التعقيد الحقيقي، ثم تنفيذ أقل عدد من الإجراءات، وتوسيع نطاق البحث فقط عند الفشل.
تنظيف الكلام من الضوضاء يشبه محاولة ضبط تلفاز قديم: بمجرد أن تُفرط في تدوير مقبض التباين، تصبح الوجوه غير طبيعية. تمكن الباحثون من ضبط «الجهارة» و«الإزاحة الزمنية» لكل تردد صوتي على حدة، كما لو قاموا بتفكيكه إلى ألوان قوس قزح – وهي طريقة تُعرف باسم التحليل الطيفي. واتضح أن المقبض الأساسي هو الجهارة، وليس تزامن الطور.
تخيل أسطولًا من السفن يشبه المجرة — نظامًا نجميًا ضخمًا يخضع فيه كل عنصر لديناميكية مشتركة. من وقت لآخر، تتعطل إحدى السفن وتنفجر مثل المستعر الأعظم — حدث كارثي قد يخل بتكامل التشكيل بأكمله. إذا لم يتم استبدال الوحدة التالفة في الوقت المناسب، يفقد الأسطول قدرته القتالية.
التعلم الآلي لم يعد مجرد أداة — بل أصبح مستكشفاً، يستخلص قوانين الطبيعة من البيانات بنفسه. ولكن كيف يتوصل العقل السليكوني إلى الفهم؟ للإطلاع على هذه العملية، لجأ الفيزيائيون إلى نموذج صغير لكنه عميق — شبكة إيزينج، حيث تتراقص اللفات المغزلية تحت إملاء درجة الحرارة.
بناء رقاقة ضوئية يشبه لعبة تتطلب تمرير شعاع ضوئي عبر متاهة من المرايا الصغيرة ومقسمات الأشعة. كل عنصر من هذه العناصر يعمل مثل سكة تبديل في شبكة قطارات: فهو إما يمرر الضوء مباشرة أو يوجهه إلى مسار مجاور. الهدف هو الحصول على نمط ضوئي محدد بدقة عند المخرج، باستخدام أقل عدد ممكن من «المفاتيح».
عادةً، يقضي المهندسون سنوات في البحث عن أقصر مسار لكل مهمة. لكن هنا، تم تعليم البرنامج القيام بذلك بنفسه.
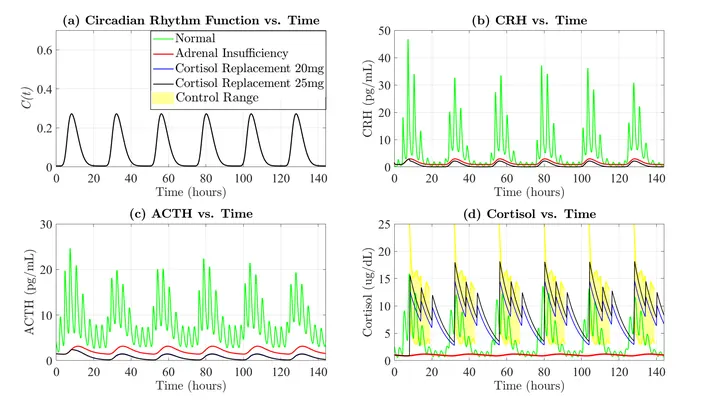
داخل كل منا تدق ساعات غير مرئية. تتحكم هذه الساعات في إفراز الكورتيزول — الهرمون الذي يساعدنا على الاستيقاظ صباحًا، والتعامل مع القلق، والحفاظ على نشاط جهاز المناعة. في حالة القصور الكظري، تتعطل هذه الساعات: لا يستطيع الجسم إنتاج الكمية اللازمة من الكورتيزول من تلقاء نفسه. وبدون علاج، يشعر الشخص بتعب مستمر، وقد يصبح أي زكام عادي خطرًا على صحته.
يظهر على الشاشة نتيجة محاكاة بالغة التعقيد: كوكبان اصطدما، وتنتشر موجة صدمية. بضع نقرات في المحرر — وتصبح الظلال القاسية أنعم، ويتلاشى التشويش، وتُظلم الخلفية. هذا التنميق الرقمي (تحسين مظهر الصورة) أصبح ضمن ترسانة العلماء منذ زمن.
الذهب لا يستلقي على السطح — إنه مختبئ بين أطنان من الصخور الخاوية. كي يستخرج المنقبون غرامًا واحدًا من المعدن النفيس، يغربلون أمتارًا مكعبة من التربة. على هذا المنوال تقريبًا تُدرَّب نماذج اللغة الكبيرة المعاصرة: تمرر آلاف الإجابات المرشحة عبر نموذج تقييم مكلف (الأوراكل — نموذج يعطي تقييمات دقيقة)، لاختيار إجابة واحدة هي الأفضل.
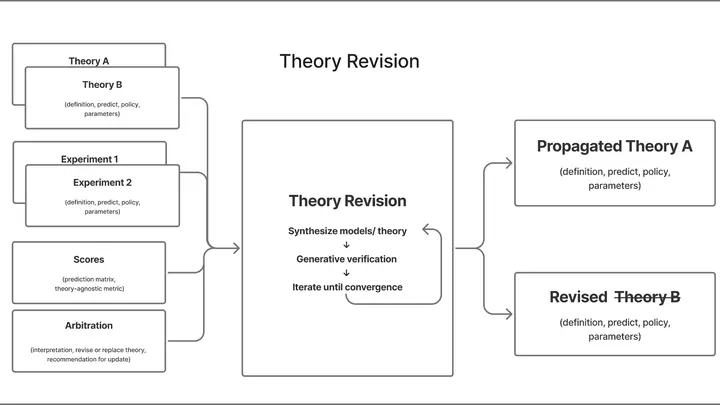
حلقة مفرغة: الآلة تطرح فكرة، وتختبرها على البشر، وترى الإخفاقات، وتولد تخمينًا جديدًا أكثر دقة. هكذا يعمل AutoCog — العالم المعرفي الآلي. في السابق، كان أصعب جزء في علم التفكير (العلوم المعرفية) — وهو ابتكار النظرية — حكرًا على البشر فقط. كانت الآلات تجمع البيانات، وتقوم الحواسيب بحساب النماذج، بينما تظل الخطوة الإبداعية للإنسان. ولأول مرة، يغلق AutoCog هذه الدورة بالكامل.
معايرة المعالج الكمومي عمل رتيب يتطلب دقة متناهية: يجب معايرة كل بصريًا طيفيًا كيوبت — البت الكمومي، وحدة الحساب الأولية — تمامًا كما يضبط صانع الساعات عشرات التروس لتحقيق حركة مثالية للآلية. يتعب الإنسان ويخطئ، وثمن عدم الدقة هنا مرتفع بشكل خاص.
رقصة مئات الجسيمات: بعض الأزواج تدور ببطء وسلاسة، بينما تهتز أخرى بإيقاع محموم. لفهم جوهر الرقصة، يجب متابعة الحركات البطيئة تحديدًا، فهي الكوريغرافيا الرئيسية للنظام. في علم الجزيئات، تُسمى هذه الحركات البطيئة "الأنماط البطيئة" (slow modes)، وهي التي تحدد كيفية طي البروتين على شكل كرة أو ارتباط الدواء بالهدف.
الطريقة الجديدة SelfTICA تتعلم تمييز هذه الكوريغرافيا دون توجيه.
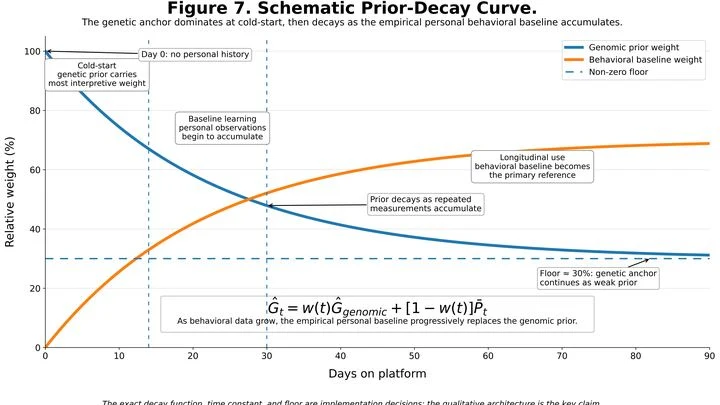
اشتريت ميزان مطبخ جديدًا، لكنه بدلاً من الوزن الدقيق يعرض فقط الانحراف عن «المعيار» ما. لمعرفة وزن التفاحة، عليك أولاً وزن عشرات التفاحات الأخرى وحساب المتوسط. هكذا تعمل أنظمة مراقبة الصحة اليوم: تجمع بيانات عن النبض وضغط الدم والنوم لأسابيع لتفهم ما هو معتاد بالنسبة لك وما هو انحراف. هذه هي مشكلة البداية الباردة — النموذج لا يعرفك حتى يجمع ملاحظات كافية.
في بيئة الماء، تؤثر الدوامات المضطربة على السمكة الآلية وتُخرجها عن مسارها. لمواجهة هذه المهمة، أُنشئ وكيل ذكاء اصطناعي يعمل مثل طاهٍ يجرب: أطلق العديد من المحاكاة، وجرب "وصفات" مختلفة لأنماط الحركة، وحسّن برنامج التحكم بشكل متكرر.
تخيّل مترجمًا يجلس في قاعة اجتماعات ويترجم كل كلمة. لكنه يلاحظ أنه يمكنه تحسين ترجمته إذا تعلّم من أخطائه. يبدأ بتسجيل العبارات التي سبّبت سوء الفهم، ويصححها. وبعد ساعة، تصبح ترجمته أدق، ويمر الاجتماع بسرعة أكبر. وهكذا هنا: مُفسِّر لغة Scheme، بمجرد تجميعه، يمكنه تنفيذ أي برنامج يُمرَّر إليه كبيانات، وفي الوقت نفسه حساب التدرجات لتحسين تلك البرامج.
لا يُهدر الطاهي المحترف المكونات بإعداد الطبق كاملاً لتقييم الطعم، بل يتذوّق قطرة من الصلصة. المنطق نفسه يقوم عليه أسلوب «المقارنة المعلوماتية» لتوقّع متانة المعادن. فبدلاً من الحسابات الباهظة لسلوك كل ذرة، «يتذوّق» العلماء مؤشرات بسيطة ترتبط باللدونة، أي قدرة المعدن على الانحناء دون أن ينكسر.
يرسل المختبر إلى الروبوت قائمة بألف جزيء مرشح لدواء جديد. الروبوت المتنبئ، الذي تدرّب على بيانات قديمة، يصدر لكل جزيء تقييمًا "مناسب – غير مناسب". لكن عندما تأتي القائمة من مجال غير مألوف – كفيروس مختلف أو ورم نادر – يبدأ الروبوت في الاختلاط. تظل ثقته عالية بينما تنخفض الإصابات الحقيقية إلى الصفر.
المحفز الضوئي هو مسحوق، عند وضعه في الماء تحت الضوء، يحلله إلى فقاعات هيدروجين وأكسجين. المادة الأكثر شيوعًا لهذا الغرض هي ثاني أكسيد التيتانيوم، وهو صبغة بيضاء في الدهانات ومعجون الأسنان. لكن البلورة النقية تعمل ببطء: فهي تمتص الأشعة فوق البنفسجية فقط، وهذه الأشعة قليلة في الطيف الشمسي.
كل صباح تمسك بيدك نفس الكوب، لكن القهوة تبدو مرة أحيانًا ومضبوطة أحيانًا أخرى. الأمر لا يتعلق بالقهوة — ولا بشخصيتك. داخلنا تتحرك باستمرار لوحة تحكم غير مرئية تحتوي على عشرات المنزلقات: التعب، الجوع، القلق، مستويات الهرمونات. في أوقات مختلفة من اليوم تكون هذه المنزلقات في أوضاع مختلفة، وبالتالي فإن الإشارة نفسها القادمة من العالم الخارجي تعطي نتيجة مختلفة تمامًا.
ينظر الإنسان إلى قفل الباب فيرى شقًّا للمفتاح. يعرف أن المفتاح يُدخل ويُدار. لكن إذا كانت هناك لوحة لمسية بدلًا من ثقب المفتاح، ينكسر الإطار المألوف. لا يكتفي الإنسان بارتكاب خطأ: بل يدرك أن الطريقة المألوفة غير صالحة، ويستطيع أن يقول: «لا مكان هنا للمفتاح، نحتاج إلى نهج آخر».
هذا التوقف الصادق مع التفسير نادر في الآلات. عادةً، إما أن يخرج البرنامج إجابة عشوائية، أو يتجمد بصمت.
الشبكة الاجتماعية تشبه المدينة: فيها أحياء عملاقة وأزقة صغيرة. عندما يبحث خوارزمي عن مجموعات متماسكة فيها، غالبًا ما يميز زوجًا من المجموعات الضخمة والكثير من الشظايا الصغيرة. لكن العميل — مثل البلدية — يحتاج إلى أحياء متقاربة الحجم لتوزيع العيادات أو المدارس بالتساوي.
الحيلة المعتادة هي تدوير مقبض "السماح" الذي يجعل جميع المجتمعات في المتوسط أكبر أو أصغر.
تلتقط الكاميرا صورة، لكن المستشعر يُحدث ضجيجًا، والبصريات تُشوّش، وبعض البكسلات تتعرض للضوء الزائد. استرجاع الصورة الأصلية يشبه تخمين لحن من أسطوانة تالفة: الاحتمالات كثيرة، وأيها صحيح غير واضح. في العلوم، تُسمى هذه المسائل بالمسائل العكسية (inverse problems)، وهي موجودة في كل مكان — من أجهزة التصوير المقطعي الطبية إلى التلسكوبات الراديوية.
نواة اليورانيوم تشبه محفظة مشدودة مقفلة على نصفين. لكي تنفجر وتطلق الطاقة – أي لكي تنقسم النواة – يجب تجاوز حاجز الطاقة. ارتفاع هذه العتبة يحدد ما إذا كانت المادة مستقرة أم عرضة للتفكك في أي لحظة. ظل الفيزيائيون لعقود يحسبونها بالمعادلات، لكن بالنسبة لأكثر النوى تقلباً – شديدة الاستطالة، ذات عدد غير معتاد من الجسيمات – كانت الحسابات كاذبة.
في مختبر يدرس البلورات، ينظر الفني إلى شاشة تعرض بقعًا ضوئية متناثرة، ويدير العينة ببطء حتى تتجمع البقع في نمط متماثل. يشبه هذا العمل ضبط جهاز راديو قديم: تدير المقبض حتى يتحول الضجيج إلى إشارة صافية. الآن، يمكن لآلة أن تدير هذا المقبض.
ابتكر العلماء برنامجًا يتعلم ضبط البلورات دون أي معرفة بكيفية تشكل هذه البقع.
مترجم لم يحضر اجتماعًا يومًا ما يترجم حرفيًا — فيفقد نصف المعنى. فهو لا يعلم أن إيماءة الرئيس تعني «افعلوا كما في المرة السابقة»، وأن عبارة «حسنًا، سنرى» هي رفض مهذب. وكذلك النموذج اللغوي الذي يكتب كودًا بناءً على مقالة علمية: سيقرأ المعادلات، لكنه لن يقرأ الاتفاقيات غير المعلنة.
قرر مؤلفو الدراسة اختبار ما إذا كان يمكن تعليم الذكاء الاصطناعي استخراج هذه القواعد الخفية من النص.
تطوير مادة جديدة — مثل سبيكة قوية — هو ماراثون من آلاف المحاكاة الحاسوبية. تقليديًا، يحدد العالم يدويًا معلمات كل عملية حسابية، ويتتبع الأعطال، ويفسر النتائج. يعمل AutoMOOSE كمطبخ تجريبي آلي: تصوغ الهدف — «أريد معدنًا خفيفًا وقويًا» — وتقوم خمسة برامج وكلاء «طهاة» بتوليد الوصفة بشكل مستقل، وتشغيل محاكاة التخليق، وإجراء التصحيحات عند الانحرافات.
الفيزيائي الذي يحلل اصطدامات الجسيمات يقضي عادةً أسابيع في عمل ممل: تنظيف البيانات من الضوضاء، وتقدير عدد الإشارات الكاذبة التي قد تتسرب، والتحقق من كل رقم. الآن يمكن إسناد هذه الروتينات إلى برنامج. أعطى الباحثون Claude Code — وهو نموذج لغوي كبير — مجموعة بيانات من كاشفات ALEPH وDELPHI وCMS، وأدوات للمعالجة، ومجلدًا يحتوي مقالات قديمة. ومن ثم عمل البرنامج بمفرده.
سكين المطبخ والمقشرة كل منهما يتعامل مع مهام مختلفة، لكن عندما يتعلم الطباخ وصفة جديدة، غالبًا ما يمسك بنفس السكين لكل شيء. يبدو أن الدماغ يفعل الشيء نفسه عندما يكتسب مهارة جديدة في تمييز الأنماط.
في التجربة، تدربت القرود لأسابيع على تمييز اختلافات بالكاد ملحوظة في أنماط معقدة.
المبرمج يكتب الكود، يشغّله، يرى الخطأ ويصحّحه. الآن يمكن إسناد هذه العملية إلى البرنامج نفسه. التعلم العميق في التصوير الطبي أصبح قادرًا على تحسين الخوارزميات، لكنه عادةً يتطلب الكثير من البيانات والأمثلة الجاهزة.