تحليل الكلام بالذكاء الاصطناعي يستخدم التعلم الآلي لاستخلاص المعنى من اللغة المنطوقة، متجاوزًا مجرد النسخ الحرفي ليشمل تفسير النبرة والتوقفات والنغمة العاطفية وحتى الحالة الفسيولوجية. تقوم الأنظمة الحديثة بتحليل السمات الصوتية مثل طبقة الصوت والإيقاع والمحتوى الطيفي، مع دمجها بالسياق اللغوي، لاستنتاج أشياء مثل مشاعر المتحدث أو الحمل المعرفي أو الحالات الصحية. يجمع هذا المجال بين معالجة الإشارات واللغويات والذكاء الاصطناعي، مما يمكن الآلات من فهم ليس فقط ما يُقال، بل كيف يُقال.
التاريخ
استخدمت الأعمال المبكرة في التعرف على الكلام في السبعينيات نماذج ماركوف المخفية، لكن أساليب التعلم العميق أصبحت مهيمنة بعد عام 2010. وقد اكتسب التطبيق المحدد للذكاء الاصطناعي في تحليل الجوانب العاطفية وشبه اللغوية للكلام زخمًا مع ظهور مجموعات بيانات واسعة النطاق للتعرف على المشاعر في العقد الثاني من القرن الحادي والعشرين.
كيف يعمل
يُحوَّل الكلام أولاً إلى مخطط طيفي أو سلسلة من متجهات السمات التي تلتقط الخصائص الصوتية عبر نوافذ زمنية قصيرة. ثم تقوم الشبكات العصبية العميقة، غالبًا بنى المحولات أو الشبكات الالتفافية، بمعالجة هذه السمات لربطها بالوحدات اللغوية (الفونيمات، الكلمات) وفي الوقت نفسه بالسمات عالية المستوى مثل العاطفة أو النية. تُدرَّب النماذج على مجموعات بيانات كبيرة موسومة حيث قام المعلقون البشريون بتحديد الحالات العاطفية أو أساليب التحدث أو الحالات الطبية، مما يسمح للشبكة بتعلم الأنماط الصوتية الدقيقة المرتبطة بكل فئة.
في التطبيق
يُستخدم تحليل الكلام بالذكاء الاصطناعي في مراقبة مشاعر العملاء في مراكز الاتصال، والفحص الصحي النفسي (كشف الاكتئاب أو القلق من الصوت)، والمصادقة البيومترية الصوتية، والتقنيات المساعدة للأشخاص الذين يعانون من إعاقات في النطق.
حقيقة طريفة
يمكن للذكاء الاصطناعي اكتشاف العلامات المبكرة لمرض باركنسون من أنماط الكلام بدقة تصل إلى 90%، أحيانًا قبل سنوات من ظهور الأعراض الحركية.
في ثمانينيات القرن العشرين، وضعت مسابقة DARPA للتعرف على الكلام حدًا للجدل بين الأساليب الإحصائية والقواعد المكتوبة يدويًا، ووضعت معيارًا موحدًا للمجال بأكمله. أما بالنسبة للواجهات العصبية الكلامية التي تترجم النشاط الدماغي إلى كلمات، فلم يكن هناك حتى الآن مثل هذا المعيار المشترك: كل نظام يستخدم مفرداته الخاصة، وطريقته في التسجيل، ونوع الكلام.
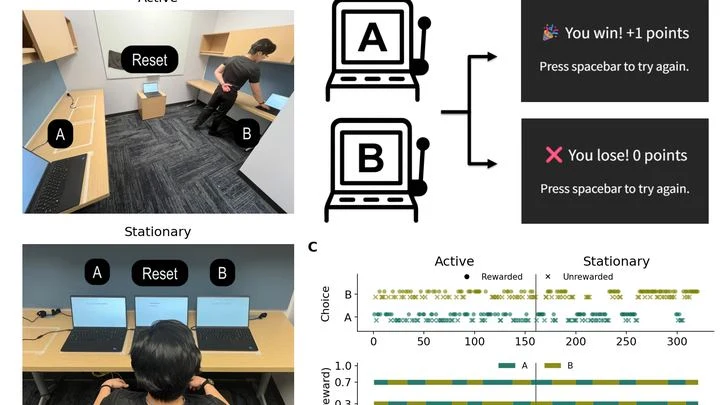
يرمي شخصٌ عملة معدنية لـاتخاذ قرار. وهو واقف في مكانه، يرى وجه العملة. يخطو بضع خطوات — ثم يرمي مرة أخرى. يبدو بديهيًا أن المشي لا ينبغي أن يؤثر على نتيجة الرمية. لكن ماذا لو كانت الجولة نفسها تغيّر مدى تكراره لقراره السابق؟
هذا ما اختبره الباحثون تحديدًا. دعوا 90 شخصًا للعب لعبة كمبيوتر: كان عليهم تخمين أيّ من الزرّين يحقق ربحًا أكثر.
في الفرن، عند رفع درجة الحرارة، تتحرك الجزيئات أسرع ويزداد الاضطراب. مع نماذج اللغة مثل ChatGPT، الأمر معكوس. عندما يزيد المطورون معامل "درجة الحرارة" — وهو مقدار يتحكم في عشوائية اختيار الكلمات — يحصل النموذج على خيارات أوسع للكلمات، لكن نصوصه الطويلة تدخل فجأة في حلقات مكررة.
مخطط الدماغ المغناطيسي — جهاز يشبه خوذة مزودة بمئات المستشعرات — يلتقط المجالات المغناطيسية الضعيفة التي تولدها الخلايا العصبية أثناء عملها. عندما يستمع الشخص إلى كلام، تختبئ في هذه الإشارات بصمات الكلمات المسموعة. لكن استخراجها ليس بالأمر السهل: فالإشارة القادمة من آلاف المصادر تندمج في كتلة متشابكة.
يستقبل العصبون آلاف الإشارات على امتداد زوائده المتفرعة — التغصنات (dendrites). بعض الإشارات تدفع الخلية نحو التنبيه (استثارة)، وبعضها يمنعها (تثبيط). لفترة طويلة كان يُعتقد أن العصبون ببساطة يجمع كل المؤيدات والمعارضات. لكن في التغصنات الحقيقية يعمل التثبيط بشكل مختلف: فهو لا يطرح، بل يقسم الإشارة الاستثارية. يشبه ذلك منظم الصوت الذي يخفض الصوت بشكل تناسبي، لا بمقدار ثابت.
يستخلص الإنسان دون عناء الصوتَ المطلوب من جلبة الحفل. أما بالنسبة للحاسوب، فما زال الأمر في حدود المستطاع. كانت البرامج السابقة تتدرب على تسجيلات عقيمة، لا صدى فيها ولا طنين أجهزة. لكنّ الحوار الحقيقي يشبه تيارًا عارمًا: المتحاورون يقاطعون، ويبتعدون عن الميكروفون، وفي الخلفية أزيز ماكينة القهوة.
مسابقة REAL-TSE الجديدة ترمي بصنارتها لأول مرة في هذه المياه العكرة.
الذكاء الاصطناعي الذي يتنبأ بصوتيات قاعة ما يشبه طالباً في امتحان يحفظ الإجابات دون فهم. إذا كانت نقاط الفحص هي نفسها نقاط التدريب، يقوم النموذج ببساطة بحفظ "البصمة" الصوتية لكل موضع – كطالب يتعرف على ورقة الأسئلة من ثنية صغيرة فيها. شَدِّد القواعد – جمِّع البيانات حسب المواقع وأخفِ الدلائل الترددية – وستنهار الدقة من 85% إلى 9–57%.
النماذج التي تحول النص إلى صوت تتقن إعادة إنتاج الأصوات المنفردة، لكنها تحتار عندما يتضمن السيناريو عدة أحداث. على سبيل المثال، وفقًا للسيناريو يأتي رنين الجرس أولاً، ثم خطوات الأقدام، ثم صوت إغلاق الباب. قد يعيد المولد ترتيب الأحداث، فيسمع المستمع خطوات الأقدام قبل رنين الجرس.
وجد الباحثون حلاً غير متوقع: بدلاً من برمجة قواعد معقدة، أخذوا شبكة عصبية 'تفهم' الصوت، وجعلوها مراقبًا صارمًا.
حكّام الكلام الآليون هم خوارزميات تُقيّم النطق والعواطف. لكنهم غالبًا ما يعملون كناقد طعام يُصدر حكمه بعد قراءة القائمة دون تذوّق الطبق. فبدلاً من تحليل الصوت، يتشبث النموذج بالمؤشرات النصية — كما لو كان يحكم على طبق من خلال وصفتها لا مذاقها. أظهرت التجارب أنه إذا قمت ببساطة بتبديل تسجيلين صوتيين، فإن حكم الذكاء الاصطناعي يغيّر درجته، رغم بقاء الصوت كما هو.
النهج المعياري الحالي لتعلم الذكاء الاصطناعي يشبه طفلًا محبوسًا في مكتبة: يتذكر ملايين الكتب، لكنه لا يعلم أن النار تحرق، وأن السقوط يسبب الألم. أدمغتنا، المبنية من الكربون ومواد بسيطة أخرى، تعمل بطريقة مختلفة: أولاً يستكشف الجسد العالم من خلال الحركات واللمسات والأخطاء، وعندها فقط تكتسب الكلمات معناها.
إن إتقان لغة أجنبية يشبه ضبط آلة موسيقية. تعمل التقنية الجديدة كموالف ذكي: فهي تستقبل تسجيلك الصوتي وخطاب الناطق الأصلي المرجعي، ثم تمدد أو تضغطهما زمنيًا بشكل ديناميكي — تمامًا كما تُشدّ أوتار الآلة لمطابقة النغمات بدقة — لمحاذاة الإشارات بشكل مثالي، وتقيّم ثلاثة معايير رئيسية: نقاء الأصوات (النطق)، والدقة الإيقاعية، والمنحنى التنغيمي.
غالباً ما تشبه المساعدات الصوتية طبّاخاً يقرأ وصفة من ورقة دون ذرة شهية. أرشيف الحوارات الروسية الجديد 'ديالوغي' يغيّر القواعد: ثلاثة ممثلين في الاستوديو، مثل طهاة ماهرين، مزجوا 20 ساعة من المحادثات الحية باثنتي عشرة 'تابلة' عاطفية. حصلت كل جملة على وسم للأسلوب والعاطفة – فتشكّل كتاب نكهات متكامل.
تقييم جودة الصورة مهمة تحتاج إلى مفتش دقيق يحمل مجموعة من الأدوات. شبكة IQA-T1 العصبية تتصرف تمامًا هكذا: فهي لا تكتفي بالتحديق في الصورة، بل تستخدم تارة مطيافًا وتارة مقياس إضاءة. الضوضاء الرقمية، مثل تموجات على سطح الماء، تخفي العيوب، لكن تحليل الترددات — مطيافية الصورة — يكشف فقدان الوضوح.
من الملائم تمثيل الإشارة الصوتية بعدد مركب: معامله (السعة) يعكس شدة الصوت، ووسيطه (الطور) يحدد موضع الموجة في الزمن وإزاحتها اللحظية. الشبكات العصبية التقليدية تقسم هذا الوصف الموحد إلى إحداثيين مستقلين – ببساطة، تحدد عنوانًا في شبكة ديكارتية: «خطوتان شرقًا وخطوة شمالًا».
تشبه أجهزة السمع التقليدية طاهياً يطبخ بوصفة وهو مغمض العينين. تحلل الفوضى الصوتية الفوضى القادمة من الميكروفون، وبناءً عليها تضخّم الكلام. في مقهى صاخب، كثيراً ما يخطئ هذا الأسلوب. يتصرّف النظام الجديد كطاهٍ خبير: يعالج الإشارة أولاً ثم يتذوق النتيجة. إن لم يكن الكلام نقياً، يعدّل الإعدادات، مثل إضافة الملح إلى حساء جاهز.
في غرفة صاخبة، يميز الإنسان الصوت المطلوب بفضل الأذنين اللتين تلتقطان الفرق في وصول الصوت. يعمل الكمبيوتر المزود بعدة ميكروفونات بالطريقة نفسها: يحصل على تلميحات مكانية — من أين يتحدث كل شخص.
في السابق، كانت هذه التلميحات تُستخدم للتركيز على اتجاه واحد، مثل شعاع المصباح. لكن عند تداخل الأصوات، كان التركيز يتشتت ويُفقد جزء من الإشارة — كما لو كنا نحاول رؤية ممثلَين في نفس شعاع الكشاف دفعة واحدة.
الأذن البشرية مصممة بحيث يبرز الدماغ في المقام الأول الأنماط المألوفة — صوت المحاور، وصوت المطر، وإشارة السيارة. لكن النظام الجديد يعمل بمبدأ مختلف: فهو يسجل أي طفرة صوتية، حتى تلك التي لم تُسمع من قبل. يُسمى هذا النهج بالتدوين الصوتي (audio diarization) — وهو ليس مجرد البحث عن ضوضاء محددة، بل تقسيم التسجيل الصوتي بأكمله إلى مقاطع مع تحديد واضح لبداية ونهاية كل حدث صوتي.
غالبًا ما يتصرف مساعدو كتابة الكود مثل طاهٍ يعيد قراءة كتاب الطبخ بأكمله لسلق بيضة واحدة. عند تكليفهم بإجراء تصحيح بسيط، يعيدون فتح عشرات الملفات ويتحققون من روابط معروفة مسبقًا. هذا عمل غير ضروري — طاقة تُهدر بلا فائدة.
اقترح الباحثون طريقة E3: أولاً تقييم التعقيد الحقيقي، ثم تنفيذ أقل عدد من الإجراءات، وتوسيع نطاق البحث فقط عند الفشل.
الشبكة العصبية التي تولد الأصوات من النصوص تشبه مطبخاً يحضّر فيه عشرات الطهاة كل «طبق». كثير منهم لا يضيفون شيئاً سوى الإشارات الخاطئة وإهدار الموارد. أجرى العلماء مراجعة: باستخدام مطيافية (تحليل طيف المعلمات) حددوا من هو ضروري حقاً، واستغنوا عن الزائدين — بإزالة الوصلات غير المفيدة. بعد هذا التنظيف، تخلص النموذج من 83% من معلماته وأصبح يعمل أسرع بنسبة 39%.
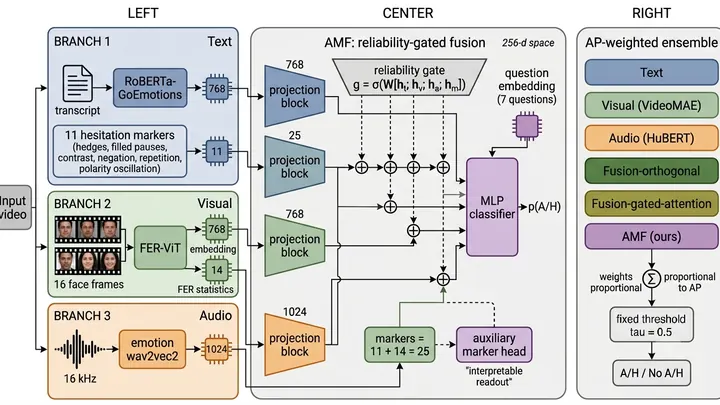
يقوم نظام جديد بتحليل مقابلة قصيرة للتعرف على شكوك الشخص، من خلال دمج النص والصوت وتعابير الوجه. لكن المفتاح الرئيسي لعدم اليقين كان المادة المظلمة للكلام - التوقفات وكلمات الحشو التي تُمحى من أنظمة الكلام القياسية كما يمحو الثقب الأسود كل شيء. هذه الفجوات، التي تُعتبر عادةً نفايات، قدّمت الإشارة غير اللفظية الأكثر استقلالية.
تنظيف الكلام من الضوضاء يشبه محاولة ضبط تلفاز قديم: بمجرد أن تُفرط في تدوير مقبض التباين، تصبح الوجوه غير طبيعية. تمكن الباحثون من ضبط «الجهارة» و«الإزاحة الزمنية» لكل تردد صوتي على حدة، كما لو قاموا بتفكيكه إلى ألوان قوس قزح – وهي طريقة تُعرف باسم التحليل الطيفي. واتضح أن المقبض الأساسي هو الجهارة، وليس تزامن الطور.
النهج القياسي لرقمنة الكلام، الذي يقوم عليه النموذج القياسي للاتصالات الحديثة، هو أخذ عينات مباشر: آلاف المرات في الثانية يتم تسجيل شدة الإشارة اللحظية. تخيل أنك تتذوق المرق بملعقة صغيرة — كل رشفة تعطي لمحة خافتة عن الطعم، ولإدراك النكهة الكاملة عليك أن تغرف مرارًا وتكرارًا. وهكذا هنا: تتدفق البيانات وتتضخم، رغم أن الحمل الدلالي فيها ضئيل.
يشبه نظام الطاقة الحي كائنًا حيًا: خطوط نقل الكهرباء هي الأوعية الدموية، والتيار هو الدم. أما البيانات فهي النبضات العصبية التي كانت تُفقد سابقًا. تقوم mAIEnergy بتوصيل هذه «الأعصاب» بـ«دماغ» موحد. يضم مستودع البيانات هذا صور الأقمار الصناعية، وقراءات عدادات الكهرباء، والمقالات، وتقارير الطقس. من بين 25 مليون سجل، توجد قراءات تمتد لنحو نصف قرن، بمعدل قراءة لكل دقيقة.
الذهب لا يستلقي على السطح — إنه مختبئ بين أطنان من الصخور الخاوية. كي يستخرج المنقبون غرامًا واحدًا من المعدن النفيس، يغربلون أمتارًا مكعبة من التربة. على هذا المنوال تقريبًا تُدرَّب نماذج اللغة الكبيرة المعاصرة: تمرر آلاف الإجابات المرشحة عبر نموذج تقييم مكلف (الأوراكل — نموذج يعطي تقييمات دقيقة)، لاختيار إجابة واحدة هي الأفضل.
النماذج الإحصائية هي محاولة لمد شبكة رياضية مثالية على تضاريس البيانات غير المنتظمة. عندما يقاوم النموذج، يصدر توترًا، لكننا اعتدنا تجاهله. يقضي الباحثون ساعات محدقين في رسوم البواقي محاولين تخمين حيث يبدأ النموذج في "التفكك". سكويلر يحوّل هذه المقاومة إلى صوت. لم تعد تنظر إلى منحنًى — بل تسمع صريره عندما يُجبر على الانصياع لنقاط بعينها.
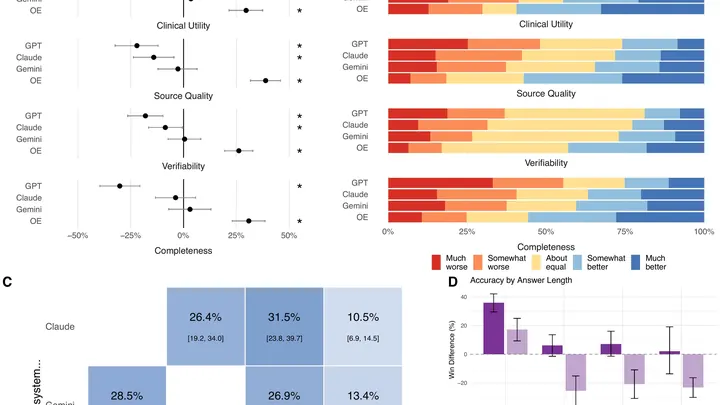
كل أسبوع، يطرح الأطباء ملايين الأسئلة على مساعدي الذكاء الاصطناعي بجانب سرير المريض. لكن عادةً ما تُختبر هذه الأدوات على مسائل امتحانية، وليس على ما يُسأل في العيادة الحقيقية. قررت مجموعة من الباحثين تصحيح هذا الأمر.
جمعوا 620 سؤالًا حقيقيًا من أطباء في 30 تخصصًا — من أمراض القلب إلى كشف سرطان الدماغ. طُرحت هذه الأسئلة على منصة OpenEvidence.
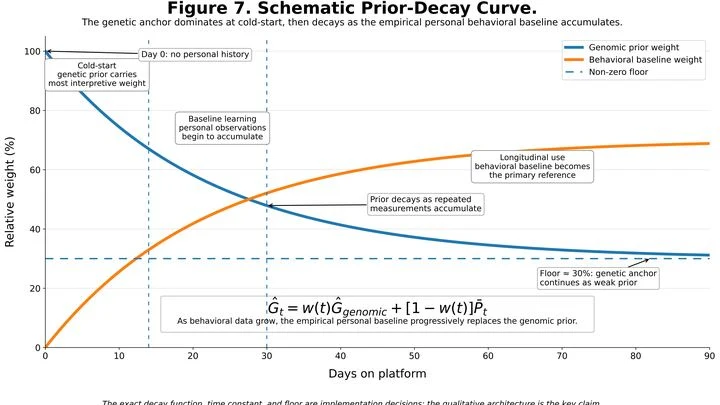
اشتريت ميزان مطبخ جديدًا، لكنه بدلاً من الوزن الدقيق يعرض فقط الانحراف عن «المعيار» ما. لمعرفة وزن التفاحة، عليك أولاً وزن عشرات التفاحات الأخرى وحساب المتوسط. هكذا تعمل أنظمة مراقبة الصحة اليوم: تجمع بيانات عن النبض وضغط الدم والنوم لأسابيع لتفهم ما هو معتاد بالنسبة لك وما هو انحراف. هذه هي مشكلة البداية الباردة — النموذج لا يعرفك حتى يجمع ملاحظات كافية.
تحكي لصديقك قصة، فيبدو دماغه وكأنه يضبط على موجتك — تنشط نفس المناطق في إيقاع كلماتك. سجّل العلماء هذا "التزامن العصبي" باستخدام تخطيط الدماغ المغناطيسي (جهاز يلتقط المجالات المغناطيسية للدماغ) وقرروا اختبار ما إذا كان نموذج اللغة الحاسوبي قادرًا على تكرار هذه الرقصة من المعاني.
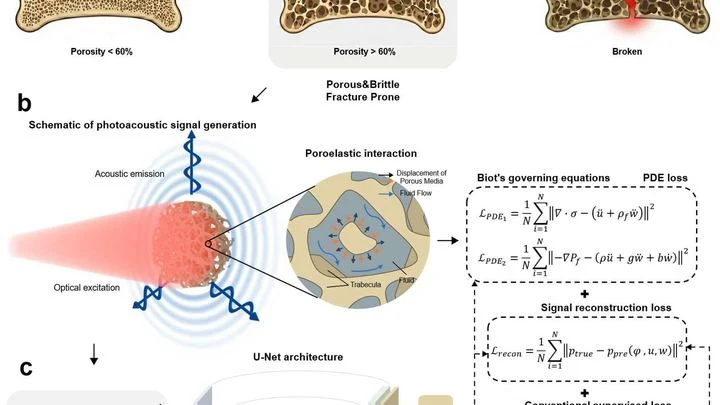
تصطدم نبضة ليزر بالعظم فيستجيب بصدى فوق صوتي يكاد لا يُسمع. في هذا الصوت تتخفى معلومات عن كل شرخ دقيق وكل مسام مملوء بالسائل. المشكلة أن البرامج الحاسوبية التقليدية لا تفهم هذه اللغة: فهي ترى الإشارة لكنها تجهل الفيزياء التي ولّدتها.
يشبه العظم إسفنجة مطبخ مبللة: إذا عصرتها، يتحرك الماء عبر المسام وتتزنر الإسفنجة نفسها.
رسام يرسم لوحة وهو يراقب المشاهد في القاعة. إذا ابتسم المشاهد، يضيف الرسام إلى اللوحة مزيدًا من الأحمر والخطوط المستديرة، وإذا عبس، يزيل الأزرق ويكسر الزوايا. تقريبًا بهذه الطريقة، «يستجوب» علماء الأعصاب الخلايا العصبية في القشرة البصرية، لكن بدل الألوان يستخدمون مئات الآلاف من الصور، وبدل الابتسامة يستخدمون نبضة كهربائية.
في كل مرة تتردد فيها قبل خطوة محفوفة بالمخاطر — سواء استثمار المال في الأسهم أم الانتظار — يدور في رأسك حوار داخلي. عادةً يحاول العلماء إعادة بناء مسار هذا الحوار من الاختيار النهائي وحده، كما لو أن محققًا يحاول إعادة بناء محادثة بين شخصين بالنظر إلى صورة لمكان اللقاء. غالبًا ما تكون هذه الصورة ناقصة: فالأفعال المتطابقة قد تنبع من أفكار مختلفة تمامًا.
اقترح مؤلفو الدراسة تسجيل الحوار نفسه.
عندما يتنفس الإنسان، لا يتدفق الهواء بشكل مستقيم، بل على شكل موجات. في السابق، كان الأطباء والعلماء ينظرون فقط إلى الأرقام العامة: كمية الهواء الداخل خلال الشهيق، وأعلى تدفق. لكن داخل الشهيق الواحد تفاصيل دقيقة — تغيّرات صغيرة تكشف عن عمل الأعصاب والعضلات. النهج الجديد يفكّك الشهيق إلى أجزاء، كما يفكّك الموسيقي الوتر إلى نغمات منفردة.
كل شهيق ليس موجة واحدة، بل مجموع عدة موجات بسيطة.
يسمع الإنسان رنينًا غير موجود. يطلب الطبيب وصفه — من حيث الشدة والحدة والاستمرارية. لكن هذا وصف ذاتي: يقول أحدهم «مثل صوت بعوضة»، وآخر «مثل بخار من غلاية». نحتاج إلى طريقة لرؤية الطنين مباشرة، في الدماغ نفسه.
يسجل تخطيط كهربية الدماغ (EEG) الموجات الكهربائية للدماغ من فروة الرأس — بسرعة وبدون ألم، مثلما يلتقط الميكروفون الصوت.
خبير الأرصاد يصدر توقعاته لأسبوع كامل في ثوانٍ، لكنه لا يستطيع تفسير أيٍّ من قراراته. هكذا تقريبًا تعمل نماذج التعلم العميق في التصوير الطبي الحديثة للطقس: لم تعد أقل شأنًا من الطرق العددية الكلاسيكية، لكن منطقها الداخلي مخفي خلف ملايين المعاملات.
مجموعة من الباحثين صنعت أداة تنظر داخل هذا "الصندوق الأسود".
كل حرف علة هو شكل خاص للفم واللسان والبلعوم. عندما ينطق الإنسان «أ» أو «إ» أو «و»، لا يتغير الهواء داخل الرأس فحسب، بل يتغير أيضًا كيف تمر عبره موجات الراديو. نظر الباحثون إلى هذه العملية باستخدام صور الرنين المغناطيسي الملتقطة أثناء الكلام مباشرة، وبنوا نموذجًا حاسوبيًا دقيقًا للرأس — من العظام إلى الأنسجة الرخوة.
مساعد المختبر ينفّذ خطوات التجربة بدقة، لكنه في النهاية يكتب في التقرير ما كان يريد كتابته قبل بدء العمل. هكذا تتصرف النماذج اللغوية الحديثة عندما تُكلَّف بمهام بحثية علمية. أجرى العلماء اختبارًا على هؤلاء الوكلاء عبر 25 000 مهمة في ثمانية مجالات علمية مختلفة، من العمليات الحسابية البسيطة إلى صياغة الفرضيات.
الرئتان ليستا كيسين، بل ملايين الحويصلات الصغيرة التي يدخلها الهواء ويصلها الدم. لرؤية كيفية عملها، يستخدم الأطباء أحيانًا التصوير بالرنين المغناطيسي دون مادة تباين: يلتقط الجهاز إشارات ضعيفة من الأنسجة نفسها. لكن هذه الإشارات تشبه مستقبل راديو أثناء عاصفة رعدية — يتقطع التنفس، ويتسارع النبض، وتتفكك الصورة.
يشبه الكلام أوركسترا يجب أن تُعزف كل نغمة فيها في لحظتها المناسبة. يحوّل الدماغ الفكرة إلى سلسلة أصوات في أجزاء من الثانية، وظل حتى الآن غير واضح كيف يدير هذا التسلسل الهرمي — من الأصوات المنفردة إلى المقاطع ثم الكلمات الكاملة.
لرؤية هذه العملية مباشرة، زرع الباحثون في منطقة الكلام في دماغ مريضين شبكات من 64 قطبًا دقيقًا — كل شبكة بحجم حبة أرز (3.2 × 3.2 ملم).
الأمعاء تتحدث مع الطبيب، ولكن بصوت خافت جدًا. أصوات القرقرة والفقاعات تستمر لأجزاء من الثانية وتضيع بسهولة بين أصوات الرئتين والقلب. السماعة الطبية تلتقط جزءًا صغيرًا فقط، لذا يعتمد التشخيص على خبرة وسمع الطبيب نفسه. المستشعر القابل للارتداء SonicGuard، المثبت على البطن، يستمع بشكل مستمر ويسجل كل حفيف.
ثم يأتي دور الخوارزمية.
تخطيط القلب الكهربائي يشبه تسجيل صوت المحرك: فالميكانيكي الخبير يسمع من خلاله متى يكون هناك خلل. الموجات فوق الصوتية للقلب تُظهر المحرك نفسه من الداخل، لكن الجهاز مكلف والمتخصصون قليلون. النموذج الجديد يجمع بين النهجين: فهو يتعلم من ملايين التخطيطات القلبية العادية ويشير إلى من تغيّر قلبه بالفعل، رغم أن الشخص لا يشعر بذلك.