من يعالج أفضل: ذكاء اصطناعي عام أم متخصص ضيق؟ سريع
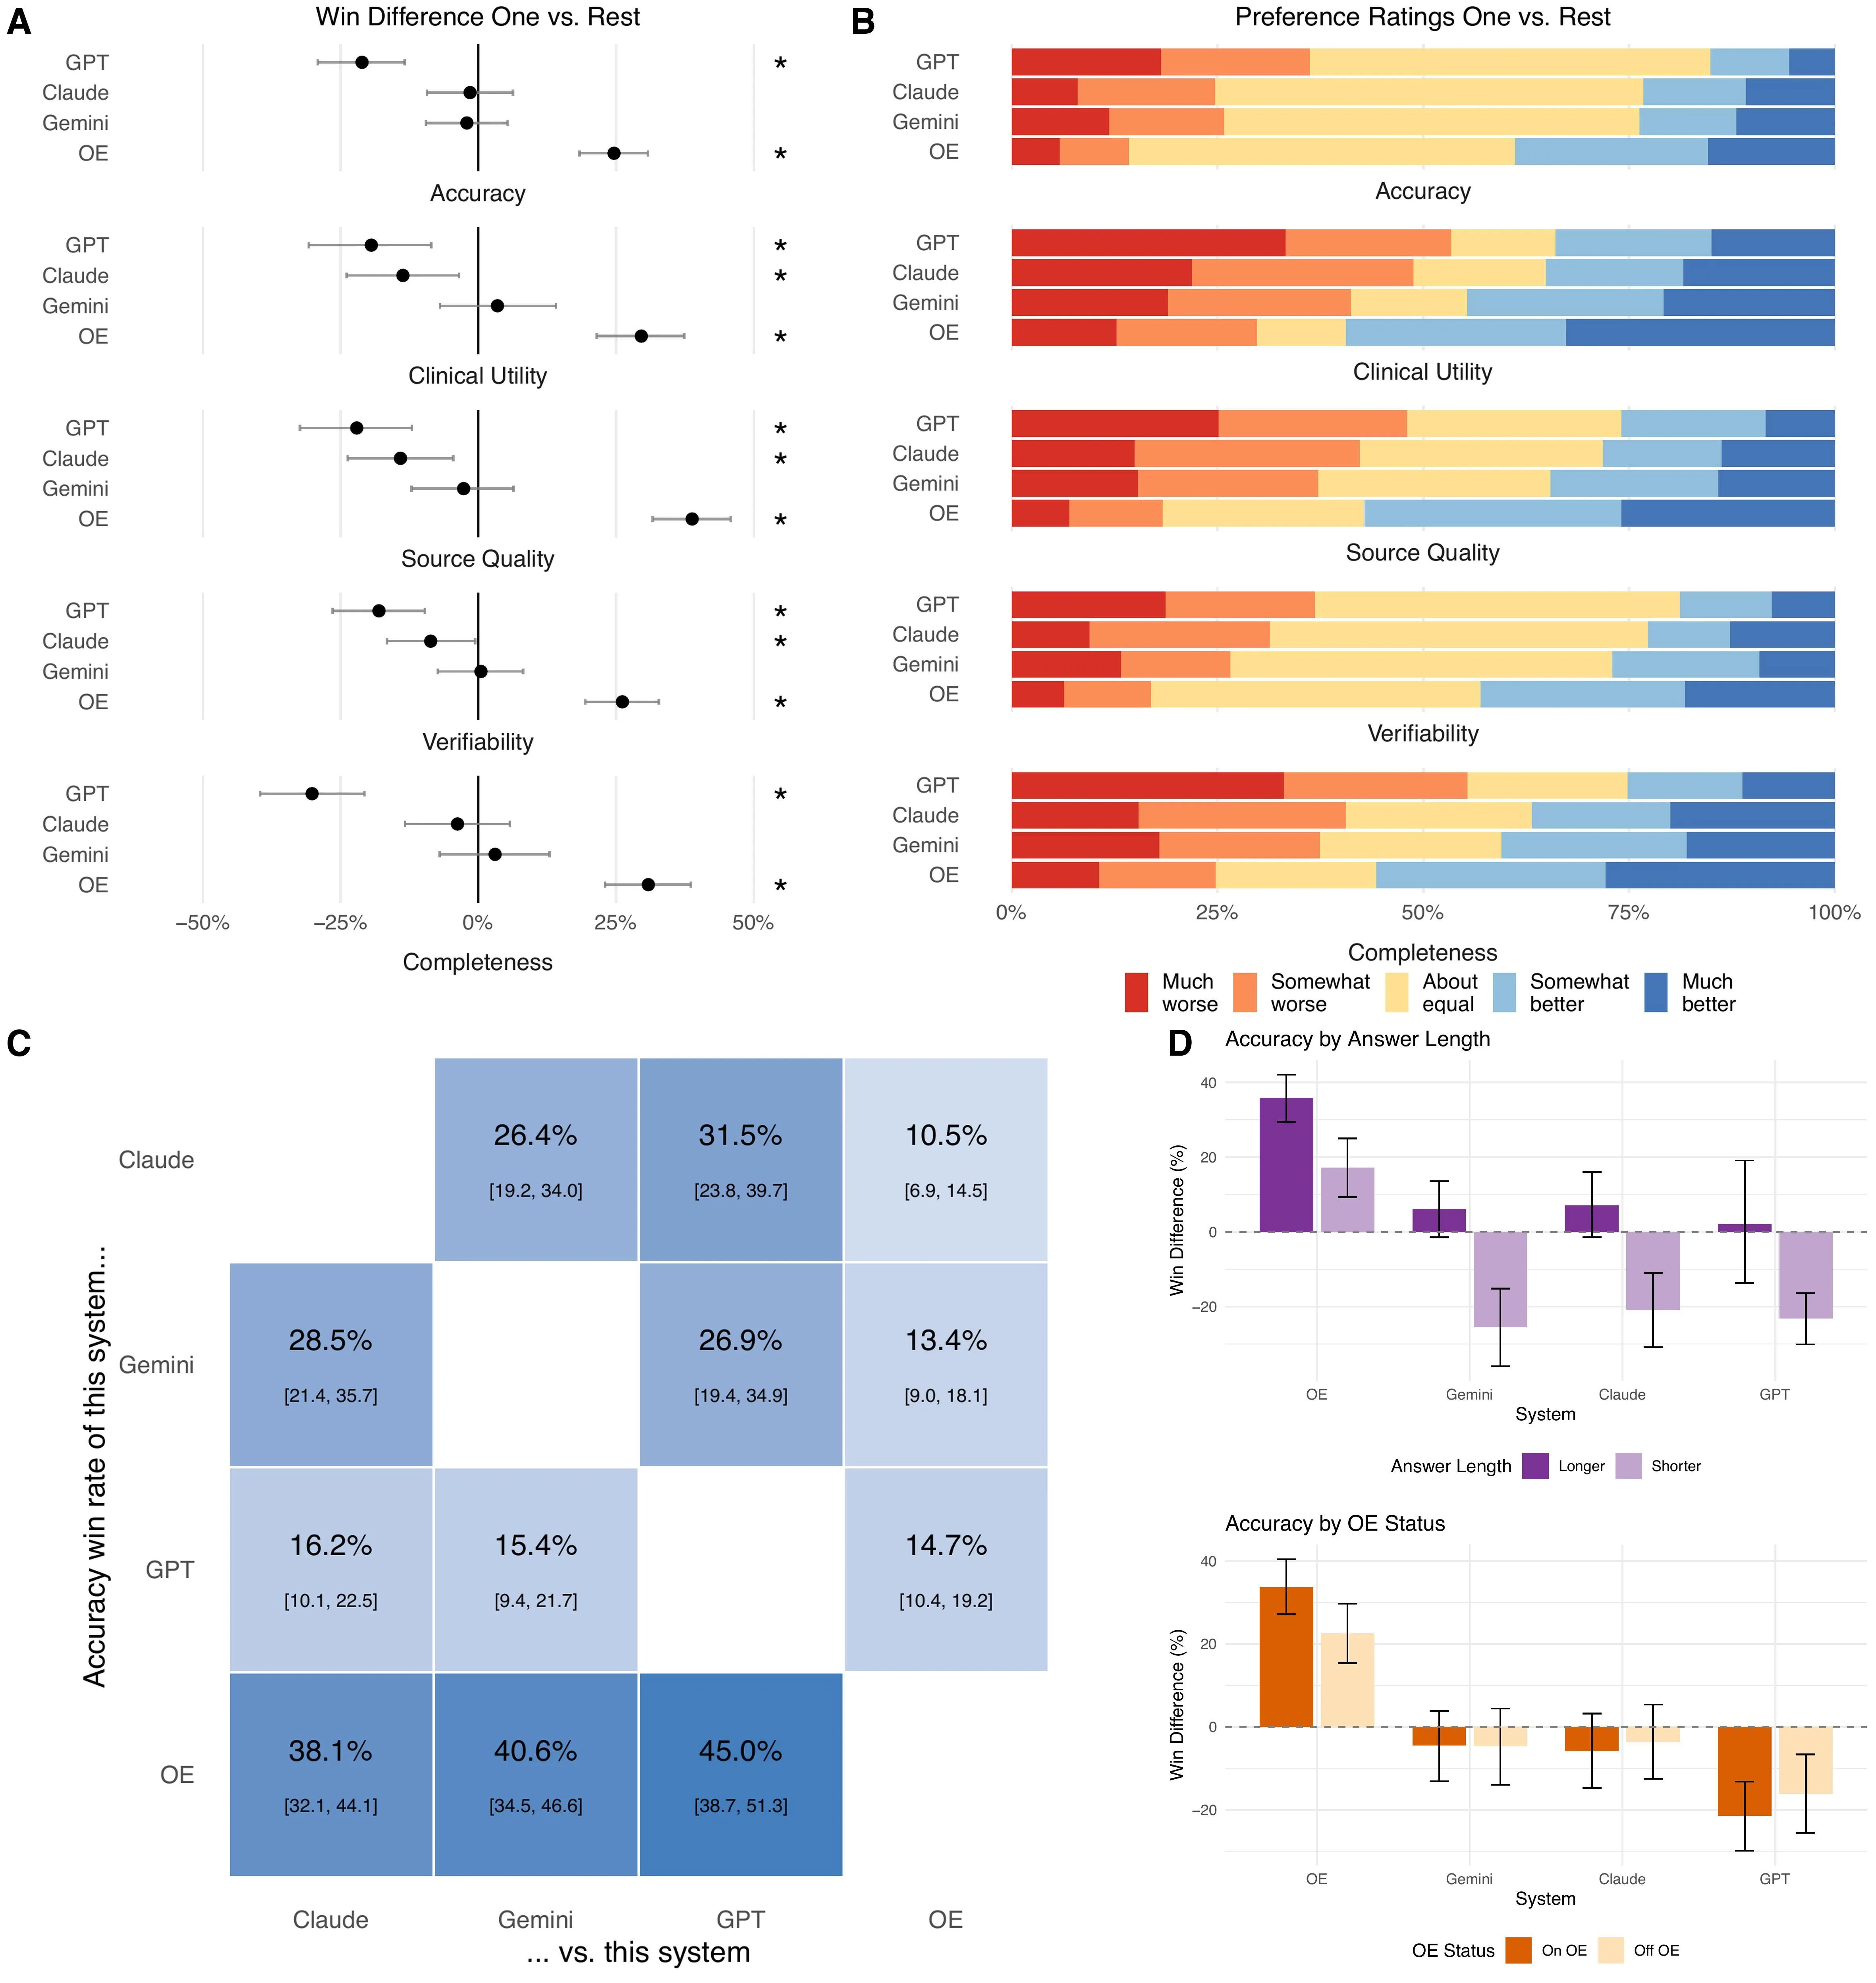
كل أسبوع، يطرح الأطباء ملايين الأسئلة على مساعدي الذكاء الاصطناعي بجانب سرير المريض. لكن عادةً ما تُختبر هذه الأدوات على مسائل امتحانية، وليس على ما يُسأل في العيادة الحقيقية. قررت مجموعة من الباحثين تصحيح هذا الأمر.
جمعوا 620 سؤالًا حقيقيًا من أطباء في 30 تخصصًا — من أمراض القلب إلى كشف سرطان الدماغ. طُرحت هذه الأسئلة على منصة OpenEvidence. ثم قارن 149 طبيبًا ممارسًا من 36 ولاية إجابات ثلاث نماذج عامة رائدة (Claude Opus 4.8، Gemini 3.1 Pro، GPT-5.5) والأداة الطبية المتخصصة (OE). كان كل محكّم من نفس تخصص الطبيب الذي طرح السؤال.
قُيّمت الإجابات وفق خمسة محاور: الدقة، والفائدة السريرية، وجودة المصادر، وقابلية التحقق، والاكتمال. فازت الأداة المتخصصة في جميع البنود. بلغ الفرق بين الانتصارات والهزائم من 25 إلى 39 نقطة مئوية — بدلالة إحصائية قوية جدًا (p<0.001). لم تعتمد النتيجة على ما إذا كانت الاقتباسات ظاهرة، أو طول الإجابة، أو ما إذا كان المحكّم قد استخدم هذه الأداة من قبل.
هناك نتيجتان. الأولى: يجب اختبار الذكاء الاصطناعي الطبي على أسئلة حقيقية وبمشاركة أطباء من نفس التخصص — وإلا ستكون الصورة ناقصة. الثانية: تفوق الأداة المتخصصة لا يعني أن النماذج العامة عديمة الفائدة. بل يُظهر أن الضبط الهندسي الموجه يحقق مكسبًا ملموسًا للمستخدم. مثل سماعة طبية مضبوطة جيدًا تسمع ما يفوته ميكروفون عام.
بلغ الفارق في الانتصارات 39 نقطة مئوية — وكأن فريقًا يفوز في 7 مباريات من أصل 10، بينما يفوز الآخر في 3 فقط.