Azúcar con una semana de antelación exprés
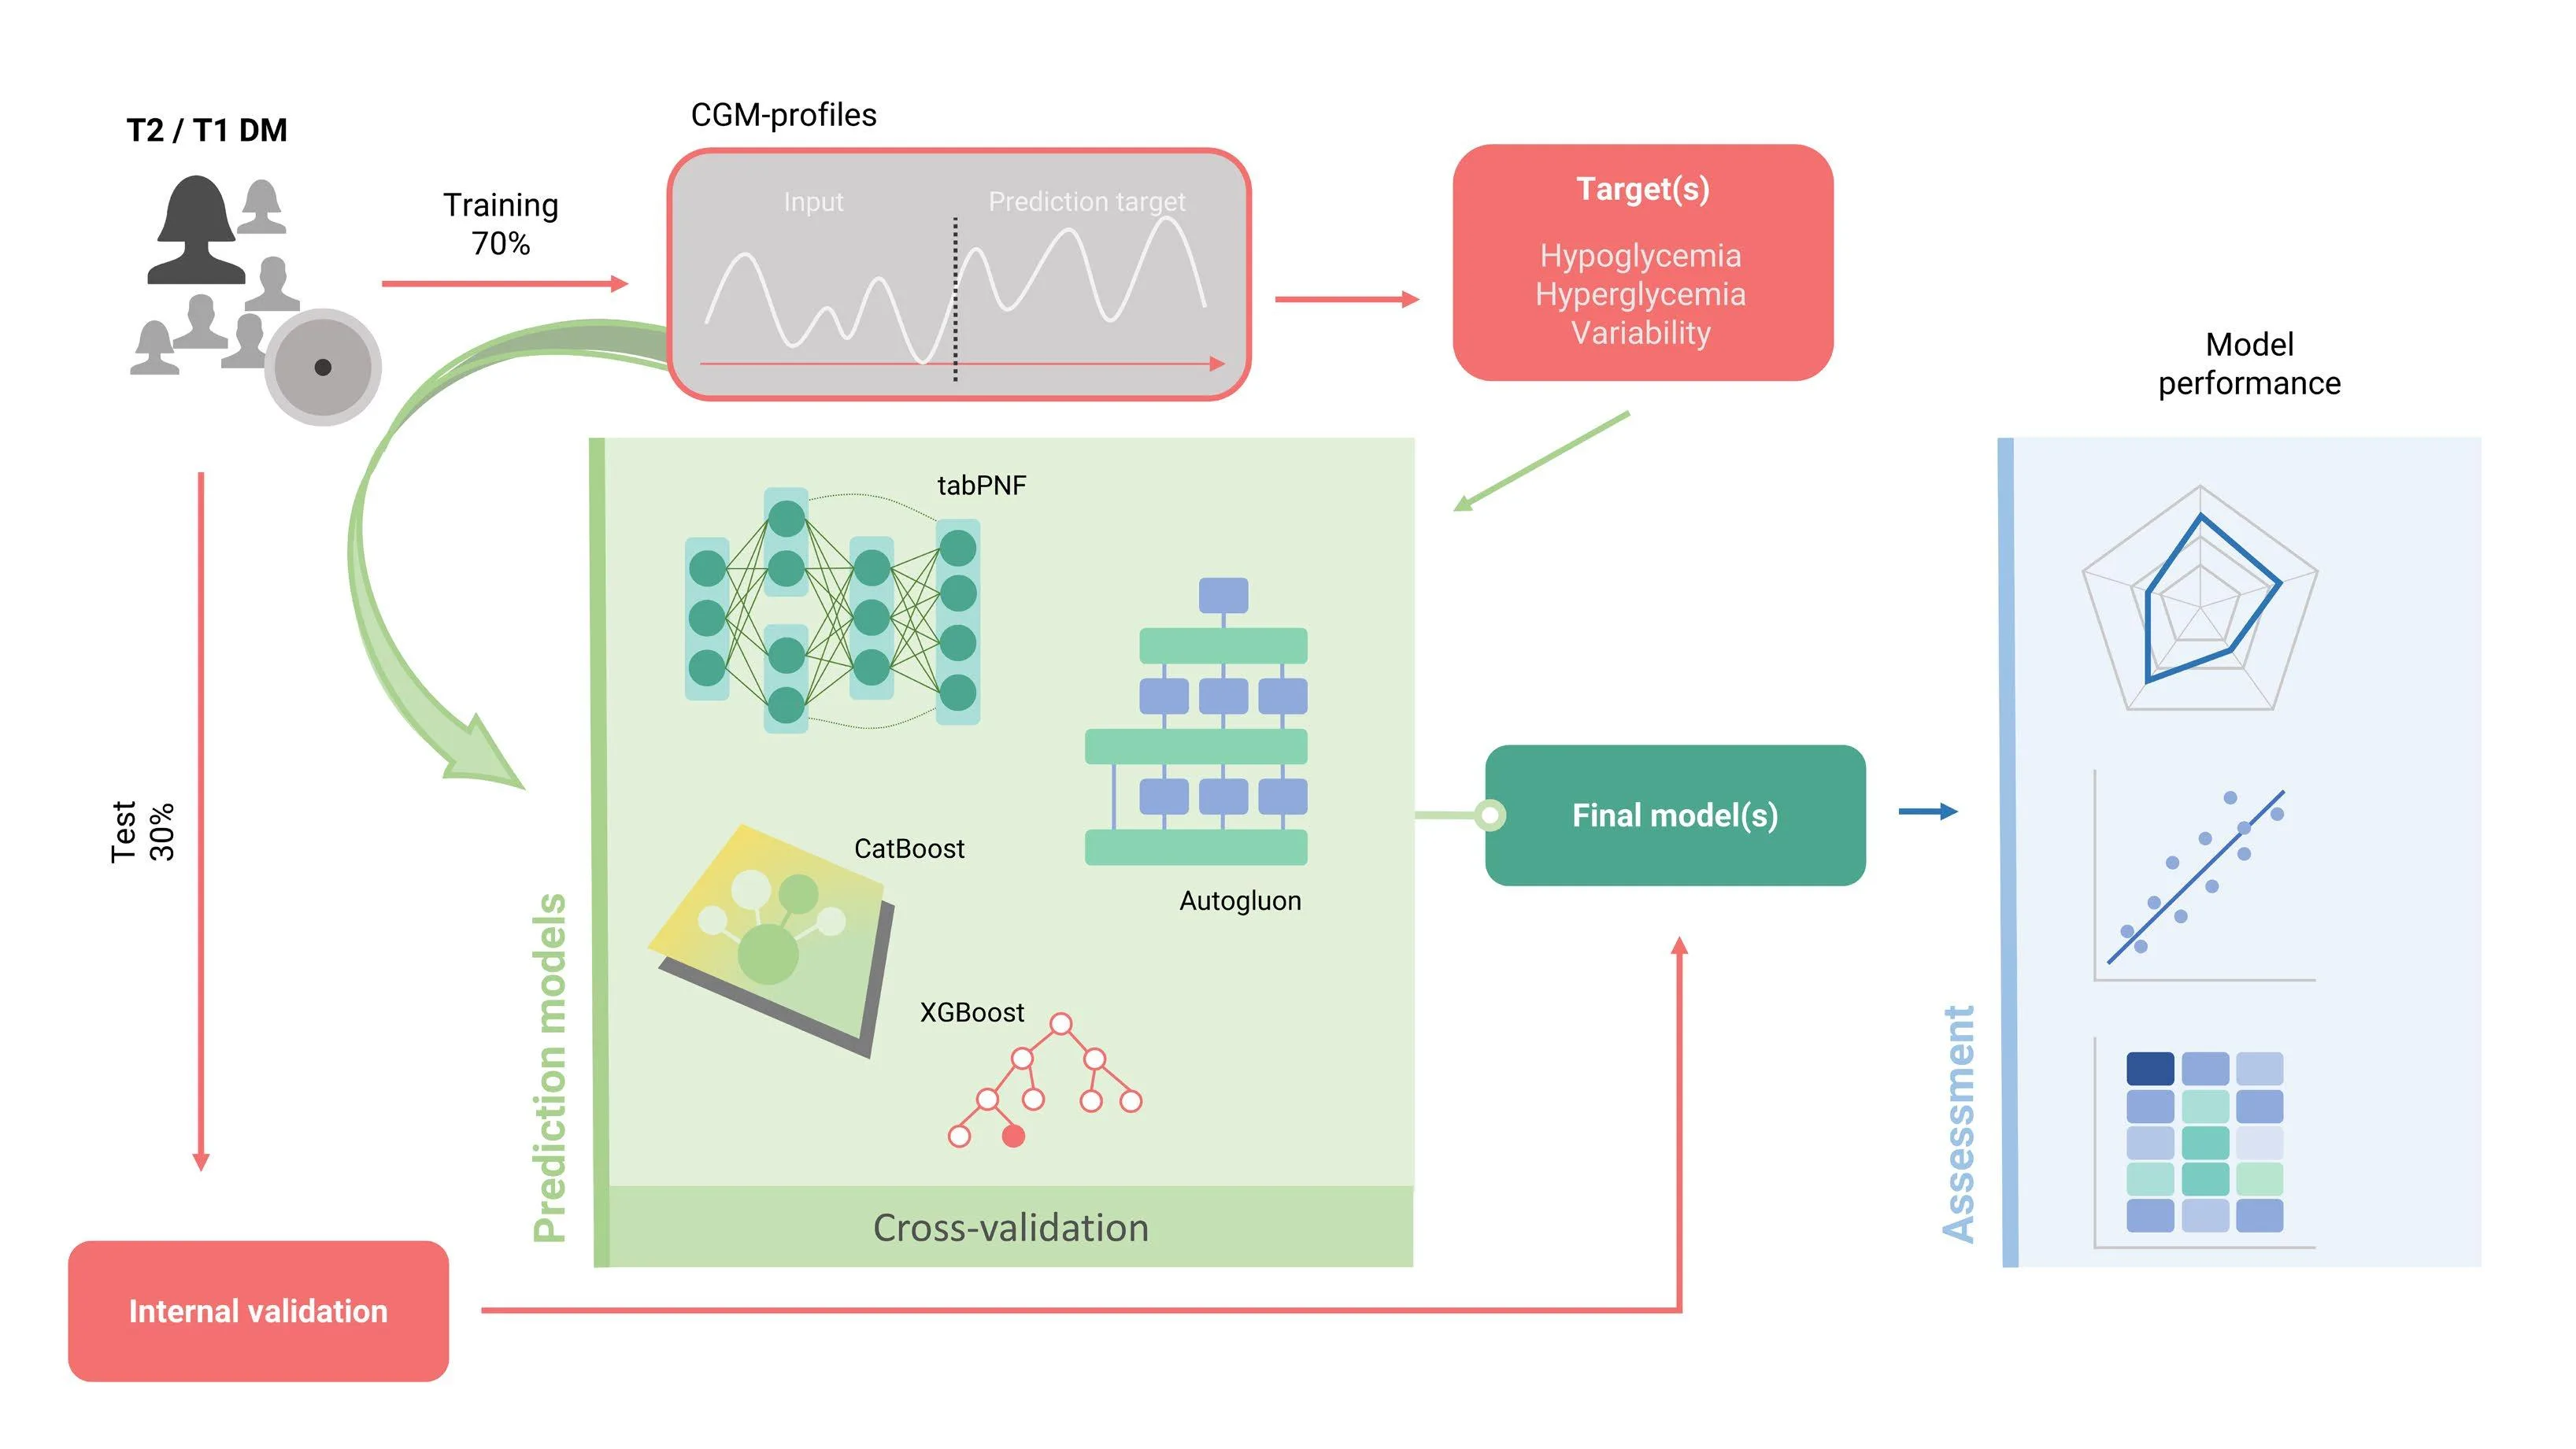
Un sensor en el brazo mide el azúcar en sangre las 24 horas y envía los datos al teléfono. Pero el médico los ve después del evento: el azúcar bajó por la noche, subió después de comer. ¿Y si pudiéramos mirar una semana hacia adelante y ver cómo será el nivel de glucosa? Eso es justo lo que intentaron hacer los autores del estudio.
Tomaron los registros de 4622 semanas de observación de personas con diabetes tipo 1 y tipo 2. Cuatro modelos informáticos, como cuatro expertos distintos, aprendieron de las semanas anteriores a predecir seis indicadores para la semana siguiente. Por ejemplo, cuánto tiempo estará el azúcar dentro de los límites seguros o cuánto fluctuará. Resultó que todos los modelos funcionan aproximadamente igual de bien para la mayoría de los indicadores: el error de predicción es de alrededor del 8–16 por ciento. Pero con las caídas raras de azúcar (hipoglucemia) es más complicado: el error crece hasta el 48 por ciento, aunque en cifras absolutas es pequeño. Es como predecir el clima: los días soleados son fáciles de acertar, pero una tormenta rara es difícil.
Conclusión práctica: predecir el panorama general del azúcar con una semana de antelación ya es posible hoy, pero las caídas raras y peligrosas de azúcar siguen siendo un desafío. Quizás en el futuro estas predicciones ayuden a las personas con diabetes a ajustar la dosis de insulina o el plan de comidas con anticipación, igual que el pronóstico del tiempo ayuda a llevar paraguas.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2601.00613
Background: Accurate week-ahead forecasts of continuous glucose monitoring (CGM) derived metrics could enable proactive diabetes management, but relative performance of modern tabular learning approaches is incompletely defined. Methods: We trained and internally validated four regression models (CatBoost, XGBoost, AutoGluon, tabPFN) to predict six weekahead CGM metrics (TIR, TITR, TAR, TBR, CV, MAGE, and related quantiles) using 4,622 case-weeks from two cohorts (T1DM n=3,389; T2DM n=1,233). Performance was assessed with mean absolute error (MAE) and mean absolute relative difference (MARD); quantile classification was summarized via confusion-matrix heatmaps. Results: Across T1DM and T2DM, all models produced broadly comparable performance for most targets. For T1DM, MARD for TIR, TITR, TAR and MAGE ranged 8.5 to 16.5% while TBR showed large MARD (mean ~48%) despite low MAE. AutoGluon and tabPFN showed lower MAE than XGBoost for several targets (e.g., TITR: p<0.01; TAR/TBR: p<0.05 to 0.01). For T2DM MARD ranged 7.8 to 23.9% and TBR relative error was ~78%; tabPFN outperformed other models for TIR (p<0.01), and AutoGluon/ tabPFN outperformed CatBoost/XGBoost on TAR (p<0.05). Inference time per 1,000 cases varied markedly (PFN 699 s; AG 2.7 s; CatBoost 0.04 s, XGBoost 0.04 s). Conclusions: Week-ahead CGM metrics are predictable with reasonable accuracy using modern tabular models, but low-prevalence hypoglycemia remains difficult to predict in relative terms. Advanced AutoML and foundation models yield modest accuracy gains at substantially higher computational cost.
El error de predicción para las caídas raras de azúcar en términos relativos es enorme, alrededor del 48 por ciento, aunque en valores absolutos son solo unos pocos minutos al día. Así que los modelos "casi aciertan", pero precisamente esos pocos minutos pueden ser los más peligrosos.