Base viva de células solares exprés
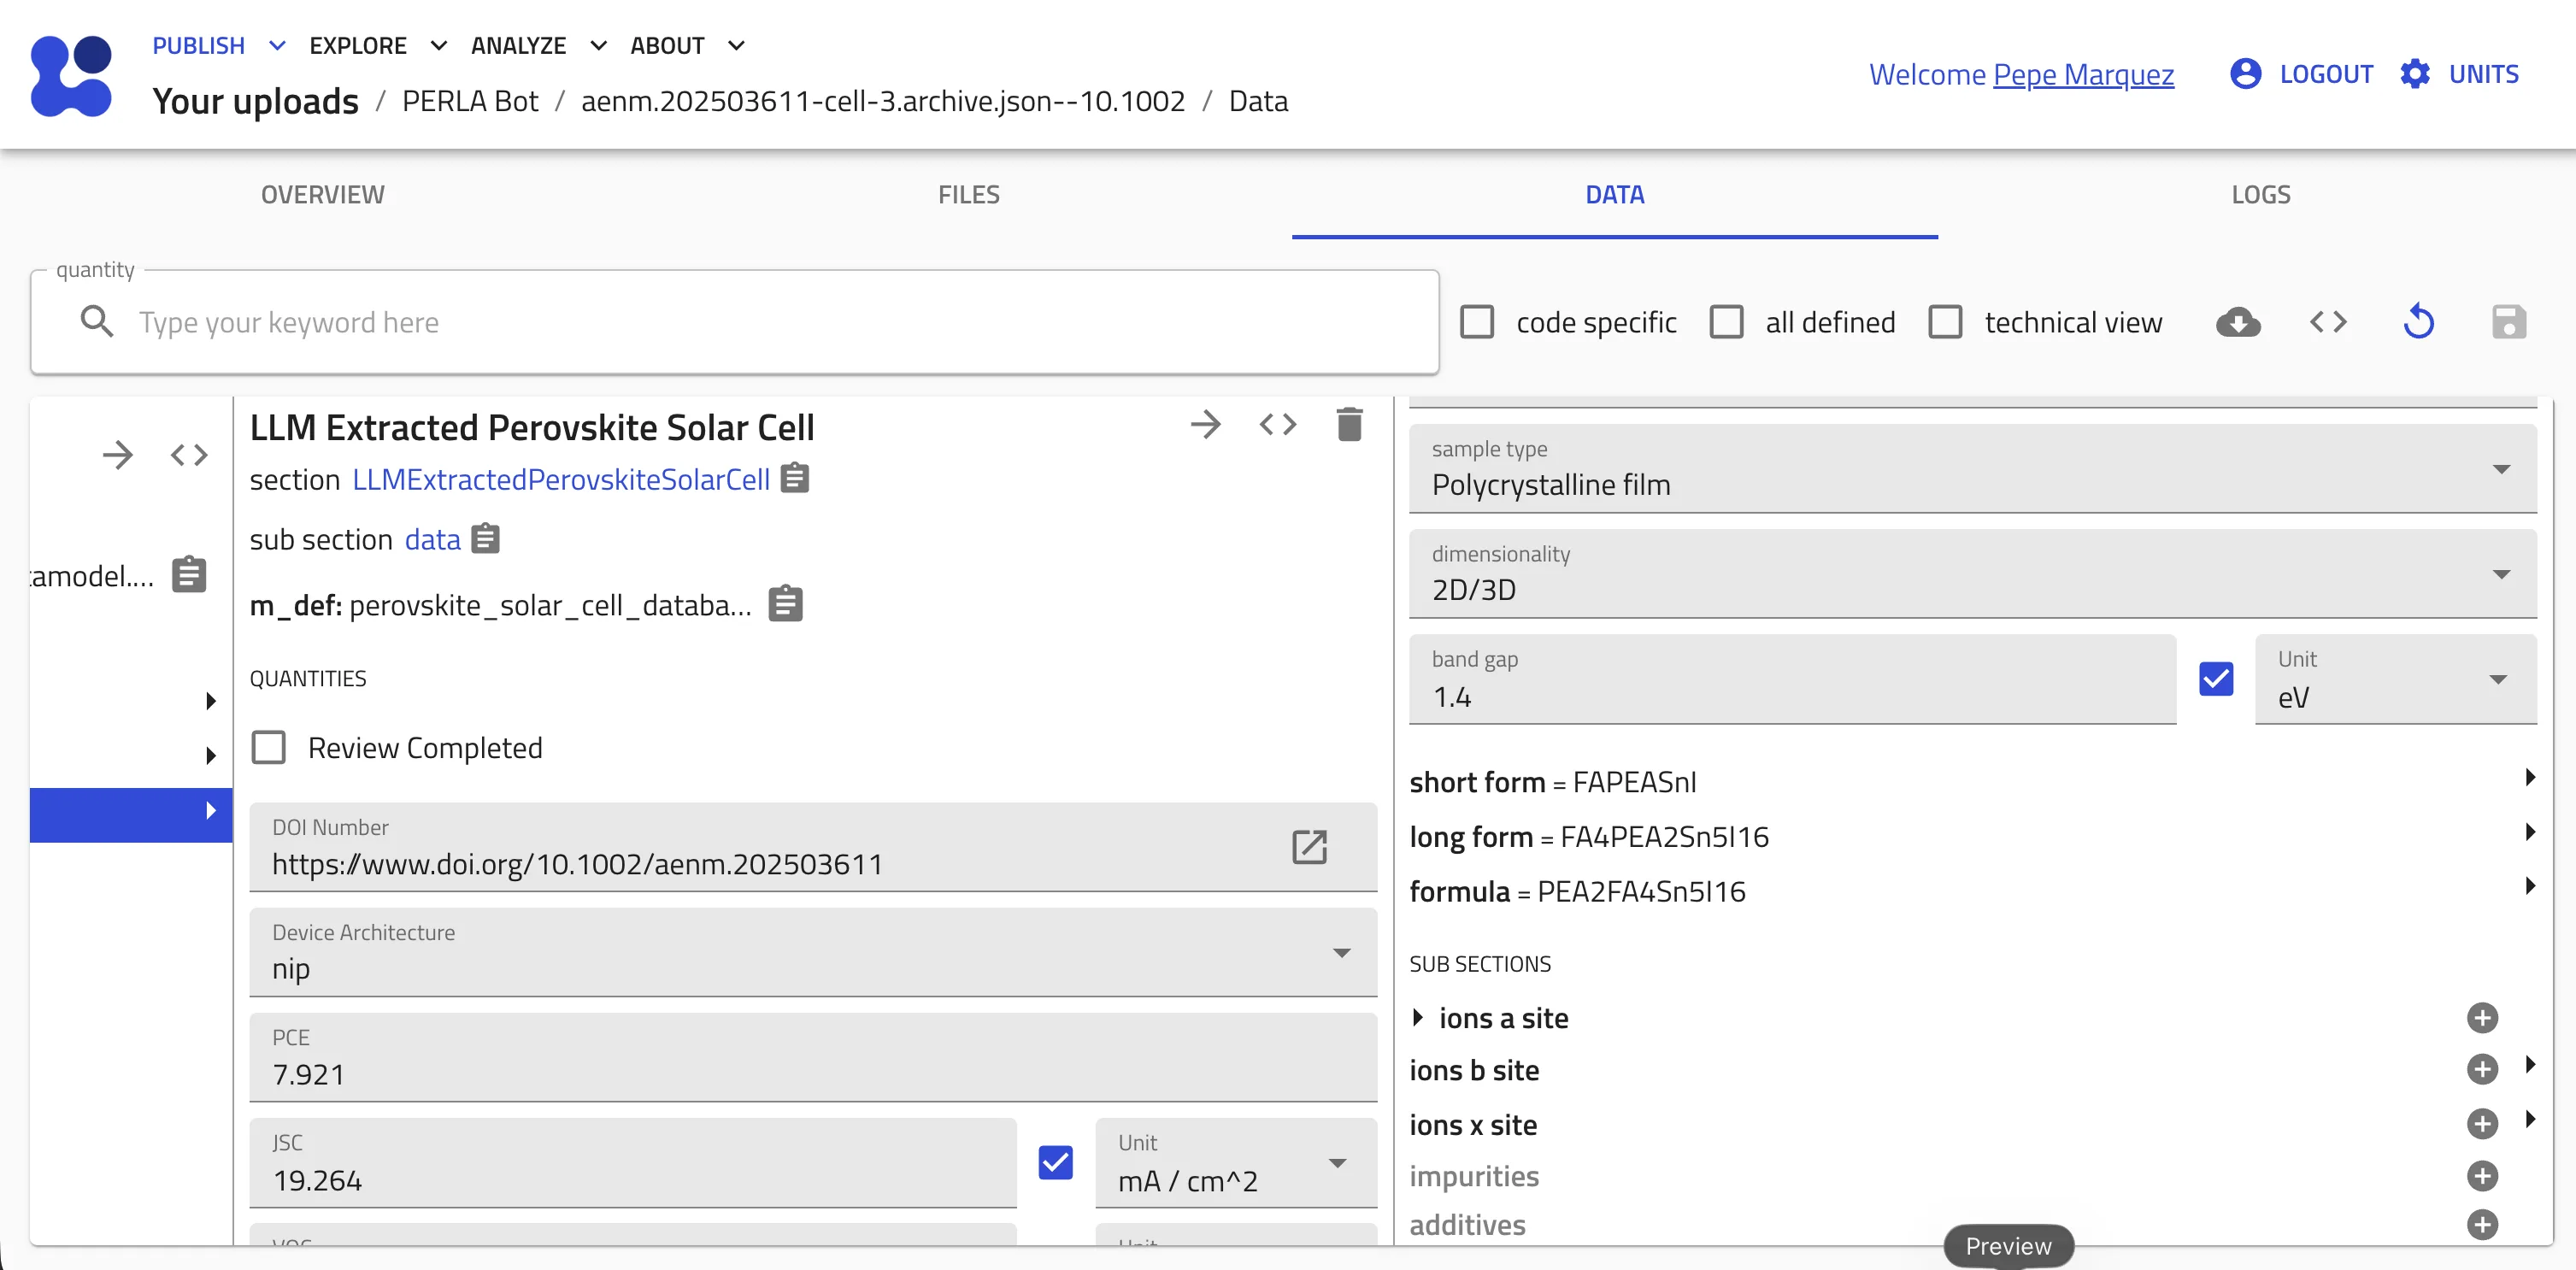
Los artículos científicos se publican más rápido de lo que las personas pueden leerlos y sistematizarlos. En el campo de las células solares de perovskita, la principal base de datos se quedó congelada en 2021, aunque la investigación avanza a todo ritmo. Ahora, PERLA ha venido al rescate: una base viva y autónoma que vigila por sí misma el flujo de publicaciones.
PERLA utiliza grandes modelos de lenguaje para extraer de los textos datos complejos sobre los dispositivos, y luego los verifica mediante reglas físicas. La precisión de la extracción supera el 90% y, a diferencia de los humanos, el sistema no sufre de inconsistencia en las evaluaciones. Es como un bibliotecario aplicado que no se cansa ni se equivoca por agotamiento.
Gracias a PERLA, las publicaciones estáticas se convierten en un recurso de conocimiento dinámico. Ahora los investigadores pueden apoyarse en datos actualizados y avanzar más rápido hacia nuevos descubrimientos. La base crece junto con la ciencia, sin quedarse atrás ni un solo día.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2601.17807
Scientific discovery is severely bottlenecked by the inability of manual curation to keep pace with exponential publication rates. This creates a widening knowledge gap. This is especially stark in photovoltaics, where the leading database for perovskite solar cells has been stagnant since 2021 despite massive ongoing research output. Here, we resolve this challenge by establishing an autonomous, self-updating living database (PERLA). Our pipeline integrates large language models with physics-aware validation to extract complex device data from the continuous literature stream, achieving human-level precision (>90%) and eliminating annotator variance. By employing this system on the previously inaccessible post-2021 literature, we uncover critical evolutionary trends hidden by data lag: the field has decisively shifted toward inverted architectures employing self-assembled monolayers and formamidinium-rich compositions, driving a clear trajectory of sustained voltage loss reduction. PERLA transforms static publications into dynamic knowledge resources that enable data-driven discovery to operate at the speed of publication.
La precisión de extracción de datos de PERLA supera el 90%, comparable al trabajo de un experto experimentado, pero sin errores humanos ni fatiga.