De qué callan las células inteligentes: atención sin provecho exprés
Dentro de la célula hay un hervidero de actividad: miles de genes se encienden y se apagan como bombillas en un tablero gigante. Las redes neuronales entrenadas para leer ese tablero han aprendido a adivinar qué ocurrirá si se 'apaga' un gen o se añade un fármaco. Pero cómo lo hacen exactamente es un misterio. Los científicos decidieron mirar en su interior y comprobar si la 'atención' del modelo (a qué genes presta más atención) refleja realmente las conexiones en la célula.
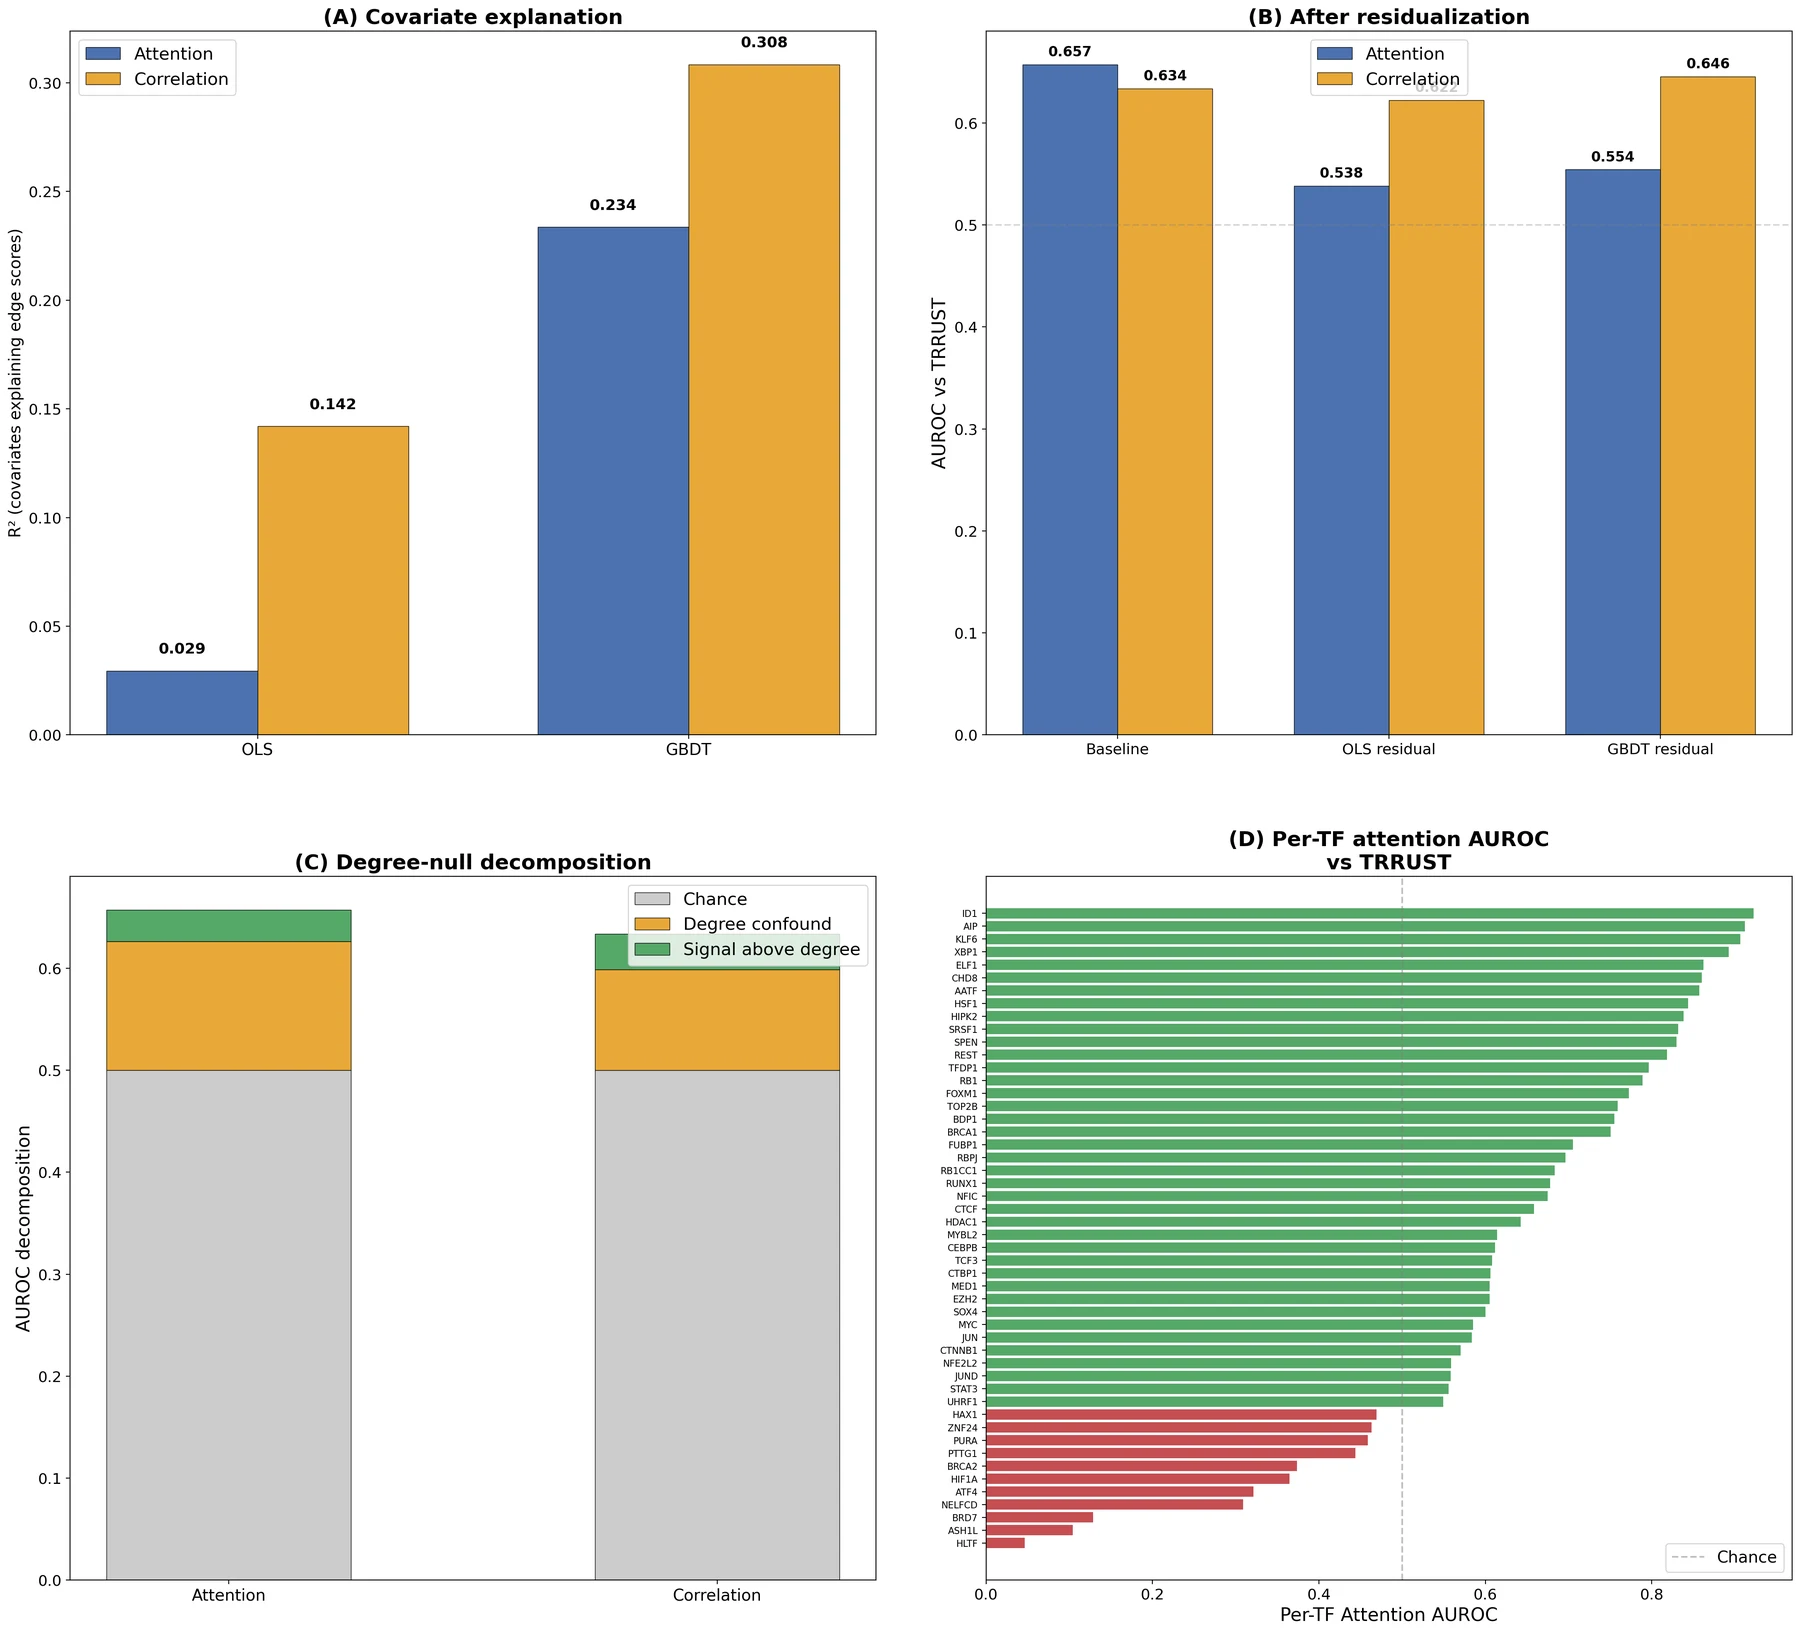
Tomaron dos modelos conocidos — scGPT y Geneformer — y les pasaron datos de células sanguíneas y de retina. Resultó que la atención sí estructura: en las capas tempranas del modelo se ven conexiones entre proteínas que se tocan físicamente, y en las tardías, conexiones entre genes que se regulan entre sí. Bonito, como un mapa de metro. Pero cuando usaron esos 'mapas' para predecir la respuesta celular a una perturbación, no ayudaron. Un método simple que solo observa qué genes cambian juntos con más frecuencia dio un resultado de 0.81–0.88 en la escala de precisión, mientras que las 'inteligentes' conexiones de atención solo 0.70. Si se eliminan por completo esas conexiones, las predicciones no empeoran.
Es como si un intérprete en una reunión tomara notas detalladas en los márgenes, pero tradujera peor que un diccionario. Los científicos propusieron un método de 'reentrenamiento' de la atención — CSSI, que ayuda al modelo a reconstruir mejor las redes reales de genes (hasta 1.85 veces más preciso). Pero incluso después de esto, los métodos simples siguen siendo más fuertes. Para la ciencia, esta es una lección importante: no confíes en las imágenes bonitas, comprueba su utilidad con números.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2602.17532
We present a systematic evaluation framework - thirty-seven analyses, 153 statistical tests, four cell types, two perturbation modalities - for assessing mechanistic interpretability in single-cell foundation models. Applying this framework to scGPT and Geneformer, we find that attention patterns encode structured biological information with layer-specific organisation - protein-protein interactions in early layers, transcriptional regulation in late layers - but this structure provides no incremental value for perturbation prediction: trivial gene-level baselines outperform both attention and correlation edges (AUROC 0.81-0.88 versus 0.70), pairwise edge scores add zero predictive contribution, and causal ablation of regulatory heads produces no degradation. These findings generalise from K562 to RPE1 cells; the attention-correlation relationship is context-dependent, but gene-level dominance is universal. Cell-State Stratified Interpretability (CSSI) addresses an attention-specific scaling failure, improving GRN recovery up to 1.85x. The framework establishes reusable quality-control standards for the field.
El modelo scGPT se entrenó con datos de 33 millones de células, más que la población de Tokio.
En la serie 'Westworld', los robots tenían hermosos 'recuerdos' pero no comprendían su significado, una situación similar a la atención de las redes neuronales.