El aprendizaje autosupervisado es un paradigma en el que el modelo genera señales de entrenamiento extrayéndolas de la propia estructura de los datos no etiquetados. A diferencia del aprendizaje no supervisado, que a menudo se centra en la agrupación o la reducción de dimensionalidad, aquí se construyen tareas sustitutas (pretexto) que no requieren anotaciones humanas. Por ejemplo, en el procesamiento del lenguaje natural, se enmascara una parte de las palabras en una oración de entrada y la red aprende a reconstruirlas a partir del contexto. En visión artificial, son populares los métodos contrastivos: dos versiones distorsionadas aleatoriamente de una misma imagen se 'acercan' en el espacio de representaciones, mientras que se 'alejan' de otras imágenes. Esto forma un concepto visual, similar a cómo los bebés segmentan objetos del fondo.
Historia
Las ideas de autocontrol se remontan a los trabajos sobre autoencodificadores (Hinton, 2006) y al aprendizaje de representaciones mediante reconstrucción. El momento decisivo fue 2018 con la aparición de BERT (Devlin et al.), que utiliza enmascaramiento de palabras. Para imágenes, en 2020, el método SimCLR (Chen et al.) mostró que un esquema contrastivo simple con lotes de gran tamaño es comparable al aprendizaje supervisado. Posteriormente, los Transformadores de Visión combinados con la codificación automática enmascarada (MAE) repitieron el éxito de la PNL, demostrando escalabilidad.
Cómo funciona
El esquema general de SSL incluye: 1) una tarea pretexto — generación automática de la señal objetivo; 2) un codificador que extrae representaciones; 3) opcionalmente, un proyector para la comparación de métricas; 4) una función de pérdida que resuelve la tarea pretexto concreta. En PNL: lenguaje enmascarado (MLM) — tarea de reconstrucción de tokens ocultos. El modelo recibe una secuencia con máscaras [MASK] y aprende a predecir las palabras originales mediante entropía cruzada. En visión artificial: los métodos contrastivos aprenden representaciones invariantes a los aumentos, utilizando lotes grandes y un codificador de momento (momentum encoder) para estabilizar. Los codificadores automáticos enmascarados recientes (MAE) enmascaran parches aleatorios de la imagen y un decodificador reconstruye los píxeles, obligando al modelo a comprender la estructura global de los objetos.
En la práctica
Sistemas de reconocimiento de voz, traductores automáticos, todos los grandes modelos de lenguaje modernos (como GPT), diagnóstico médico mediante imágenes sin anotaciones de los médicos.
Dato curioso
Después del aprendizaje autosupervisado con textos, el modelo GPT-3 resultó capaz de escribir poesía, código y ensayos científicos, aunque nadie le enseñó específicamente a hacerlo.
Un radiólogo mira una tomografía abdominal y no ve solo órganos, sino su disposición mutua: qué riñón es más grande, dónde está el tumor respecto al vaso. Es como leer un mapa, donde no basta con saber dónde suele estar una ciudad, sino que hay que poder medir la distancia entre dos puntos del terreno.
En un edificio de nueve pisos, con mil habitaciones por planta, algunos susurran y otros gritan. Los vecinos transmiten las palabras, pero si todos hablan demasiado bajo, el mensaje se desvanece ya en el tercer piso. Si hablan demasiado alto, para cuando llega al último piso se ha convertido en un rugido ininteligible. Entre esos extremos hay un régimen en el que el susurro llega hasta el final sin distorsión.
En el hielo antártico, una partícula fantasma deja tras de sí solo un débil destello de luz azul. El detector IceCube capta esos destellos, y con ellos hay que deducir de dónde vino la partícula. El modelo PolarBERT aprendió a hacerlo, pero qué ve exactamente en su interior seguía siendo un misterio.
Un intérprete simultáneo en una sala donde hablan dos personas: debe seguir tanto el sentido como la entonación, pero si hablan demasiado rápido, solo queda un resumen. Algo así se sienten los científicos cuando el flujo de ondas gravitacionales de fusiones de agujeros negros y estrellas de neutrones crece, y los cálculos precisos de las señales no dan abasto.
Una sola molécula de ADN, atrapada en una diminuta rendija metálica, tiembla y parpadea bajo el láser. Su señal no es una clara línea de letras, sino una mezcla caótica de destellos y sombras. Descifrar ese ruido es como entender un susurro en una sala abarrotada.
La nueva red neuronal actúa como un intérprete atento.
Buscar un material nuevo es como cocinar sin receta: pruebas y pruebas, y a menudo tiras todo a la basura. Antes, los científicos revisaban manualmente los artículos y probaban las composiciones una por una. Ahora ha aparecido un "chef robot" que lee la literatura, mezcla los componentes y observa el resultado.
La orquesta toca, pero los músicos no se oyen entre sí. El director detiene la música una y otra vez y se acerca a cada uno para afinar el instrumento. Así funcionan aproximadamente los telescopios espaciales con espejos segmentados.
La máquina de rayos X toma la imagen, pero el médico solo ve números: densidad ósea, porcentaje de grasa. Sin embargo, la imagen guarda mucho más. Un equipo de investigadores creó el modelo LeDXA, que lee estas imágenes como un mapa de señales ocultas del cuerpo.
El modelo se entrenó con 11 540 imágenes del proyecto 'Fenotipo Humano' sin una sola etiqueta.
En un horno, al subir la temperatura, las moléculas se mueven más rápido y el desorden aumenta. Con los modelos de lenguaje como ChatGPT ocurre lo contrario. Cuando los desarrolladores aumentan el parámetro de «temperatura», el modelo tiene acceso a una selección más amplia de palabras, pero sus textos largos de repente se quedan en bucle.
El magnetoencefalógrafo, un dispositivo parecido a un casco con cientos de sensores, capta los débiles campos magnéticos que generan las neuronas en acción. Cuando una persona escucha habla, en esas señales se esconden huellas de las palabras oídas. Pero extraerlas no es fácil: la señal de miles de fuentes se funde en una maraña confusa.
El cerebro no solo reacciona al mundo: constantemente está adivinando qué ocurrirá en el instante siguiente. Este principio se conoce como codificación predictiva: las neuronas comparan las expectativas con la realidad y actualizan su imagen interna cuando ocurre un error.
La red neuronal predice el futuro de un sistema, por ejemplo, cómo se arremolina el plasma en un campo magnético o cómo cambia un rostro en un video. Los errores son inevitables, y cuanto más lejos mira hacia adelante, más se acumulan. En el momento de la operación es imposible contrastar con la respuesta correcta: simplemente no existe.
La mente humana es como un juego de construcción que se va completando a sí mismo. Las ideas nuevas no mueren con la persona: se transmiten, se mezclan y se seleccionan. Este proceso se llama evolución cultural: los inventos útiles se consolidan y los inútiles se olvidan. Así funciona un trinquete, un mecanismo que solo gira hacia adelante.
Una prótesis ocular no transmite al cerebro una fotografía, sino un punteado escaso de puntos brillantes: los fosfenos. Para distinguir en ese parpadeo una taza o unas llaves, la persona debe mover la cabeza como una linterna en la oscuridad e ir juntando poco a poco los contornos del objeto. Es un proceso lento, parecido a armar un rompecabezas al que le faltan la mayoría de las piezas.
Doscientas cuarenta y dos mil trescientas veintisiete galaxias — como granos de arena en una playa. Pero los astrónomos convirtieron este caos en un mapa: el algoritmo UMAP (método de aprendizaje automático) tomó de cada galaxia once parámetros — siete colores desde el óptico hasta el infrarrojo medio (esto es…
Reconstruir una imagen completa a partir de fragmentos es como distinguir la melodía de una orquesta en una sala ruidosa. Este tipo de tareas se presentan en la fotometría, donde a partir de un tenue centelleo se recupera el brillo de una estrella. Los métodos tradicionales requieren información precisa sobre el ruido, que casi nunca se conoce.
Las cámaras del coche autónomo captan la luz como telescopios apuntando a una galaxia lejana. Cada fotograma es una observación fragmentaria; juntos deben combinarse en un mapa del camino.
La computadora, como un astrónomo, no pega las imágenes, sino que genera varias posibles vistas aéreas y las compara con los datos reales.
Muchos procesos naturales se describen mediante ecuaciones, pero solo tenemos fragmentos de ellas. El nuevo método actúa como un cartógrafo que, a partir de pocos puntos de referencia, reconstruye un mapa completo del terreno.
Una visita con un solo robot es un monólogo agotador, sin nadie con quien cruzar la mirada. Los investigadores transformaron ese monólogo en una escena viva: al robot guía real le añadieron una compañera holograma. Este tándem conversa, discute, bromea, involucrando a los visitantes en la charla, en lugar de limitarse a recitar datos.
Un programa de seguimiento común se asemeja a un navegante que guía un barco por las estrellas. Pero en cuanto el cielo se nubla, las coordenadas empiezan a desviarse y en los datos aumenta la entropía (medida de incertidumbre). El nuevo algoritmo incorpora un «copiloto»: un módulo que monitoriza el nivel de confianza del navegador principal.
Estás bajo la ducha: giras el grifo y el agua sale helada o hirviendo. Las tuberías tienen vida propia: la presión fluctúa impredeciblemente. El nuevo controlador aprende sobre la marcha: no conoce el sistema de fontanería, pero en minutos se adapta y ajusta suavemente la temperatura, sin violar los límites de seguridad.
El enfoque estándar actual para entrenar a la IA se parece a un niño encerrado en una biblioteca: recuerda millones de libros, pero no sabe que el fuego quema o que una caída duele.
Aprender un idioma extranjero es como afinar un instrumento musical. La nueva tecnología funciona como un afinador inteligente: toma tu grabación y el habla de referencia de un nativo, las estira o comprime en el tiempo (como se tensa una cuerda) para alinearlas con precisión, y evalúa tres parámetros principales: la pureza de los sonidos, la precisión rítmica y la…
Tras lanzar una piedra, los círculos en el agua desaparecen, pero el líquido conserva vibraciones microscópicas. El más leve soplo y las ondas reaparecen. Las redes neuronales se comportan de forma similar. Cuando las señales eléctricas se calman, su memoria perdura en los puntos de contacto: las sinapsis.
El cerebro se comunica con breves chasquidos eléctricos. Antes, para aprender este lenguaje, se necesitaban miles de ejemplos traducidos por un experimentador. El método MOJO sigue otro camino: como cuando se aprende un idioma por inmersión, primero escucha el 'flujo de conciencia' sin pistas y encuentra por sí mismo patrones repetitivos.
En una olla de sopa, bastan dos termómetros para saber la temperatura en todas partes, si se sabe que el calor sube en círculos desde el fondo. Así ocurre en la ciencia: a partir de pocas mediciones hay que reconstruir la imagen completa del campo térmico.
Durante mucho tiempo, los biólogos estudiaban las células escuchando solo una voz en un coro polifónico: por ejemplo, medían la actividad de los genes ignorando cómo está empaquetado el ADN. Es como intentar entender una conversación conociendo un solo idioma. LATTICE lo corrige: el programa aprende cinco 'idiomas' moleculares a la vez, desde la actividad génica hasta las marcas espaciales.
Los jueces automáticos del habla son algoritmos que evalúan la pronunciación y las emociones. Sin embargo, a menudo funcionan como un crítico culinario que emite un veredicto tras leer el menú, pero sin probar el plato.
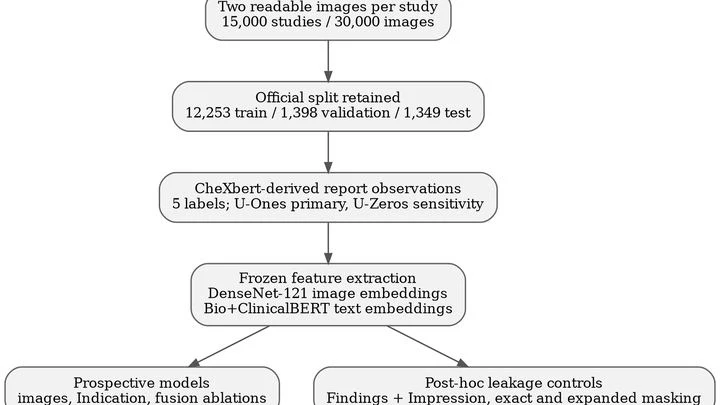
El diagnosticador de IA aprende como un estudiante de medicina antes de un examen. Se le dan una radiografía y las quejas del paciente. Pero a veces, entre los materiales de estudio, aparece el informe completo del médico: la respuesta entera. Entonces la red neuronal lo memoriza, y la precisión en el examen se dispara al 98%.
Un niño que explora un apartamento desconocido gatea de un objeto a otro y recuerda lo que se ve desde cada rincón. Así, el cerebro construye un mapa mental: un modelo interno del espacio. El algoritmo gradCSCG funciona con el mismo principio: recibe un flujo de video de una cámara y dibuja de forma autónoma el esquema de la habitación, basándose únicamente en el cambio de las imágenes.
Los audífonos tradicionales se parecen a un cocinero que sigue una receta a ciegas. Analizan el desorden sonoro del micrófono y, basándose en él, amplifican el habla. En una cafetería ruidosa, este enfoque a menudo falla. El nuevo sistema se comporta como un chef experimentado: primero procesa la señal y luego prueba el resultado.
Una persona en un bote gira desplazando el peso de su cuerpo. El mismo truco emplea el barco no tripulado: el giro lo realiza una carga móvil dentro del casco. Una red neuronal controla su movimiento, anticipando el caos de las olas y las ráfagas de viento.
Las estrellas de neutrones son los últimos grumos de materia visible antes de caer en un agujero negro. En sus entrañas, la materia se comprime hasta densidades de billones de veces. Aquí, las fuerzas nucleares y la gravedad se entrelazan en una sustancia exótica, inaccesible para cualquier acelerador terrestre.
Los sistemas energéticos con paneles solares y aerogeneradores se asemejan a una partida de ajedrez: la nubosidad y los cambios de carga son movimientos del oponente imposibles de prever. Para mantener el equilibrio, los operadores antes repasaban decenas de escenarios (incertidumbre), lo que requería demasiado tiempo y cálculo.
Un conductor en una carretera resbaladiza no sabe exactamente cómo reaccionará el coche al volante, y aprende sobre la marcha, dejando margen para el error. De manera similar se comporta un algoritmo de control inteligente.
Tradicionalmente, los algoritmos de aprendizaje automático operan en un entorno estático, como agua que fluye por un cauce ya trazado sin cambiar su forma. El nuevo método invierte este paradigma: permite que el agente aprenda acciones y, al mismo tiempo, modifique el entorno en el que existe.
En una habitación ruidosa, una persona distingue la voz deseada gracias a los dos oídos, que captan la diferencia en la llegada del sonido. Una computadora con varios micrófonos actúa de la misma manera: recibe pistas espaciales, de dónde habla cada uno.
Antes, estas pistas se usaban para enfocarse en una sola dirección, como el haz de una linterna.
Un cocinero que aprende a cocinar con dibujos corre el riesgo de arruinar cada plato. La misma trampa le espera a la visión por computadora: los modelos necesitan miles de imágenes etiquetadas, pero recopilarlas manualmente es costoso y tedioso. Las imágenes sintéticas resuelven el problema, solo si se ven realistas.